Secuenciación de la variación genética humana a partir de muestras de líneas celulares con ADN genómico de 15 kb mediante SQK-LSK114 (HVSC_9231_v114_revA_24Oct2025)


PromethION: Protocol
Secuenciación de la variación genética humana a partir de muestras de líneas celulares con ADN genómico de 15 kb mediante SQK-LSK114 V HVSC_9231_v114_revA_24Oct2025
Este protocolo:
- Utiliza ADN genómico extraído de líneas celulares humanas, cuya longitud N50 es de 15 kb.
- Tiempo de preparación de la muestra: ~240 minutos; tiempo de preparación de la biblioteca: ~90 minutos
- Análisis de datos: 1-2 horas
- Sin PCR
- Compatible con celdas de flujo R10.4.1
De uso exclusivo en investigación
FOR RESEARCH USE ONLY.
Contents
Introducción al protocolo
Preparación de muestras
- 3. Extracción de ADN de líneas celulares humanas con el kit Puregene Cell de QIAGEN
- 4. Fragmentación de ADNg
Preparación de la biblioteca
- 5. Reparación del ADN y preparación de los extremos
- 6. Ligación de los adaptadores y purificación
- 7. Acondicionamiento y carga de celdas de flujo PromethION
- 8. Lavar y volver a cargar celdas de flujo PromethION
Secuenciación y análisis de datos
- 9. Adquisición de datos e identificación de bases
- 10. Análisis de datos
- 11. Reutilización y devolución de celdas de flujo
Resolución de problemas
Descripción general
Este protocolo:
- Utiliza ADN genómico extraído de líneas celulares humanas, cuya longitud N50 es de 15 kb.
- Tiempo de preparación de la muestra: ~240 minutos; tiempo de preparación de la biblioteca: ~90 minutos
- Análisis de datos: 1-2 horas
- Sin PCR
- Compatible con celdas de flujo R10.4.1
De uso exclusivo en investigación
1. Descripción general
Introducción al protocolo secuenciación de la variación genética humana a partir de muestras de líneas celulares con ADN genómico de 15 kb mediante SQK-LSK114
Este protocolo describe un método completo de preparación y secuenciación de ADNg a partir de muestras de cultivos celulares, así como de análisis en EPI2ME con el flujo de trabajo "Human variation". La identificación de variantes estructurales (VS) y variantes de un solo nucleótido (SNV) desempeña un papel fundamental en nuestra comprensión de la diversidad genética, los mecanismos de la enfermedad y la biología evolutiva. El protocolo tiene como objetivo producir bibliotecas con un N50 de lectura de ~15 kb y alcanzar una cobertura del genoma de ~30-40×, lo que proporciona una identificación fiable de variantes pequeñas y grandes, además de información sobre metilación y la fase de las variantes.
A grandes rasgos, el ADN genómico se extrae de 5 millones de cultivos celulares con el kit Puregene Cell de QIAGEN. A continuación, se selecciona su tamaño con el kit Short Fragment Eliminator (EXP-SFE001) y se fragmenta con Megaruptor® 3† (Diagenode). Las bibliotecas se preparan con el kit Ligation Sequencing V14 (SQK-LSK114).
Se secuencian en PromethION; asimismo, se incluyen instrucciones de lavado y recarga de las celdas de flujo, que se realizan dos veces, lo que aumenta al máximo la producción de datos. En este paso se utilizan el kit Flow Cell Wash (EXP-WSH004) y el material complementario Sequencing Auxiliary Vials V14 (EXP-AUX003). MinKNOW identifica las bases y alinea los datos; los datos de salida en formato BAM se analizan con el flujo de trabajo wf-human-variation, que utiliza los programas Sniffles2, Clair3 y modbam2bed en la identificación de variantes estructurales (SV), polimorfismos de un solo nucleótido (SNP) y la detección de metilación de ADN.
†Nota: Si no se tiene acceso a Megaruptor y se omite este paso, es probable que se observe una disminución de la cobertura de ~40× a ~30×.
Pasos del proceso de secuenciación:
Preparación del experimento
Pasos:
- Extraer la muestra de partida (células).
- Tener a disposición el kit de secuenciación, el instrumental pertinente y los reactivos de otros fabricantes.
- Descargar el programa que obtendrá y analizará los datos.
- Verificar la celda de flujo y comprobar que tiene poros suficientes para realizar una buena secuenciación.
Preparación de la muestra
Mediante el método de extracción detallado, extraer el ADNg de las células y fragmentarlo con el Megaruptor.
Comprobar la longitud, cantidad y pureza del material extraído. Los controles de calidad realizados durante el protocolo son esenciales a la hora de garantizar el éxito del experimento.
Preparación de la biblioteca
La tabla siguiente resume los pasos necesarios de la preparación de la biblioteca, así como su duración y las paradas opcionales.
| Preparación de la biblioteca | Proceso | Duración | Paradas opcionales |
|---|---|---|---|
| Reparación del ADN y preparación de los extremos | Reparar y acondicionar los extremos de ADN con vistas a la ligación de adaptadores | 35 minutos | 4 °C hasta el día siguiente |
| Ligación de adaptadores y purificación | Ligar los adaptadores a los extremos de ADN | 55 minutos | a 4 °C (almacenamientos a corto plazo o reutilización, como las recargas de celdas de flujo) a –80 °C (un solo uso o almacenamiento a largo plazo). Recomendamos secuenciar la biblioteca tan pronto como se liguen los adaptadores. |
| Acondicionar y cargar la celda de flujo | Acondicionar la celda de flujo y cargar la biblioteca | 10 minutos | |
| Lavar y volver a cargar las celdas de flujo | Detener la secuenciación. Lavar la celda de flujo con nucleasa a fin de eliminar restos de la biblioteca anterior y desbloquear los poros. Acondicionar la celda de flujo, volver a cargar la biblioteca y reanudar la secuenciación | 60 minutos |
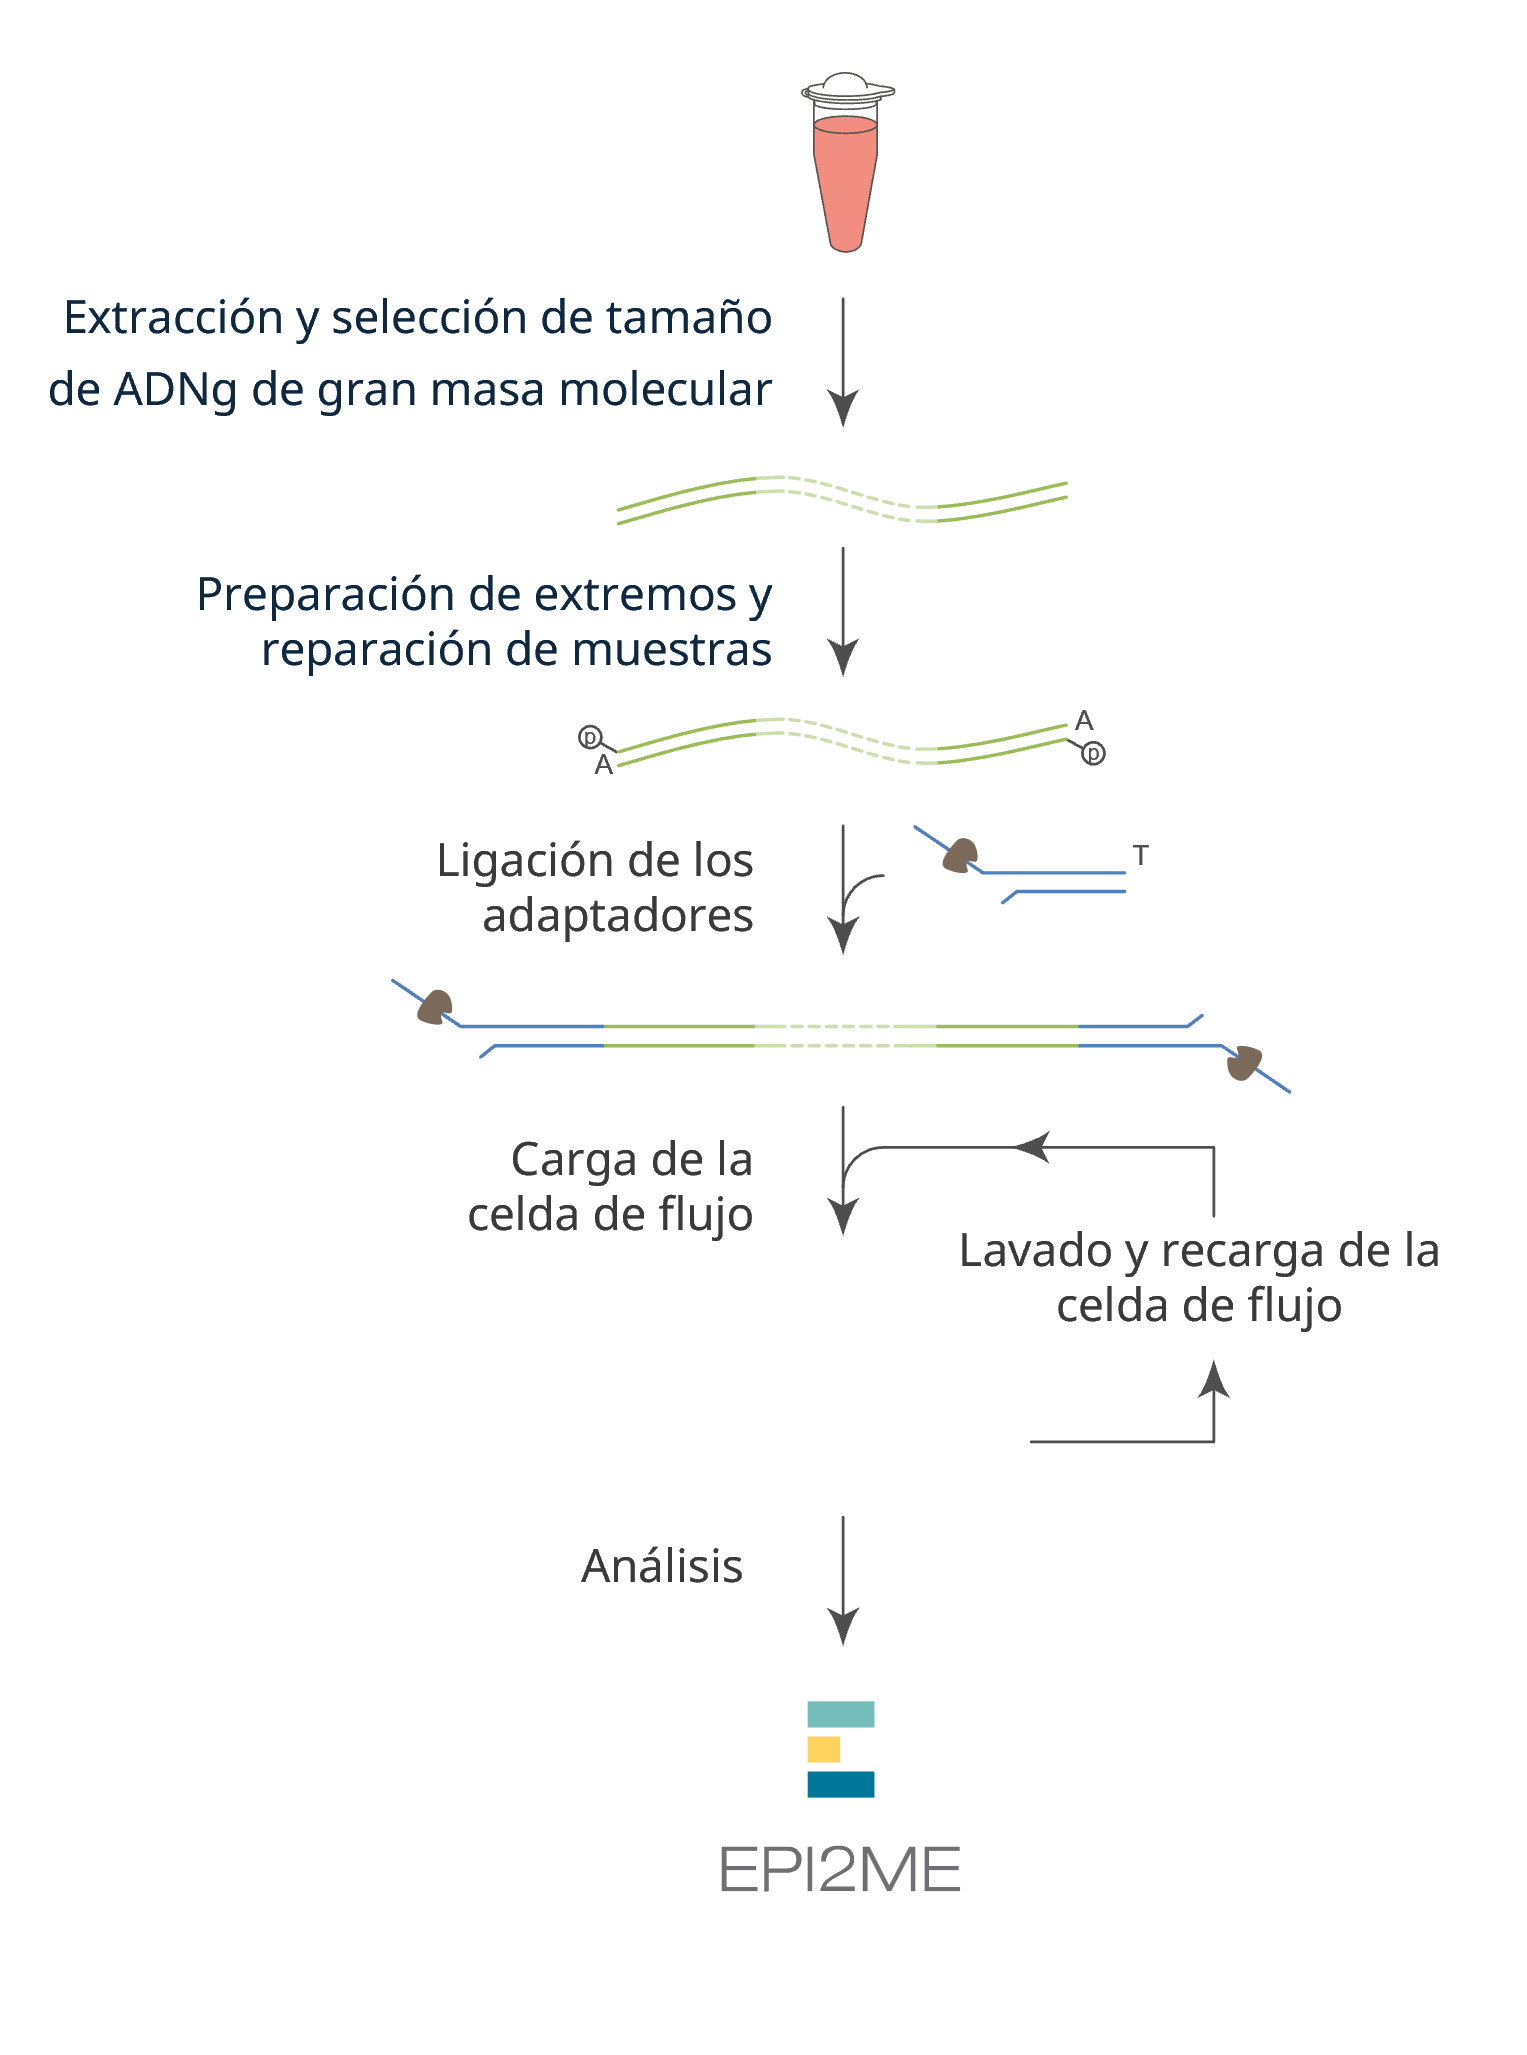
Secuenciación y análisis
Pasos:
- Empezar el experimento de secuenciación con el programa MinKNOW, que recopilará los datos sin procesar del dispositivo y los convertirá en lecturas identificadas.
- Analizar los datos con el flujo de trabajo wf-human-variation.
Compatibilidad del protocolo
Este protocolo debe utilizarse solo junto con los siguientes productos:
- Kit Ligation Sequencing V14 (SQK-LSK114)
- Celdas de flujo PromethION R10.4.1 (FLO-PRO114M)
- Short Fragment Eliminator Expansion (EXP-SFE001)
- Kit Flow Cell Wash (EXP-WSH004)
- Sequencing Auxiliary Vials V14 (EXP-AUX003)
- Dispositivo PromethION 24/48 - PromethION 24/48 Serie A - Ficha técnica y requisitos informáticos
- Dispositivo PromethION 2 Solo - PromethION 2 Solo - Ficha técnica y requisitos informáticos
2. Material y consumibles
Material
- (EXTRACCIÓN) 5 x 10⁶ de células (p. ej., cultivos celulares o muestras de tejido)
- (FOR LIBRARY PREPARATION) 3 µg of SFE size selected and Megaruptor fragmented gDNA
- Kit Short Fragment Eliminator (EXP-SFE001)
- Kit Ligation Sequencing V14 (SQK-LSK114)
- Kit Flow Cell Wash (EXP-WSH004)
- Material complementario Sequencing Auxiliary Vials V14 (EXP-AUX003)
Consumibles
- Celdas de flujo PromethION
- NEBNext® Companion Module v2 para Oxford Nanopore Technologies® Ligation Sequencing (NEB, E7672S o E7672L)
- Kit Puregene Cell (QIAGEN, 158043)
- Kit de fragmentación Megaruptor 3 (Diagenode, E07010003)
- Agua sin nucleasas (p. ej., ThermoFisher, AM9937)
- Tubos Falcon de 15 ml
- Tubos Eppendorf DNA LoBind de 2 ml
- Tubos Eppendorf DNA LoBind de 1,5 ml
- Tubos de PCR de pared fina, 0,2 ml
- Etanol al 80 % recién preparado con agua sin nucleasas
- Solución salina amortiguada con fosfato (PBS), pH 7,4 (ThermoFisher, 10010023)
- Isopropanol al 100 % (Fisher Scientific, 10723124)
- Amortiguador TE (10 mM Tris-HCl, 1 mM EDTA, pH 8,0) (Fisher Scientific, 10224683)
- Asa de siembra o pinzas desechables
- Tubos de ensayo Qubit™ (Invitrogen, Q32856)
- Kit Qubit dsDNA BR (Invitrogen, Q32850)
- Kit Qubit dsDNA HS (Invitrogen Q32851)
- Kit Agilent Genomic DNA 165 kb Analysis (Agilent, FP-1002-0275)
Instrumental
- Dispositivo PromethION
- Pantalla protectora celdas de flujo PromethION
- Hula mixer (mezclador de rotación suave)
- Gradilla magnética, apta para tubos Eppendorf de 1,5 ml
- Microcentrífuga
- Mezclador vórtex
- Termociclador
- Centrífuga y rotor adecuados para tubos Falcon de 15 ml
- Incubador o baño termostático ajustado a 37 °C y a 50 °C
- Megaruptor 3 (Diagenode, B06010003)
- Puntas de pipeta de punta ancha
- Pipeta y puntas P1000
- Pipeta y puntas P200
- Pipeta y puntas P100
- Pipeta y puntas P20
- Pipeta y puntas P10
- Pipeta y puntas P2
- Cubeta con hielo
- Temporizador
- Bloque térmico
- Cubeta con hielo
- Sistema Agilent Femto Pulse (o equivalente)
- Fluorímetro Qubit™ (o equivalente)
Equipo opcional
- Bloque térmico con agitación
La lista anterior de material, consumibles y equipo corresponde tanto al método de extracción descrito en la sección Preparación de la muestra como a la sección Preparación de la biblioteca. Si cuenta con las muestras ya extraídas, solo necesitará el material correspondiente a la sección Preparación de la biblioteca.
En la preparación de la biblioteca, se necesitan 3 μg de ADN genómico con un N50 de 15 kb.
En este flujo de trabajo completo, en la fase de preparación de muestras, recomendamos extraer ADNg de gran peso molecular de 5×10⁶ de células (por ejemplo, de cultivo celular o muestra de tejido) con el kit Puregene Cell de QIAGEN.
Hay otros protocolos de extracción disponibles, pero Oxford Nanopore no los ha probado.
Durante las preparaciones de la muestra y la biblioteca, recomendamos usar puntas de pipeta de boca ancha, a fin de evitar la fragmentación mecánica de la muestra.
Aunque mezclar despacio y con suavidad ayuda a preservar los fragmentos de ADN más largos, también es importante mezclar los reactivos y el ADN a fondo, ya que, si no se mezclan lo suficiente, disminuirán la longitud de lectura y el rendimiento.
ADN de partida
Cómo realizar el control de calidad del ADN de partida
Es importante que el ADN cumpla con los requisitos de cantidad y calidad. Usar demasiado ADN, poco o de mala calidad (p. ej., que esté muy fragmentado, que contenga ARN o contaminantes químicos), afecta a la preparación de la biblioteca.
En el protocolo Input DNA/ RNA QC encontrará las instrucciones necesarias.
Contaminantes químicos
Según cómo se extraiga el ADN de la muestra original, ciertos contaminantes químicos quedan en el ADN purificado y afectan tanto a la eficacia de la preparación de la biblioteca como a la calidad de la secuenciación. Hay más información sobre contaminantes en la página Contaminants de la comunidad Nanopore.
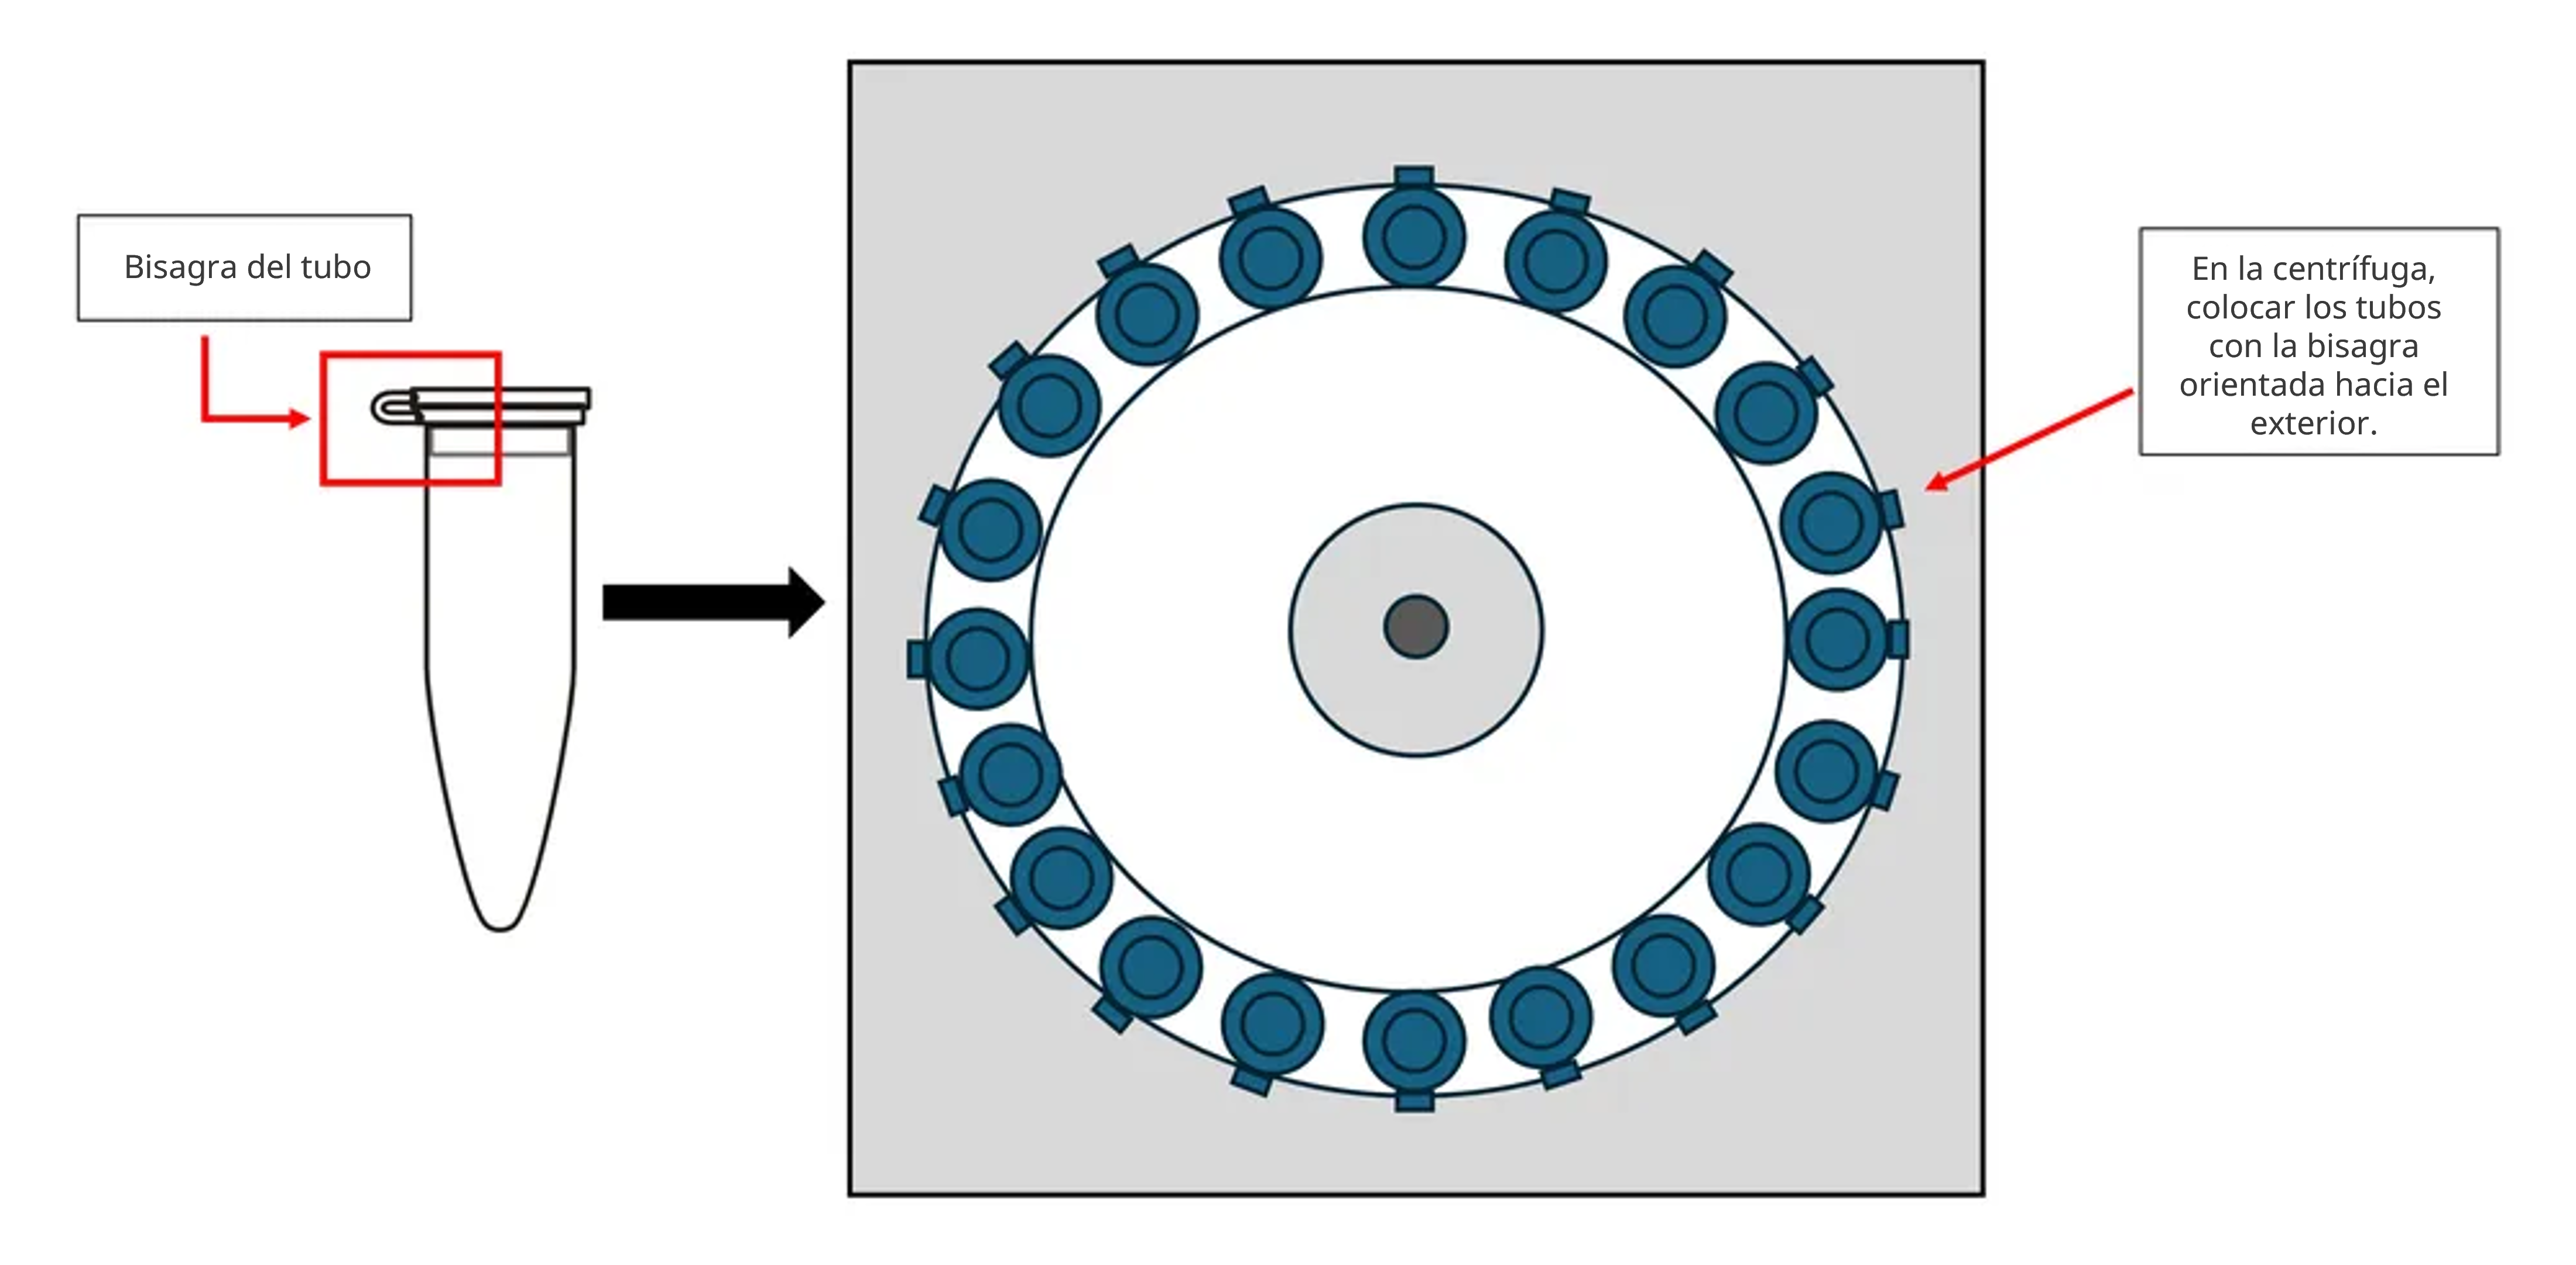
Orientación del tubo Eppendorf en la centrífuga
En todos los pasos de centrifugación, cargar los tubos con la bisagra orientada hacia afuera ayudará en la identificación visual del sedimento.
Manipular los tubos con cuidado al retirarlos de la centrífuga a fin de evitar desestabilizar el sedimento.
Recomendamos utilizar el módulo Companion Module v2 de NEBNext® de secuenciación por ligación de Oxford Nanopore Technologies® (NEB, E7672S o E7672L), que incluye todos los reactivos NEB necesarios junto con el kit Ligation Sequencing.
La versión anterior, el módulo Companion Module de NEBNext® de secuenciación por ligación de Oxford Nanopore Technologies® (NEB, E7180S o E7180L) también es compatible, pero el módulo v2 recomendado ofrece una adición de adenina en el extremo 3' y una ligación más eficientes.
Reactivos de otros fabricantes
Hemos probado y recomendamos el uso de todos los reactivos de otros fabricantes usados en este protocolo. Oxford Nanopore Technologies no ha evaluado otras alternativas.
Preparar los reactivos de otros fabricantes siguiendo las instrucciones del fabricante.
Comprobación de la celda de flujo
Antes de empezar el experimento de secuenciación, recomendamos comprobar el número de poros disponibles presentes en la celda de flujo, en un plazo de 12 semanas desde la compra de las celdas de flujo PromethION. Oxford Nanopore Technologies sustituirá cualquier celda de flujo con un número de poros inferior al indicado en la tabla siguiente, siempre y cuando el resultado se notifique dentro de los dos días siguientes a la comprobación y se hayan seguido las instrucciones de almacenamiento. Las instrucciones de comprobación de celdas de flujo se encuentran en el documento Flow Cell Check.
| Celdas de flujo | Cantidad mínima de poros activos cubierta por la garantía |
|---|---|
| PromethION | 5 000 |
Recomendamos utilizar el amortiguador Ligation Buffer (LNB) incluido en el kit Ligation Sequencing V14, en lugar de amortiguadores de ligasa de otros fabricantes, lo que garantiza un rendimiento elevado del adaptador, Ligation Adapter (LA).
El adaptador incluido en este kit, Ligation Adapter (LA), no es intercambiable con otros adaptadores de secuenciación.
Contenido del kit Ligation Sequencing V14 (SQK-LSK114)
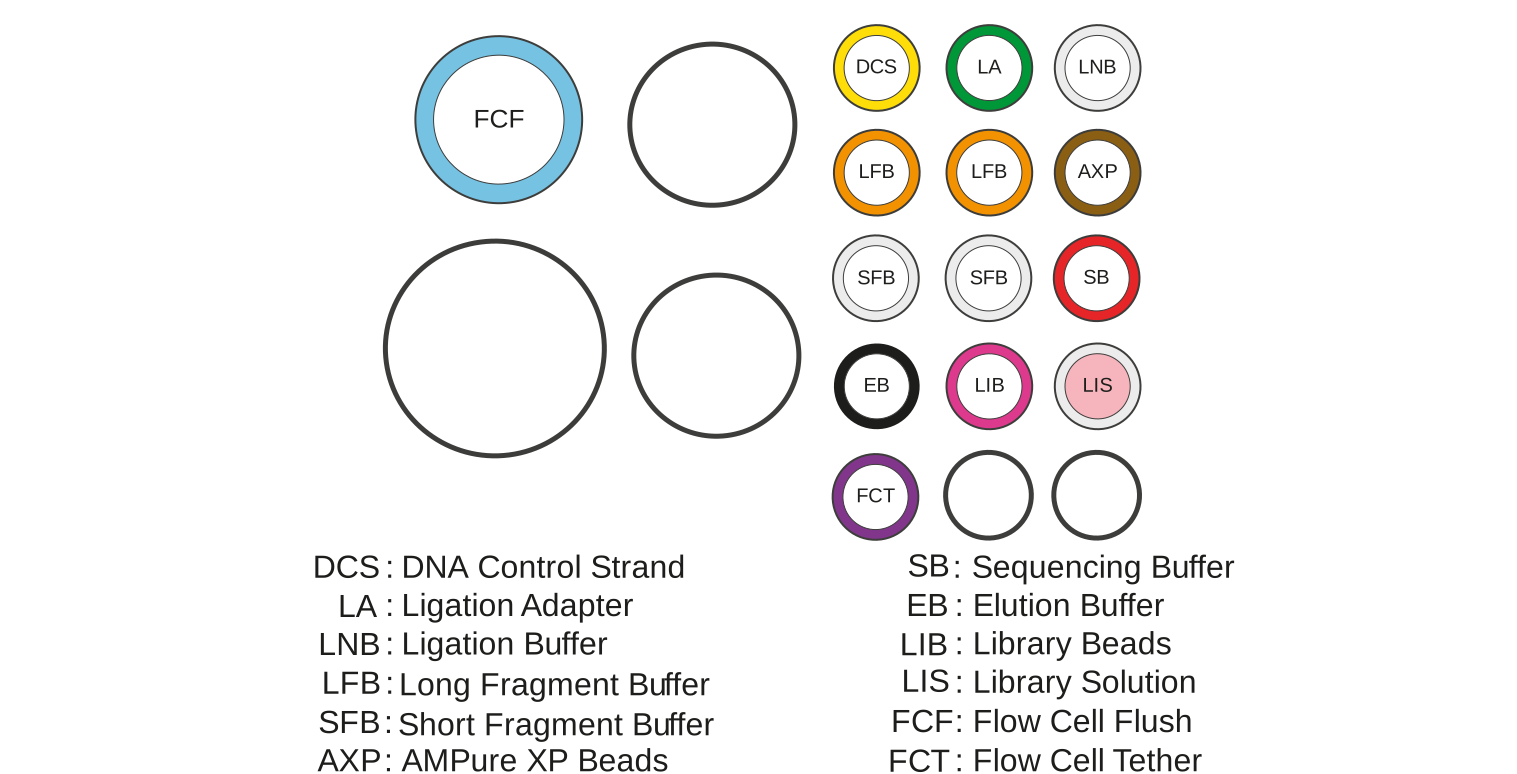
Nota: este producto contiene un reactivo, AMPure XP, fabricado por Beckman Coulter Inc., y se guarda junto con el kit, a –20 °C, sin perjudicar su estabilidad.
Nota: el reactivo DNA Control Sample (DCS) es un amplicón estándar de 3,6 kb que se alinea con el extremo 3’ del genoma Lambda.
3. Extracción de ADN de líneas celulares humanas con el kit Puregene Cell de QIAGEN
Material
- 5x10⁶ de células (p.ej., de cultivos celulares o muestras de tejido)
Consumibles
- Kit Puregene Cell (QIAGEN, 158043)
- Etanol al 80 % recién preparado y frío en agua sin nucleasas
- Amortiguador TE (10 mM Tris-HCl, 1 mM EDTA, pH 8,0) (Fisher Scientific, 10224683)
- Solución salina amortiguada con fosfato (PBS), pH 7,4 (ThermoFisher, 10010023)
- Isopropanol al 100 % (Fisher Scientific, 10723124)
- Tubos Falcon de 15 ml
- Tubos Eppendorf DNA LoBind de 2 ml
- Tubos Eppendorf DNA LoBind de 1,5 ml
- Asa de siembra o pinzas desechables
- Kit Qubit dsDNA BR (Invitrogen, Q32850)
- Tubos de ensayo Qubit™ (Invitrogen, Q32856)
Instrumental
- Incubador o baño termostático ajustado a 37 °C y a 50 °C
- Centrífuga y rotor adecuados para tubos Falcon de 15 ml
- Mezclador vórtex
- Puntas de pipeta de punta ancha
- Pipeta y puntas P1000
- Pipeta y puntas P200
- Cubeta con hielo
- Fluorímetro Qubit™ (o equivalente)
A fin de evitar la fragmentación mecánica del ADN, recomendamos usar pipetas con puntas de boca ancha durante la preparación de la muestra y de la biblioteca.
Aunque mezclar despacio y con suavidad ayuda a preservar los fragmentos de ADN más largos, también es importante mezclar los reactivos y el ADN a fondo, ya que, si no se mezclan lo suficiente, disminuirán la longitud de lectura y el rendimiento.
Preparar un tubo Eppendorf DNA LoBind de 1,5 ml con aproximadamente 1 ml de etanol al 80 % y guardar en hielo.
En un tubo de centrifugación de 15 ml, recoger y sedimentar 5×10⁶ de células por centrifugación a 300 x g (RCF) durante 3 minutos. Si queda líquido junto al sedimento, centrifugar las células de nuevo, aspirar y desechar el resto del sobrenadante.
Nota: el número de celdas necesario varía según el tipo de muestra.
Añadir 200 µl de PBS 1× a las células sedimentadas.
Centrifugar a 300 × g durante 3 minutos.
Sin tocar el sedimento, aspirar y desechar el sobrenadante.
Añadir 200 µl de PBS 1× a las células sedimentadas y resuspender suavemente el sedimento mediante ligeros golpecitos o mezclando con una pipeta de boca ancha.
El sedimento debe estar completamente disperso, ya que simplifica mucho la lisis celular en el siguiente paso.
Añadir 3 ml de Cell Lysis Solution.
Nota: mezclar suavemente con la pipeta entre 10 y 15 veces a fin de lisar las células y homogeneizar la solución hasta eliminar los grumos. Comprobar que esté bien mezclada.
Incubar la muestra a 37 °C durante 30 minutos.
Nota: al final de la incubación, comprobar que la solución esté homogeneizada y que no queden grumos.
Si es necesario, mezclar la reacción con una pipeta de boca ancha o invertir suavemente el tubo, facilita la homogeneización.
Añadir 5 µl de solución de RNasa A a la muestra e invertir el tubo 20 veces.
A continuación, incubar durante 15 minutos a 37 °C, poner el tubo en hielo e incubar durante 3 minutos más hasta que la muestra se enfríe.
Añadir 1000 μl de Protein Precipitation Solution a las células lisadas y mezclar en vórtex durante 2 ciclos de 5 segundos a velocidad máxima.
Centrifugar la muestra a 2 000 × g durante 10 minutos.
La proteína precipitada debe formar un sedimento compacto de color blanco.
Si no está bien cohesionado, incubar en hielo durante 5 minutos y repetir la centrifugación.
Añadir 3 ml de isopropanol a un tubo Falcon de 15 ml.
Verter con cuidado el sobrenadante, sin desplazar el sedimento, en el tubo Falcon de 15 ml que contiene isopropanol.
Procure que el sedimento no se desprenda durante el vertido.
Otra posibilidad es transferir el sobrenadante con la pipeta, procurando que el sedimento proteico permanezca intacto y no se altere durante la transferencia.
Nota: si en algún momento el sedimento proteico se desplaza, repetir la centrifugación a 2000 × g durante 10 minutos. Transferir solo el sobrenadante transparente a fin de evitar la contaminación por proteínas en el eluido resultante.
Mezclar con cuidado invirtiendo los tubos 50 veces, hasta que el ADN se vea en forma de hilos o un grumo.
Centrifugar el tubo Falcon durante 3 minutos a 2000 × g.
El ADN aparecerá en forma de pequeño sedimento blanco en el fondo del tubo.
Desechar el sobrenadante con cuidado y vaciar el tubo invirtiéndolo sobre un trozo de papel absorbente. Procure que el sedimento de ADN permanezca en el tubo y sin alterar.
Nota: extraer el sobrenadante con la pipeta o verter el volumen sobre un material absorbente.
Tenga cuidado ya que el sedimento tal vez esté suelto y se desprenda con facilidad.
Añadir 300 µl de etanol al 80 % recién preparado y enfriado en hielo al tubo de la muestra. Lavar el sedimento de ADN invirtiendo el tubo con cuidado varias veces.
Transferir el sedimento y el volumen entero de 300 µl de etanol a un tubo Eppendorf de 1,5 ml.
Centrifugar el tubo de la muestra durante 1 minuto a 2000 × g.
Desechar el sobrenadante con cuidado y drenar el tubo invirtiéndolo sobre un trozo de papel absorbente. Procure que el sedimento de ADN permanezca intacto en el tubo.
Nota: extraer el sobrenadante con la pipeta o verter el volumen sobre un material absorbente.
Tenga cuidado ya que el sedimento tal vez esté suelto y se desprenda con facilidad.
Destapar el tubo y dejar secar el sedimento durante 1 minuto.
Nota: evitar secarlo en exceso y no dejar que se agriete.
Añadir 200 μl de amortiguador TE (10 mM Tris-HCl, 1 mM de EDTA, pH de 8.0) al tubo que contiene el sedimento de muestra. Resuspender el sedimento con cuidado dando ligeros golpecitos con el dedo.
Incubar el tubo durante 2 horas a 50 °C, mezclando de vez en cuando el contenido (200 μl) con una pipeta de boca ancha.
Nota: el sedimento de ADN tal vez tarde un poco en solubilizarse. Comprobar que la solución esté bien homogeneizada antes de cuantificarla.
Opcional: otra posibilidad es realizar la incubación a temperatura ambiente durante la noche.
Cuantificar la muestra tres veces con el kit Qubit dsDNA BR Assay. Comprobar que las lecturas duplicadas de Qubit sean coherentes antes de pasar al siguiente paso.
Nota: tras la extracción a partir de 5 x 10⁶ de cultivos celulares, se espera obtener de 20 a 35 µg de ADNg aproximadamente.
Se prevén valores de entre 200 y 350 ng/μl en las lecturas de Qubit.
Si los resultados no son coherentes, es posible que el ADN no se haya resuspendido de manera homogénea.
Si se da el caso, recomendamos aumentar el tiempo de incubación y dar tiempo a que el sedimento de ADN se solubilice.
Nota: incubar a 50 °C en un agitador térmico a 300 rpm facilita la elución. Otra alternativa es utilizar un agitador rotatorio de volteo.
Es posible analizar el ADNg extraído también con Femto Pulse (Agilent), que analiza su tamaño y calidad.
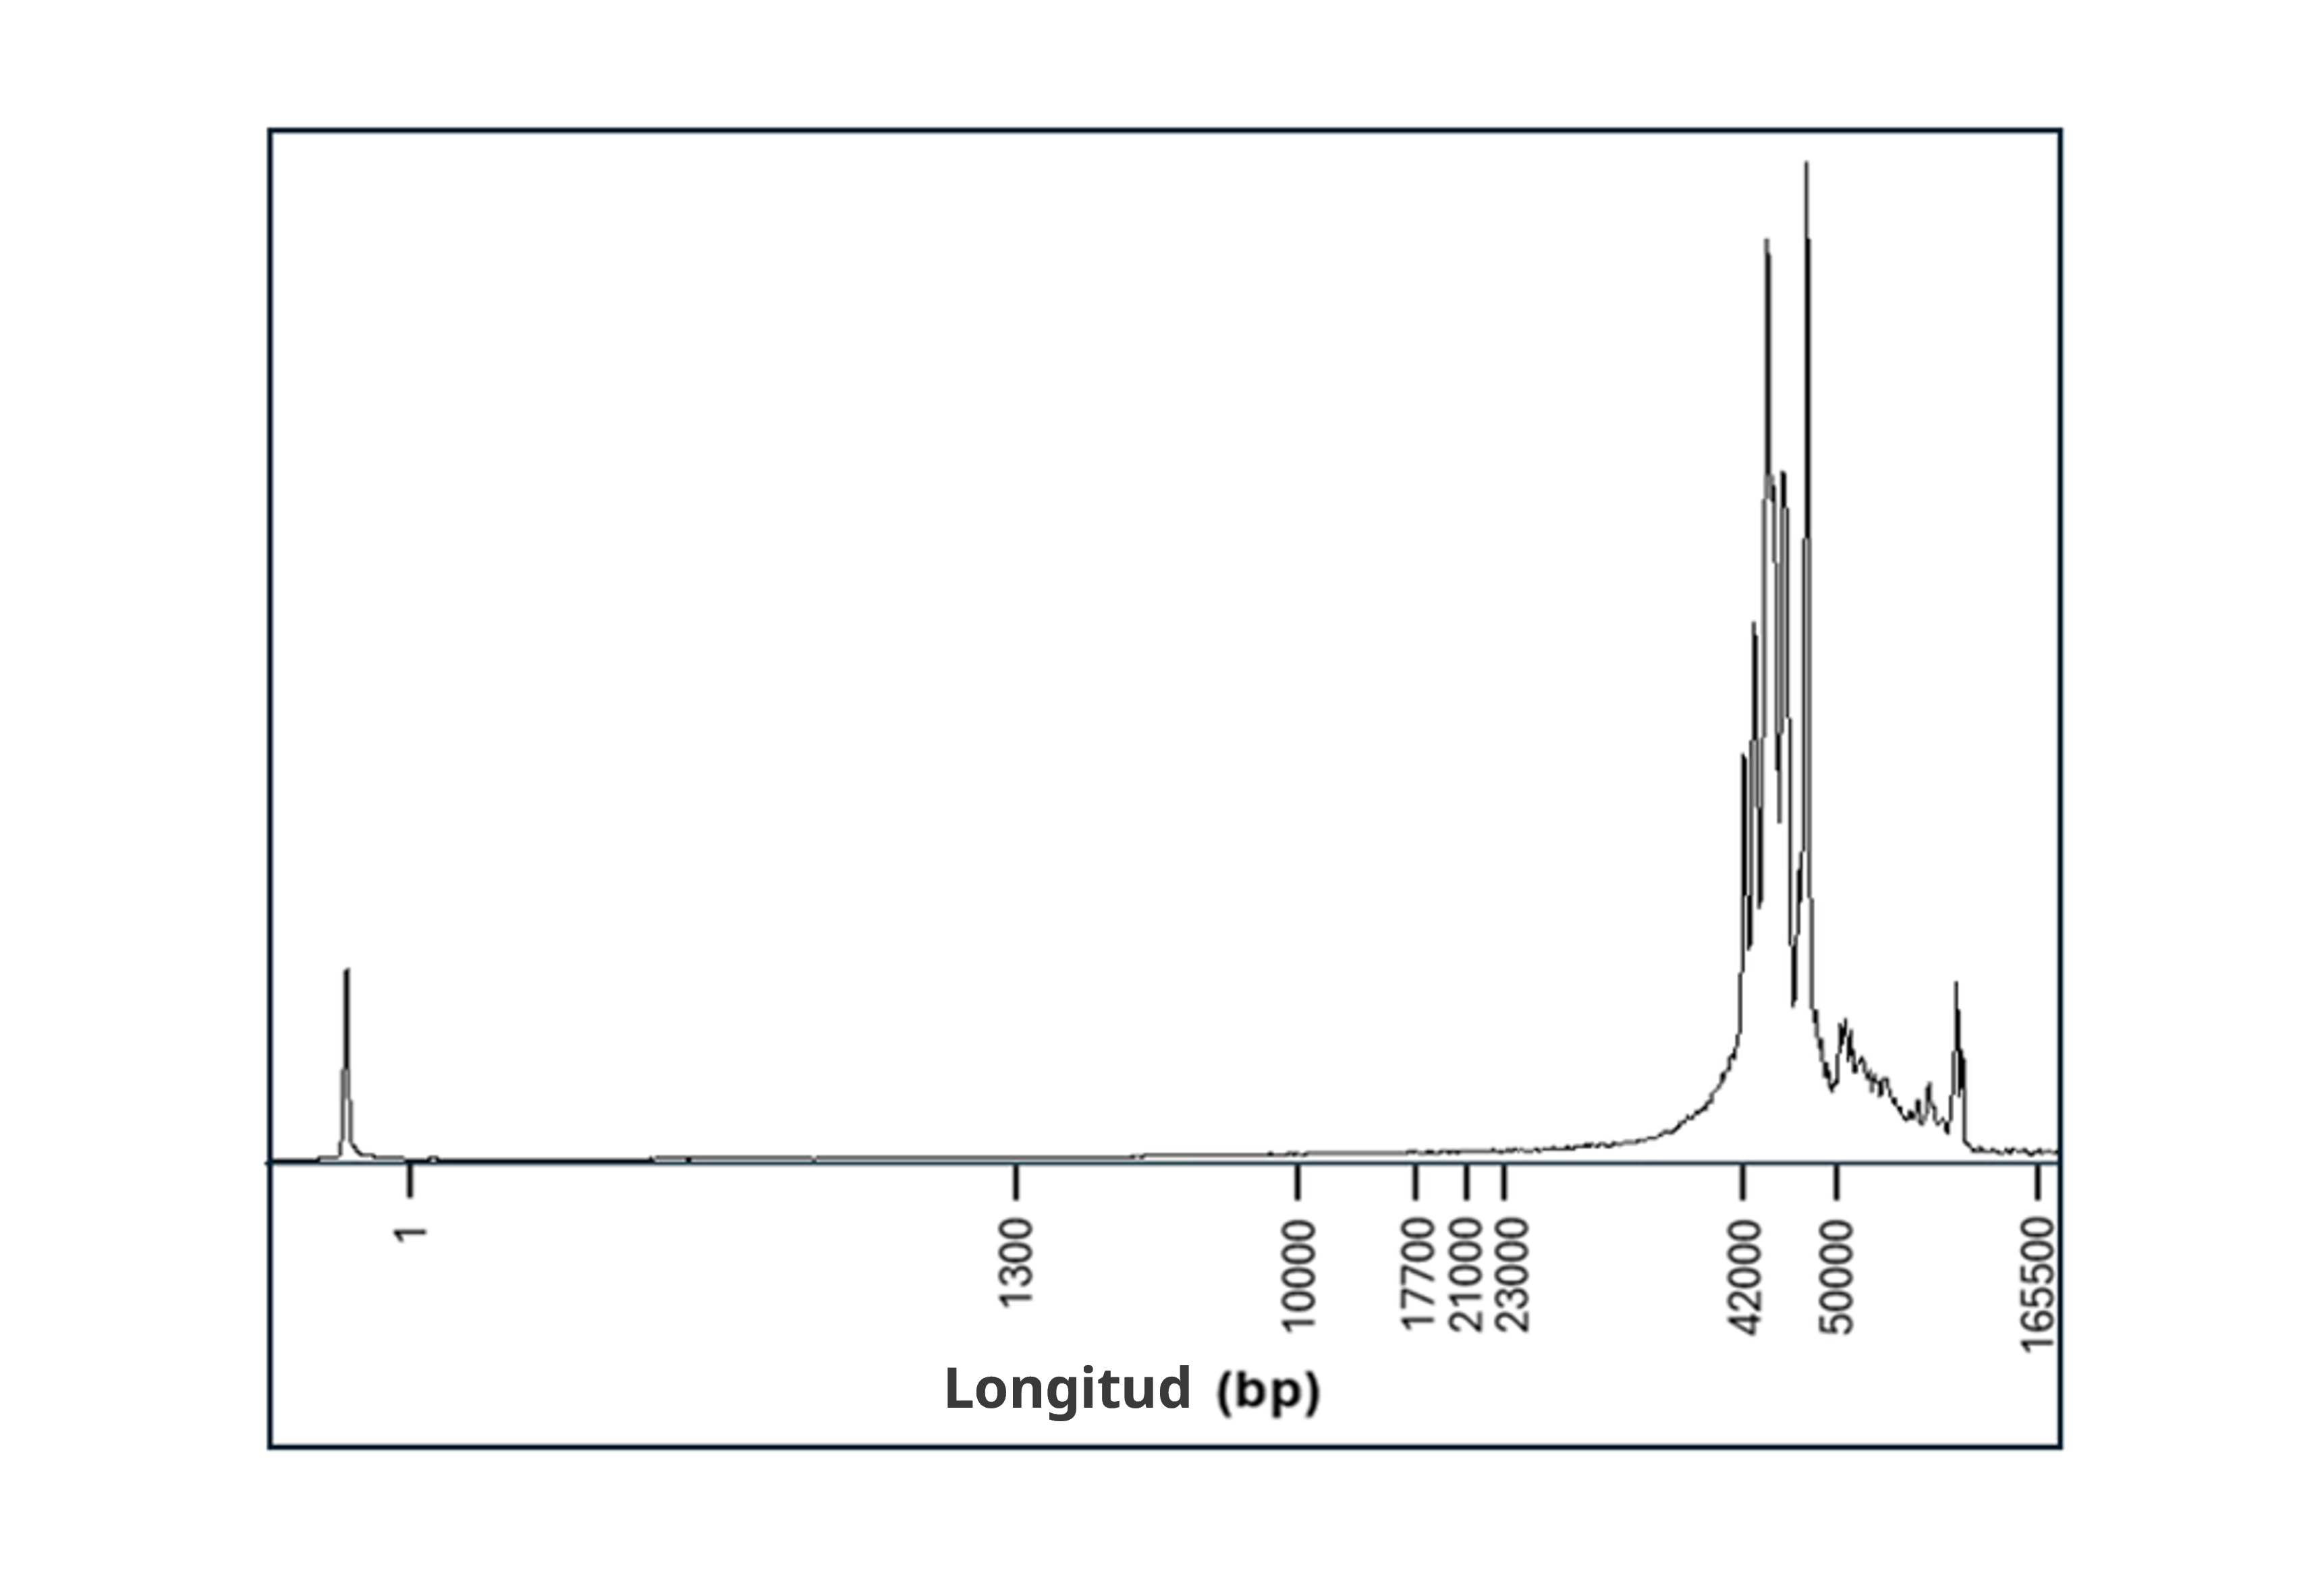
Perfil de longitud de fragmentos de ADNg extraído de células con el kit Puregene Cell.
Proseguir con la selección de tamaños de ADNg de este protocolo. Otra alternativa es guardar la muestra a 4 °C durante la noche.
4. Fragmentación de ADNg
Material
- 2 µg de ADNg (extraído en la sección anterior)
Consumibles
- Kit de fragmentación Megaruptor 3 (Diagenode, E07010003)
- Amortiguador TE (10 mM Tris-HCl, 1 mM EDTA, pH 8,0) (Fisher Scientific, 10224683)
- Kit Agilent Genomic DNA 165 kb Analysis (Agilent, FP-1002-0275)
- Tubos Eppendorf DNA LoBind de 1,5 ml
Instrumental
- Megaruptor 3 (Diagenode, B06010003)
- Microcentrífuga
- Sistema Agilent Femto Pulse (o equivalente)
- Cubeta con hielo
- Temporizador
- Puntas de pipeta de punta ancha
- Pipeta y puntas P1000
- Pipeta y puntas P200
- Pipeta y puntas P20
- Pipeta y puntas P10
- Pipeta y puntas P2
Preparar el ADN en agua sin nucleasas:
Transferir 2 μg de ADNg extraído a un tubo de fragmentación del Megaruptor 3.
Ajustar el volumen a 90 μl con una solución de Tris 10 mM y EDTA 1mM (pH 8).
Mezclar minuciosamente aspirando y expulsando el líquido con una pipeta de boca ancha.
Centrifugar brevemente en una microcentrífuga.
Transferir el tubo al Megaruptor 3 y comprobar que el instrumento esté correctamente equilibrado de acuerdo con las instrucciones del fabricante.
Nota: enrosque bien las jeringuillas Hydropore antes de insertarlas en el Megaruptor.
Compruebe que la muestra no tenga burbujas y que la jeringuilla esté sumergida hasta los dos tercios del volumen.
Configurar los parámetros de fragmentación en el dispositivo Megaruptor 3 de la siguiente manera:
| Configuración del Megaruptor 3 | |
|---|---|
| Velocidad de fragmentación | 31 |
| Volumen | 90 μl |
| Concentración | 23 ng/μl |
Comenzar a fragmentar el ADN con el Megaruptor 3.
Cuantificar la muestra mediante el kit Qubit dsDNA BR Assay.
Nota: tras la fragmentación, se espera recuperar 2 µg de ADNg aproximadamente.
Se prevén valores de Qubit de 23,33 ng/μl aproximadamente.
Nota: la pérdida de volumen no debe superar los 10 μl.
Evaluar el tamaño de los fragmentos del ADNg fragmentado con Femto Pulse, de Agilent.
La fragmentación con Megaruptor reduce el perfil de longitud de fragmentos a un intervalo de tamaños comprendido entre 3 kb y 40 kb, centrado en torno a 15 kb aproximadamente.
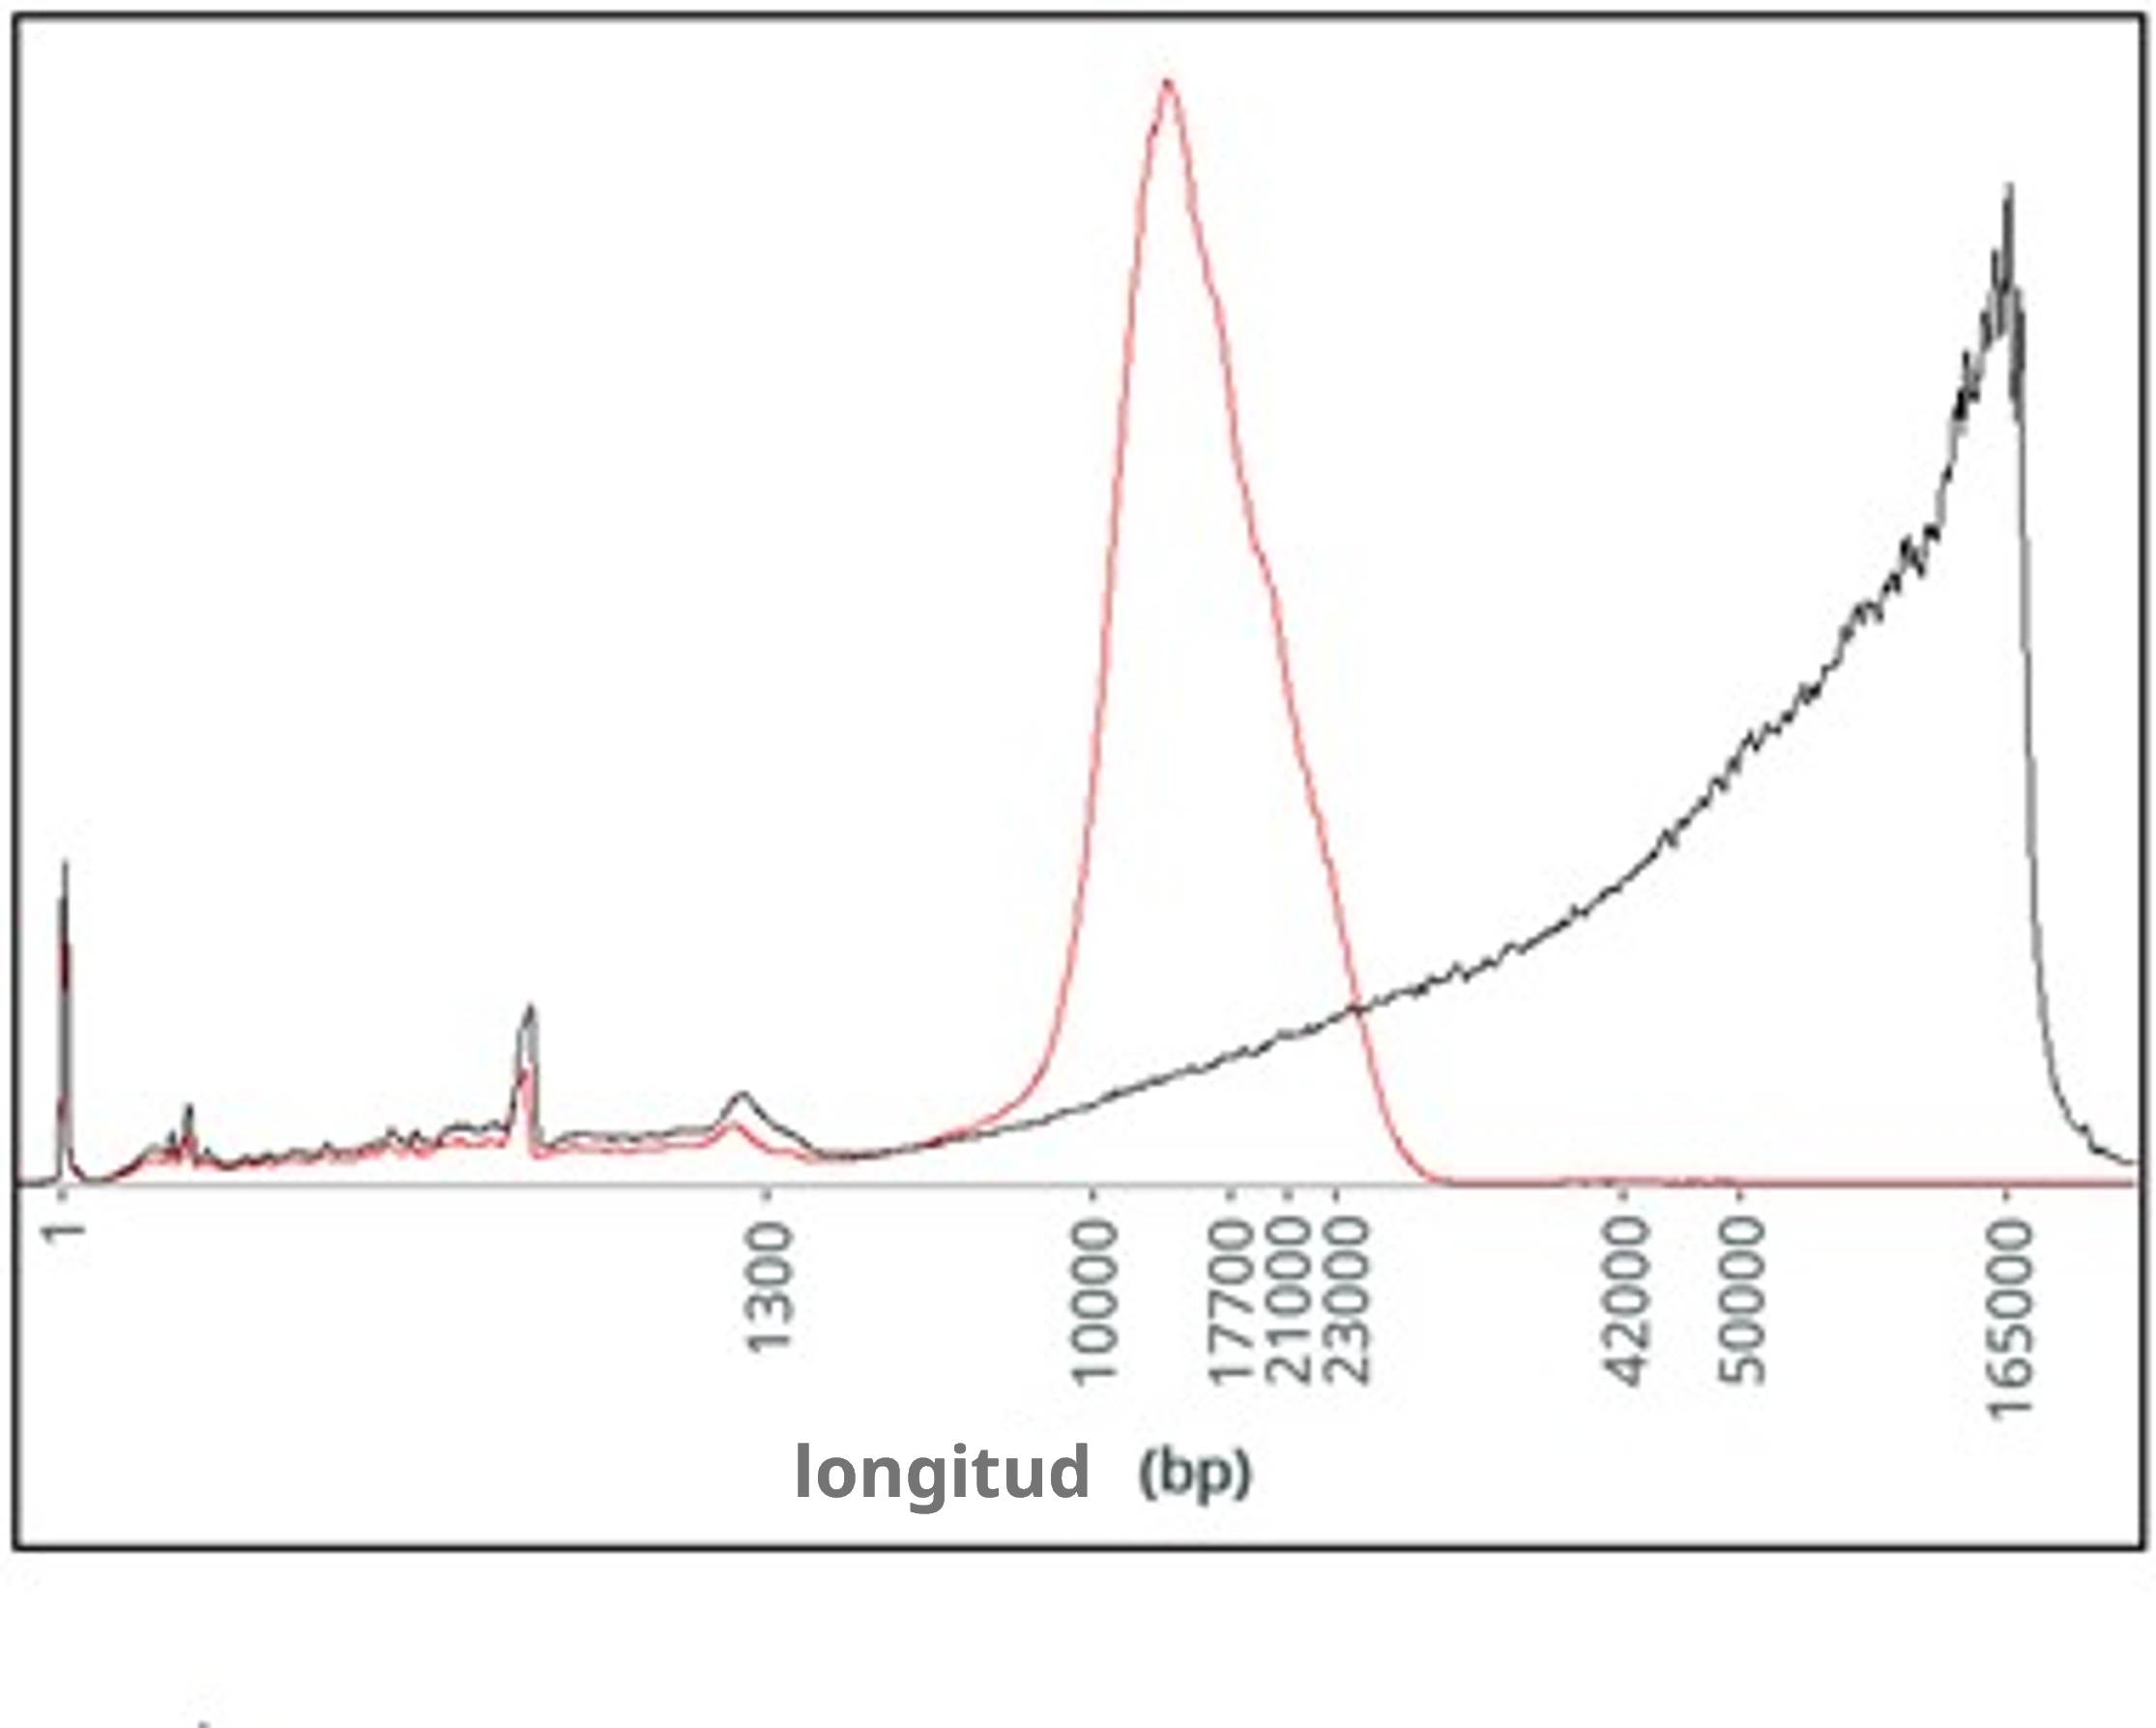
Superposición de perfiles de longitud de fragmentos de a) ADNg extraído con el kit Puregene Cell, b) ADNg extraído y fragmentado con Megaruptor 3 (MR).
Tomar el ADNg fragmentado con Megaruptor y seleccionado por tamaño mediante SFE y proceder a preparar la biblioteca. Otra alternativa es guardar la muestra a 4 °C durante la noche.
5. Reparación del ADN y preparación de los extremos
Material
- 2 µg de ADNg fragmentado con Megaruptor
- Microesferas AMPure XP (AXP)
Consumibles
- NEBNext® FFPE DNA Repair Mix del NEBNext® Companion Module v2 (NEB, E7672S o E7672L)
- NEBNext® FFPE DNA Repair Buffer v2, del Companion Module v2 (NEB, E7672S o E7672L) de NEBNext®
- NEBNext® Ultra II End Prep Enzyme Mix del NEBNext® Companion Module v2 (NEB, E7672S o E7672L)
- Kit Qubit dsDNA HS (Invitrogen Q32851)
- Agua sin nucleasas (p.ej. Thermo Scientific, AM9937)
- Etanol al 80 % recién preparado con agua sin nucleasas
- Tubos de ensayo Qubit™ (Invitrogen, Q32856)
- Tubos de PCR de pared fina, 0,2 ml
- Tubos Eppendorf DNA LoBind de 1,5 ml
Instrumental
- Pipeta y puntas P1000
- Pipeta y puntas P100
- Pipeta y puntas P10
- Microcentrífuga
- Termociclador
- Hula mixer (mezclador de rotación suave)
- Gradilla magnética
- Cubeta con hielo
Equipo opcional
- Fluorímetro Qubit™ (o equivalente)
Comprobación de la celda de flujo.
Recomendamos verificar la celda de flujo antes de empezar a preparar la biblioteca y así comprobar que tenga poros suficientes para realizar una buena secuenciación.
Encontrará más información en el documento Flow cell check.
Preparar los reactivos NEB de acuerdo con las instrucciones del fabricante y colocar en hielo.
A fin de obtener un rendimiento óptimo, NEB recomienda lo siguiente:
Descongelar todos los reactivos en hielo.
Dar suaves golpecitos a los tubos con el índice o invertirlos hasta que estén bien mezclados.
Importante: no mezclar en vórtex las mezclas FFPE DNA Repair Mix o Ultra II End Prep Enzyme Mix.Centrifugar brevemente los tubos antes de abrirlos.
Homogeneizar el amortiguador FFPE DNA Repair Buffer v2 en un vórtex.
Nota: es posible que tenga un precipitado blanco. En tal caso, dejar que la mezcla alcance la temperatura ambiente y pipetear el amortiguador varias veces hasta dispersar el precipitado. Después, mezclar brevemente en vórtex.El amortiguador FFPE DNA Repair Buffer v2 tal vez tenga un matiz amarillo; no importa si está así; es posible utilizarlo.
Preparar el ADN en agua sin nucleasas:
Transferir 2 µg de ADNg fragmentado con Megaruptor, obtenido tras la extracción de la muestra, a un tubo de PCR de pared fina de 0,2 ml.
Ajustar el volumen a un total de 80 μl con agua sin nucleasas.
Mezclar minuciosamente con la pipeta o golpear el tubo suavemente con el índice.
Centrifugar brevemente en la microcentrífuga.
En el tubo de PCR (0,2 ml) que contiene el ADNg, mezclar lo siguiente:
| Reactivo | Volumen |
|---|---|
| ADN del paso anterior | 80 µl |
| NEBNext FFPE DNA Repair Buffer v2 | 11,7 µl |
| NEBNext FFPE DNA Repair Mix | 3,3 µl |
| Ultra II End-prep Enzyme Mix | 5 µl |
| Total | 100 µl |
Mezclar la reacción aspirando y expulsando suavemente el líquido con la pipeta y centrifugar brevemente.
En un termociclador, incubar la reacción a 20 °C durante 5 minutos, a 65 °C durante 5 minutos más y mantener a 4 °C.
Resuspender las microesferas AMPure XP (AXP) mediante vórtex.
Transferir la muestra de ADN a un tubo nuevo Eppendorf DNA LoBind de 1,5 ml.
Añadir 100 µl de microesferas AMPure XP Beads (AXP) resuspendidas a la mezcla de preparación de extremos y mezclar golpeando suavemente el tubo con el dedo.
Incubar en el mezclador Hula (o mezclador rotatorio) durante 5 minutos a temperatura ambiente.
Preparar 600 µl de etanol al 80 % con agua sin nucleasas.
Centrifugar brevemente la muestra y sedimentar en una gradilla magnética durante 10 minutos hasta que el sobrenadante se vuelva claro e incoloro. Sin mover el tubo, extraer el sobrenadante con una pipeta.
Lavar las microesferas con 250 µl de etanol al 80 %, sin desplazar el sedimento. Aspirar el etanol con una pipeta y desechar.
Repetir el paso anterior.
Centrifugar brevemente y colocar el tubo de nuevo en la gradilla magnética. Retirar con una pipeta los restos de etanol. Dejar secar el sedimento durante 30 segundos aproximadamente, sin dejar que se agriete.
Quitar el tubo de la gradilla magnética y resuspender el sedimento en 61 µl de agua sin nucleasas dando suaves golpes al tubo con el dedo. Incubar a temperatura ambiente durante 2 minutos.
Separar las microesferas en una gradilla magnética, durante al menos 1 minuto, hasta que el eluido se vuelva claro e incoloro.
Extraer y guardar 61 µl de eluido en un tubo Eppendorf DNA LoBind de 1,5 ml.
Cuantificar 1 μl de muestra eluida con un fluorímetro Qubit.
Nota: se espera obtener entre 1000 y 1500 ng de ADN.
Tomar el ADN reparado, con los extremos preparados y proceder a la ligación de los adaptadores. En este paso, también es posible guardar la muestra a 4 °C hasta el día siguiente.
6. Ligación de los adaptadores y purificación
Material
- Ligation Adapter (LA)
- Ligation Buffer (LNB)
- Long Fragment Buffer (LFB)
- Microesferas AMPure XP (AXP)
- Elution Buffer (EB)
Consumibles
- Ligasa de ADN Salt-T4® (NEB, M0467)
- Tubos Eppendorf DNA LoBind de 1,5 ml
- Kit Qubit dsDNA HS (Invitrogen Q32851)
- Tubos de ensayo Qubit™ (Invitrogen, Q32856)
Instrumental
- Gradilla magnética
- Microcentrífuga
- Mezclador vórtex
- Pipeta y puntas P1000
- Pipeta y puntas P100
- Pipeta y puntas P20
- Pipeta y puntas P10
- Fluorímetro Qubit™ (o equivalente)
Aunque las ligasas recomendadas de otros fabricantes incluyan su propio amortiguador, la eficiencia del adaptador -Ligation Adapter (LA)-, es mayor cuando se usa el amortiguador Ligation Buffer (LNB) incluido en el kit Ligation Sequencing.
Centrifugar brevemente los viales Ligation Adapter (LA) y Salt-T4® DNA Ligase y poner en hielo.
Descongelar el vial Ligation Buffer (LNB) a temperatura ambiente, centrifugar y mezclar con la pipeta. Debido a su viscosidad, el vórtex no es un método de mezcla eficaz. Tras descongelar y mezclar, colocar en hielo de inmediato.
Descongelar el vial Elution Buffer (EB) a temperatura ambiente y mezclar en vórtex. Centrifugar brevemente y poner en hielo.
Descongelar el amortiguador Long Fragment Buffer (LFB) a temperatura ambiente y mezclar en vórtex. Centrifugar brevemente y poner en hielo.
En un tubo Eppendorf DNA LoBind de 1,5 ml, mezclar en el siguiente orden:
Entre cada adición, mezclar con la pipeta de 10 a 20 veces.
| Reactivos | Volumen |
|---|---|
| Muestra de ADN del paso anterior | 60 µl |
| Ligation Buffer (LNB) | 25 µl |
| Salt-T4 DNA Ligase | 10 µl |
| Ligation Adapter (LA) | 5 µl |
| Total | 100 µl |
Mezclar la reacción minuciosamente con la pipeta y centrifugar brevemente.
Incubar la reacción durante 10 minutos a temperatura ambiente.
Resuspender las microesferas AMPure XP (AXP) mediante vórtex.
Añadir 40 μl a la reacción y dar suaves golpes al tubo con el dedo.
Incubar en el Hula mixer (o mezclador rotatorio) a temperatura ambiente durante 5 minutos.
Centrifugar brevemente la muestra, sedimentar en una gradilla magnética y cuando el sobrenadante esté claro e incoloro, extraer con una pipeta.
Lavar las microesferas con 250 μl de Long Fragment Buffer (LFB). Dar suaves golpecitos al tubo con el dedo, centrifugar brevemente, colocar de nuevo en la gradilla magnética y dejar que las microesferas sedimenten durante al menos 5 minutos. Extraer el sobrenadante con una pipeta y desechar.
Nota: ir con cuidado, ya que la viscosidad del amortiguador favorece la pérdida de microesferas del sedimento.
Repetir el paso anterior.
Centrifugar brevemente y colocar el tubo de nuevo en la gradilla magnética. Extraer el resto del sobrenadante. Dejar secar el sedimento durante 30 segundos aproximadamente, sin dejar que se agriete.
Sacar el tubo de la gradilla y resuspender el sedimento en 65 µl de Elution Buffer (EB). Centrifugar brevemente e incubar durante 10 minutos a 37 ºC.
Sedimentar las microesferas en una gradilla magnética durante 10 minutos, hasta que el eluido se vuelva claro e incoloro.
Extraer y conservar 65 μl del eluido que contiene la biblioteca de ADN en un tubo nuevo Eppendorf DNA LoBind de 1,5 ml.
Desechar las microesferas sedimentadas.
Cuantificar 1 μl de muestra eluida con un fluorímetro Qubit.
Nota: en un volumen de 64 μl, por lo general se recuperan entre 350 y 1000 ng de biblioteca con los adaptadores ligados.
La biblioteca preparada se cargará en la celda de flujo. Conservar en hielo o a 4 °C hasta el momento de cargar.
Recomendaciones de almacenamiento de la biblioteca
Recomendamos guardar las bibliotecas en tubos Eppendorf DNA LoBind a 4 °C, durante periodos de tiempo cortos o en casos de uso repetido, como la recarga de celdas de flujo entre lavados. En casos de almacenamiento a largo plazo (más de 3 meses) o de un solo uso, recomendamos guardar las bibliotecas a –80 °C en tubos Eppendorf DNA LoBind.
7. Acondicionamiento y carga de celdas de flujo PromethION
Material
- Sequencing Buffer (SB)
- Library Beads (LIB)
- Flow Cell Tether (FCT)
- Flow Cell Flush (FCF)
Consumibles
- Celdas de flujo PromethION
- Tubos Eppendorf DNA LoBind de 1,5 ml
Instrumental
- Dispositivo PromethION 24/48 o PromethION 2 Solo
- Dispositivo PromethION
- Pantalla protectora celdas de flujo PromethION
- Pipeta y puntas P1000
- Pipeta y puntas P200
- Pipeta y puntas P20
Este kit es compatible solo con celdas de flujo R10.4.1 (FLO-PRO114M).
Tras sacar la celda de flujo de la nevera, esperar 20 minutos a que alcance la temperatura ambiente antes de insertarla en el PromethION. En ambientes húmedos, es posible que se forme condensación en la celda de flujo. Inspeccione las clavijas doradas del conector situadas en la parte superior e inferior en busca de condensación y, si la hubiera, límpiela con una toallita sin pelusa. Comprobar que haya una almohadilla térmica negra pegada en la parte posterior.
Descongelar los viales Sequencing Buffer (SB), Library Beads (LIB), Flow Cell Tether (FCT) y Flow Cell Flush (FCF) a temperatura ambiente y mezclar en vórtex. Centrifugar brevemente y poner en hielo.
Preparar la mezcla de acondicionamiento con Flow Cell Tether (FCT) y Flow Cell Flush (FCF) como se indica a continuación. Agitar en vórtex a temperatura ambiente.
En un tubo proporcionado al número de celdas de flujo que se vayan a utilizar, combinar los siguientes reactivos:
| Reactivo | Volumen (por celda de flujo) |
|---|---|
| Flow Cell Flush (FCF) | 1 170 µl |
| Flow Cell Tether (FCT) | 30 µl |
| Total | 1 200 µl |
En PromethION 2 Solo, cargar la(s) celda(s) de flujo de la siguiente manera:
Colocar la celda de flujo sobre la placa metálica.
Deslizarla hacia el puerto de acople hasta que no se vean las clavijas doradas o la placa verde.
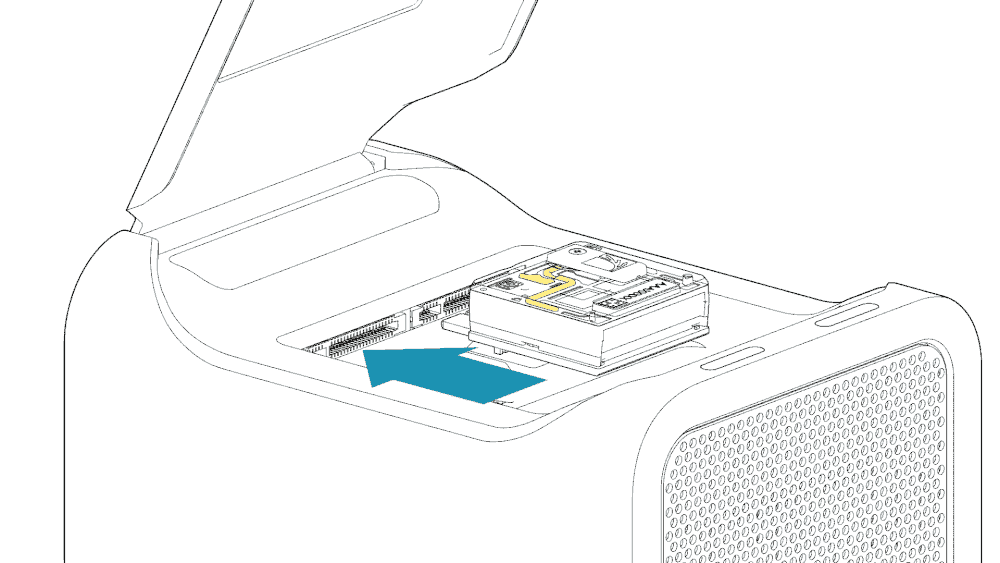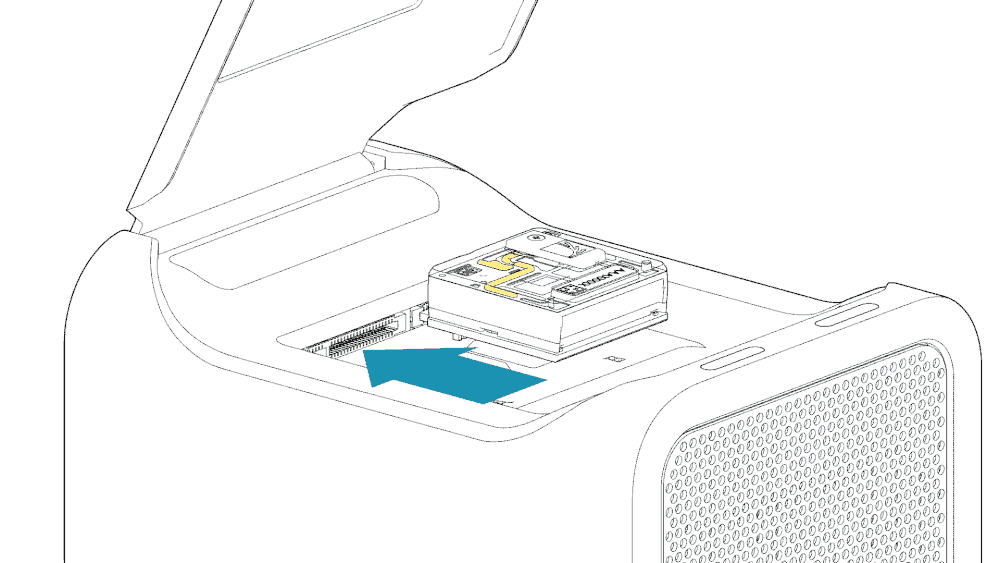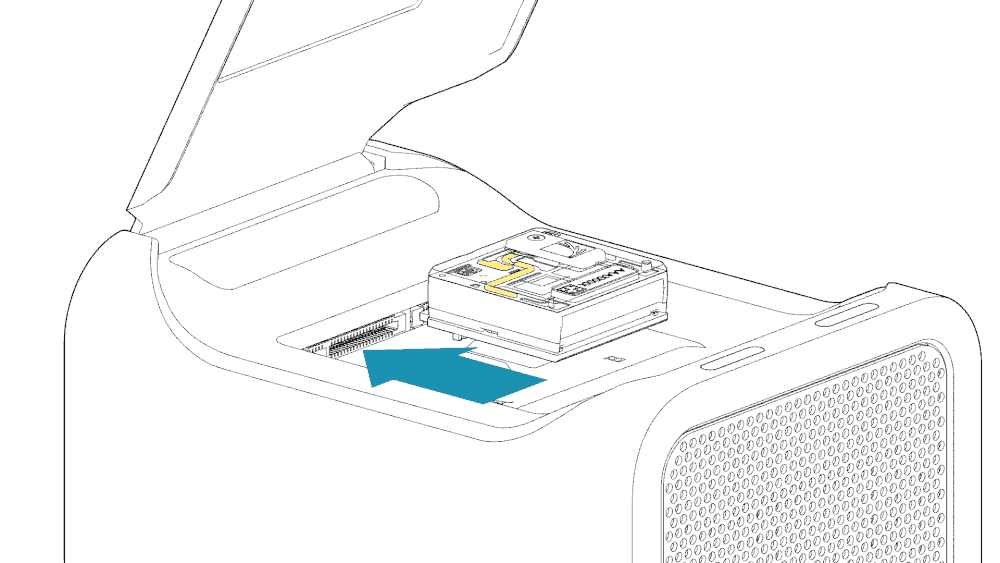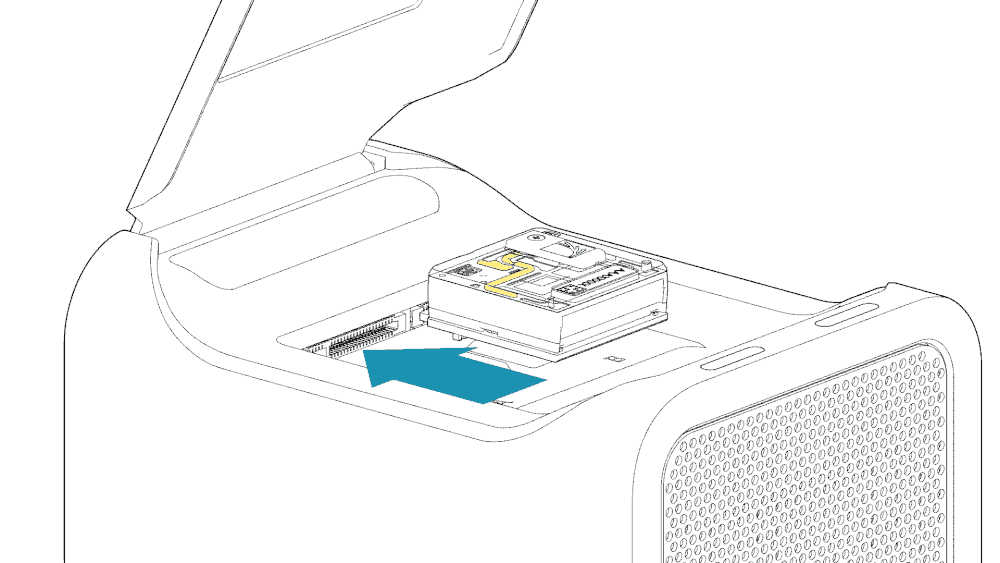
En el PromethION 24/48 cargar la(s) celda(s) de flujo en el/los puerto(s) de acople:
- Alinearla(s) con el conector (horizontal y verticalmente) e insertarla(s) con suavidad en la posición.
- Presionar con firmeza hasta que el cierre encaje y haga clic.
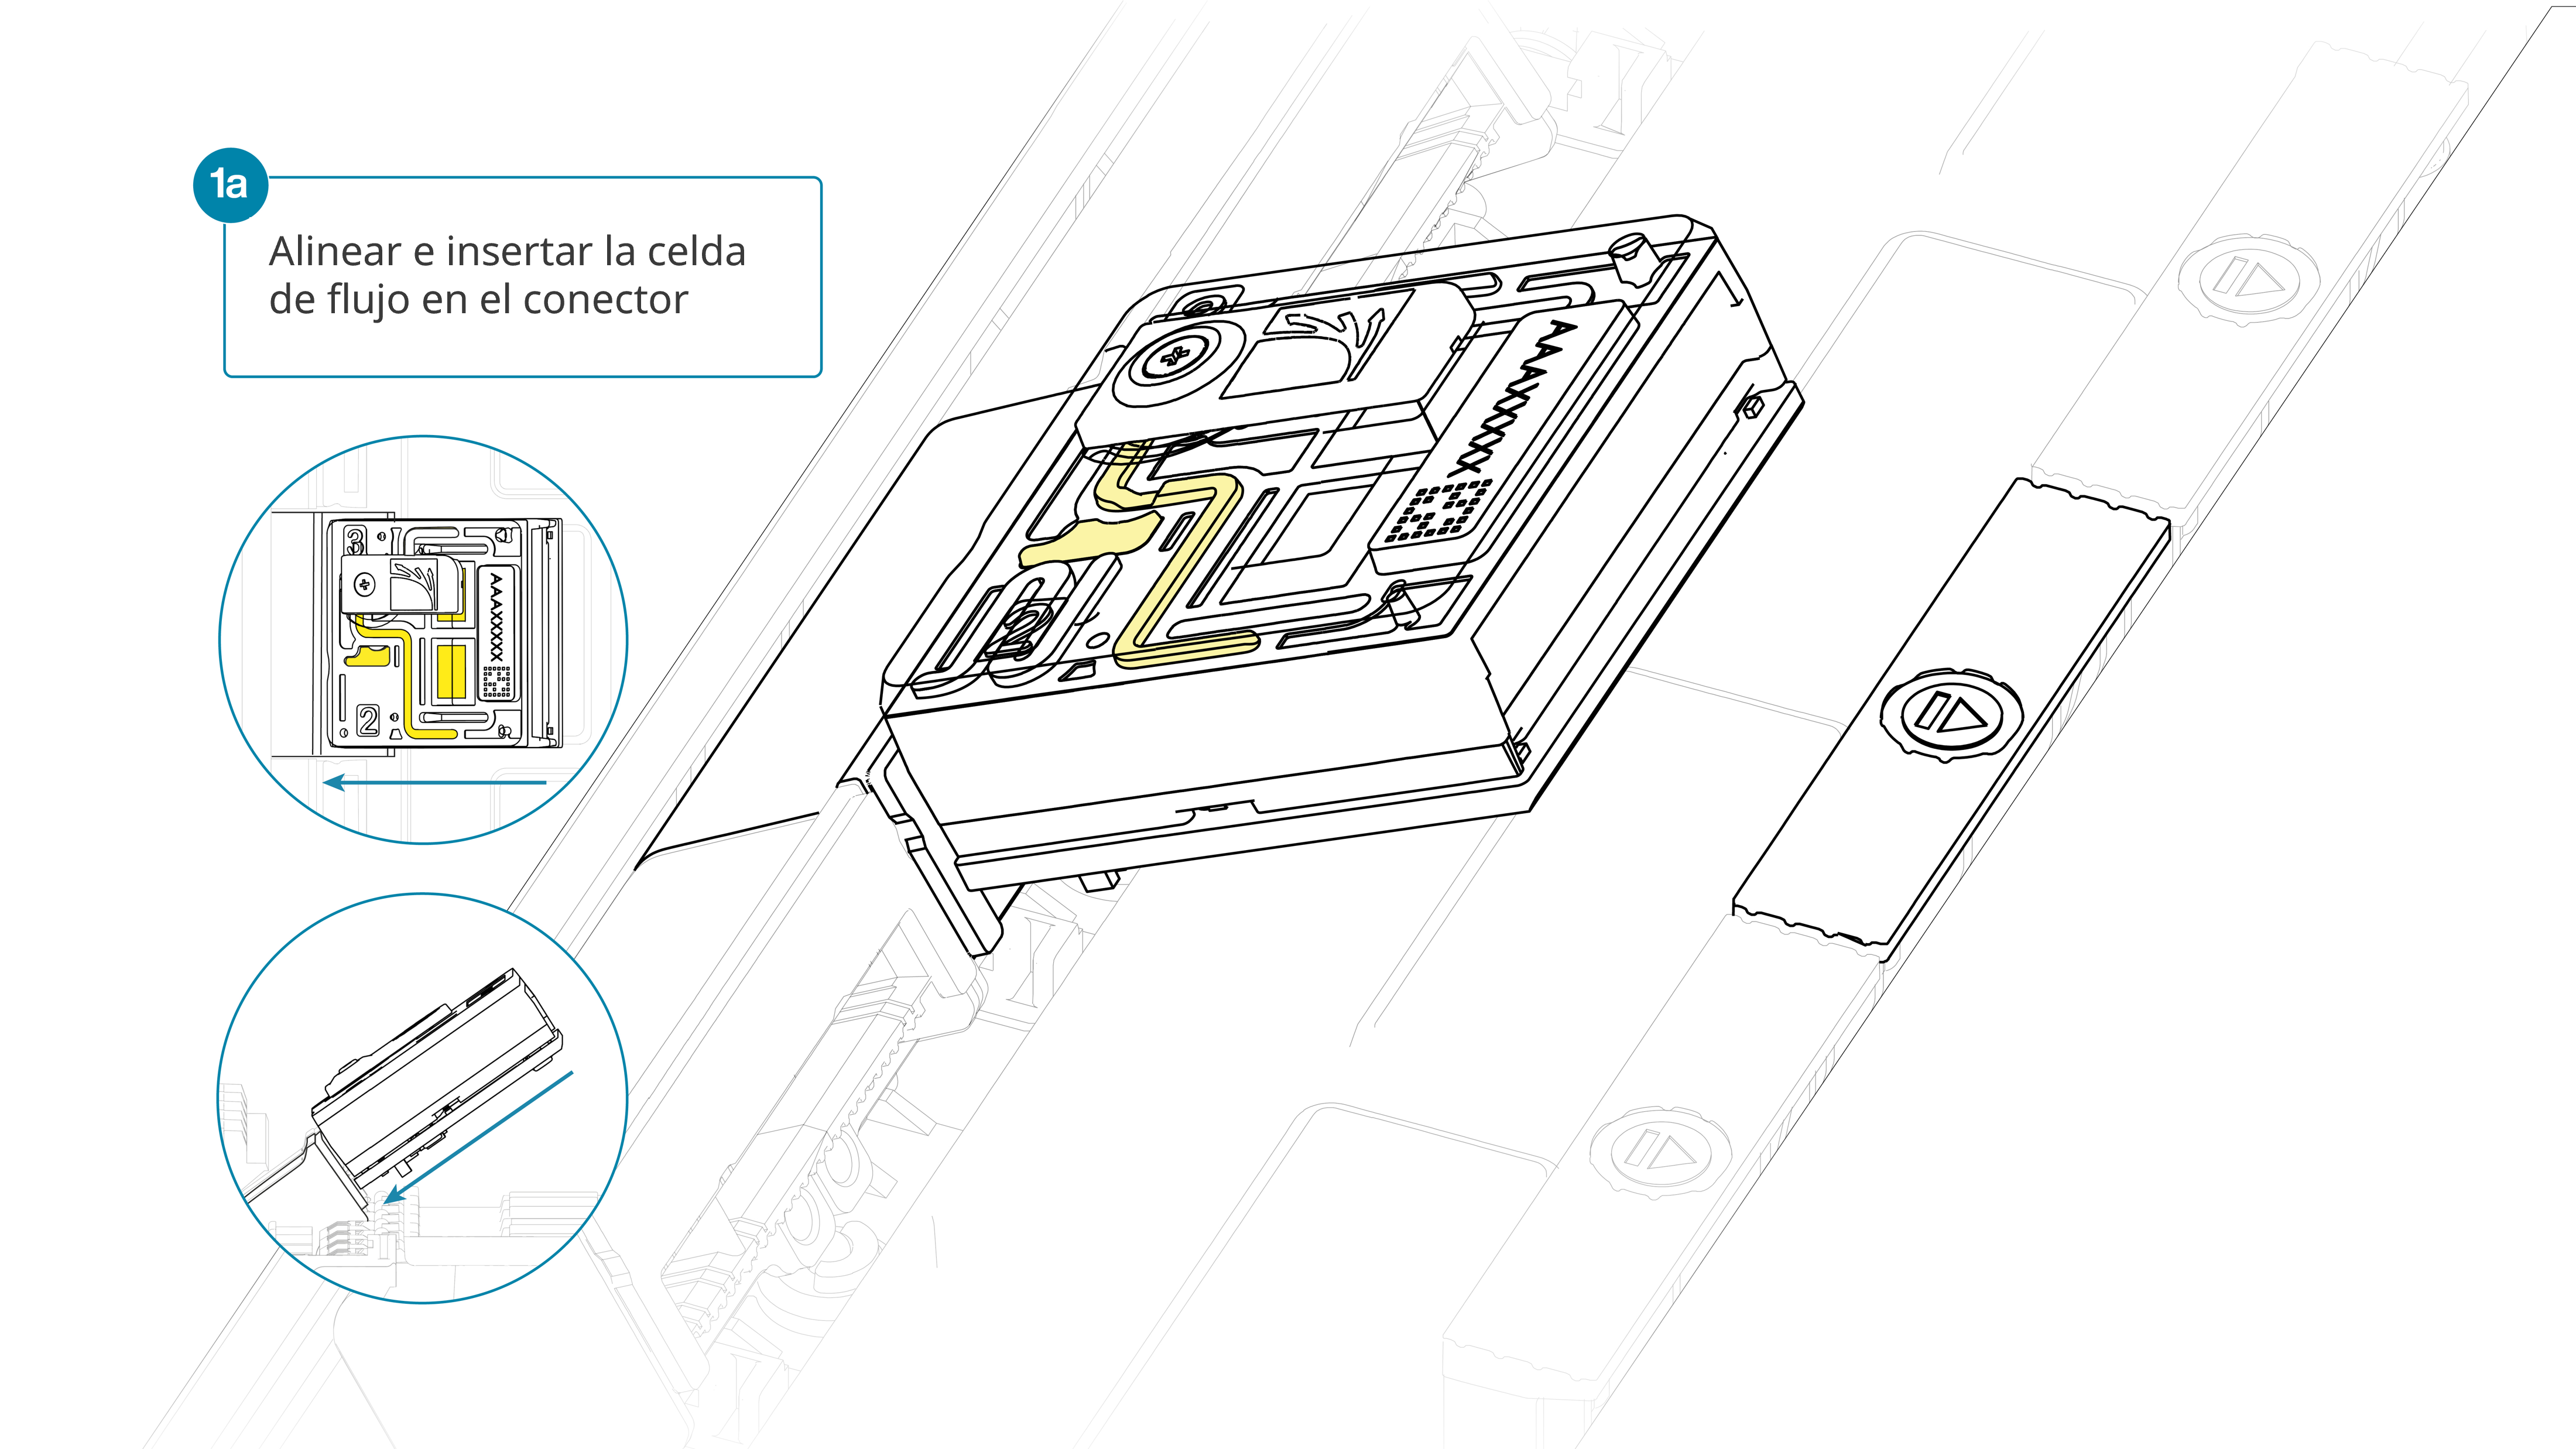
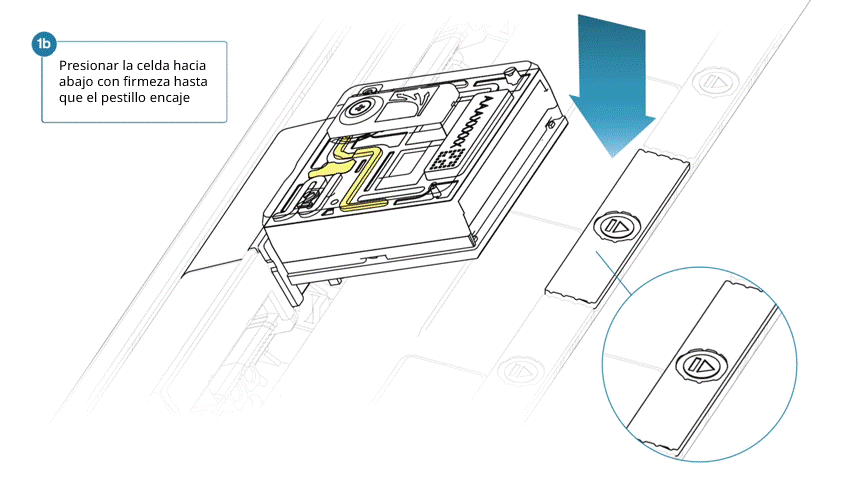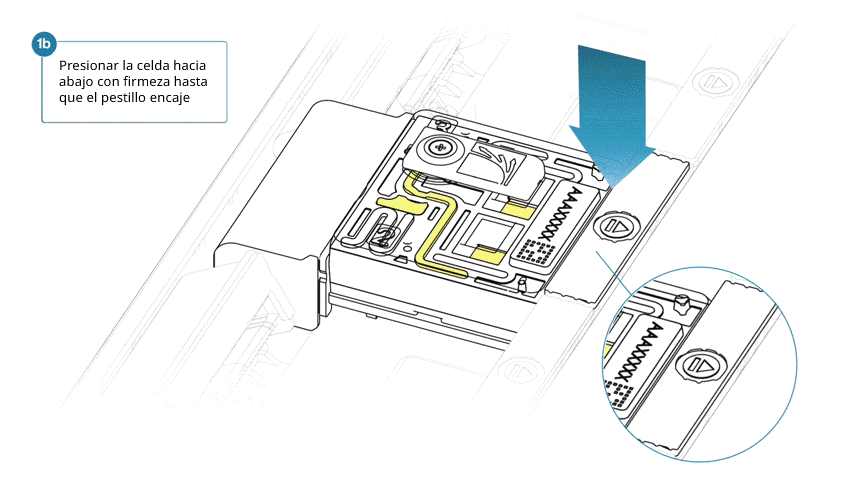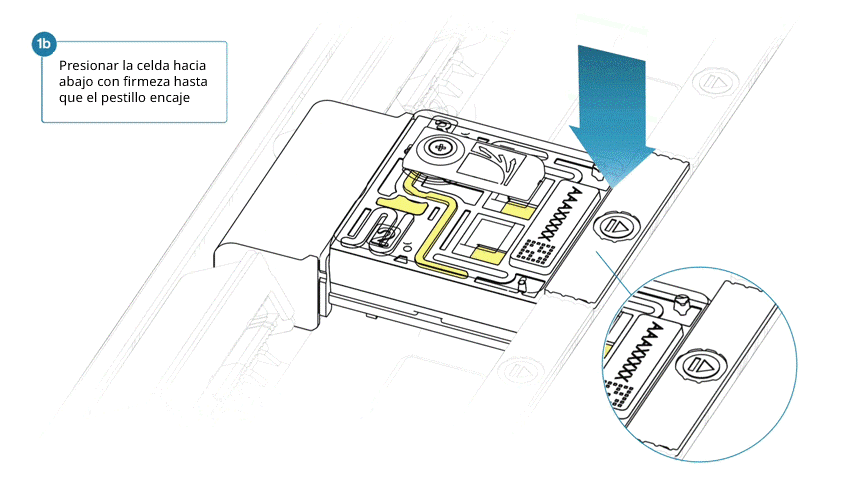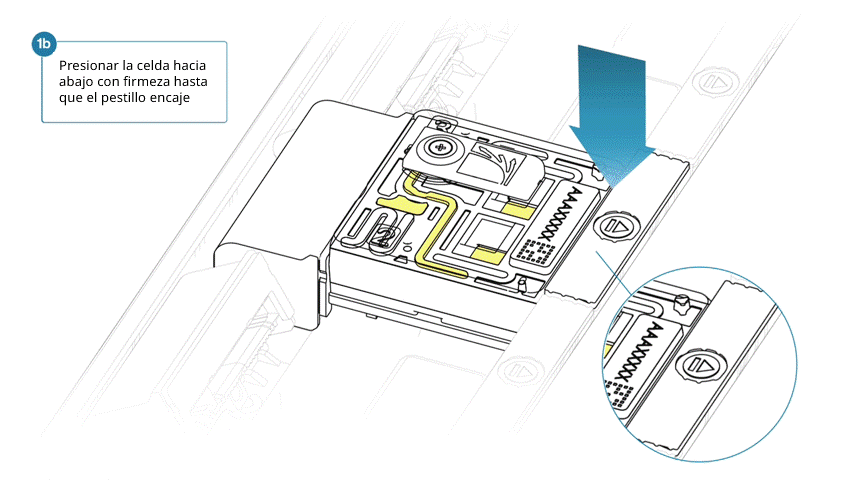
Si se insertan en el ángulo equivocado existe el riesgo de dañar las clavijas del dispositivo y afectar los resultados de secuenciación. Si observa que están dañadas, contacte con el servicio de asistencia en support@nanoporetech.com.
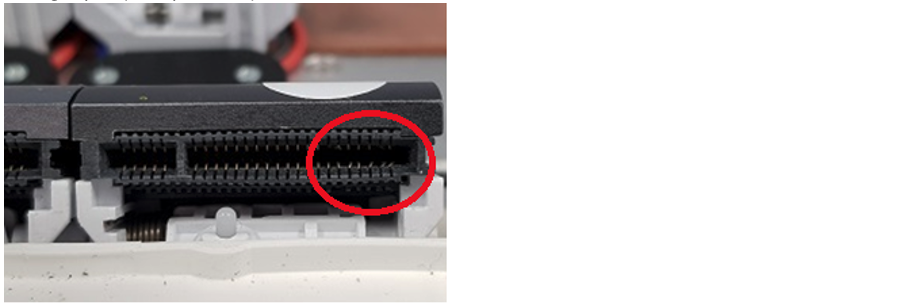
Antes de cargar la biblioteca, verificar la celda de flujo y determinar el número de poros que tiene.
Si se ha verificado con anterioridad, es posible omitir este paso.
Encontrará más información en el documento Flow cell check.
Abrir la tapa del puerto de entrada deslizándola en el sentido de las agujas del reloj.
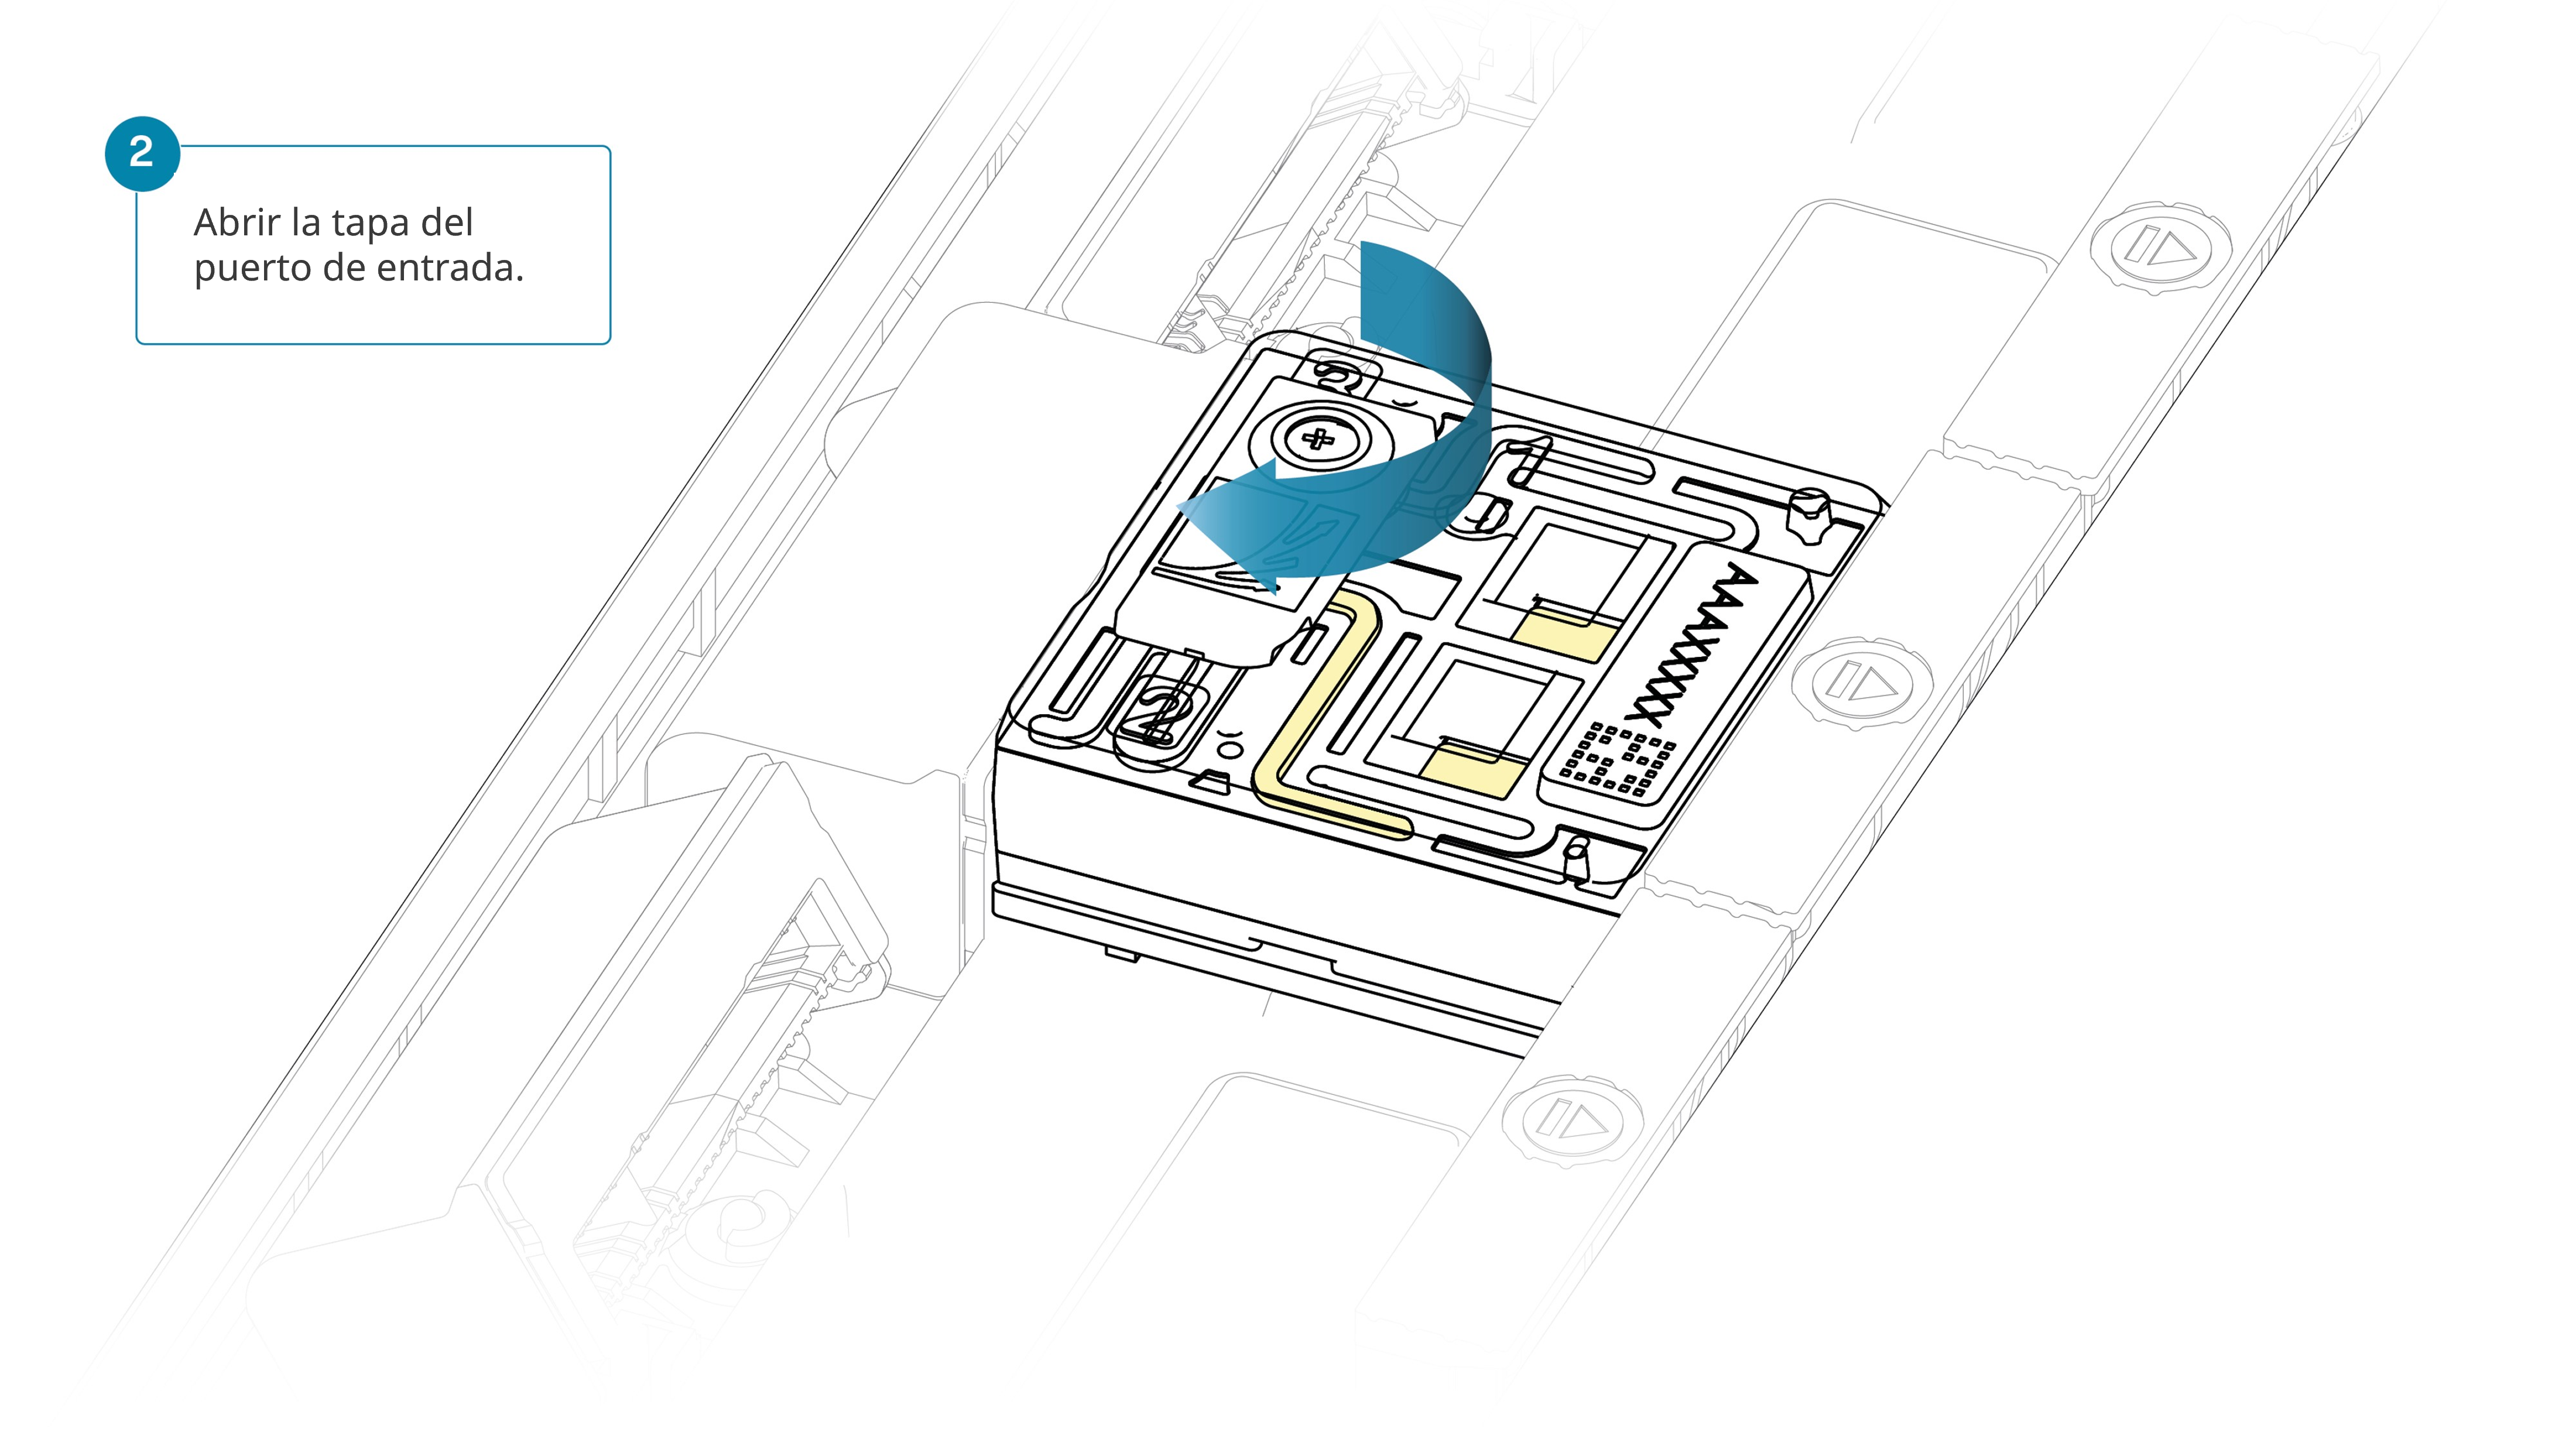
Tenga cuidado al extraer el amortiguador. No aspire más de 20-30 μl y compruebe que cubra la matriz de poros en todo momento. La introducción de burbujas de aire en la matriz daña los poros de manera irreversible.
Tras abrir el puerto de entrada, aspirar un pequeño volumen y extraer así cualquier burbuja:
- Ajustar una pipeta P1000 a 200 μl.
- Introducir la punta en el puerto de entrada.
- Girar la rueda hasta que el indicador de volumen marque 220-230 μl o hasta que una pequeña cantidad de amortiguador entre en la punta.
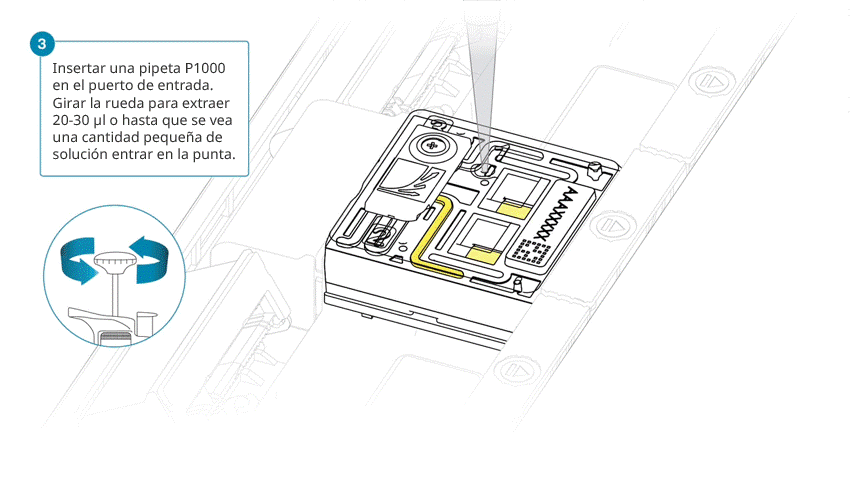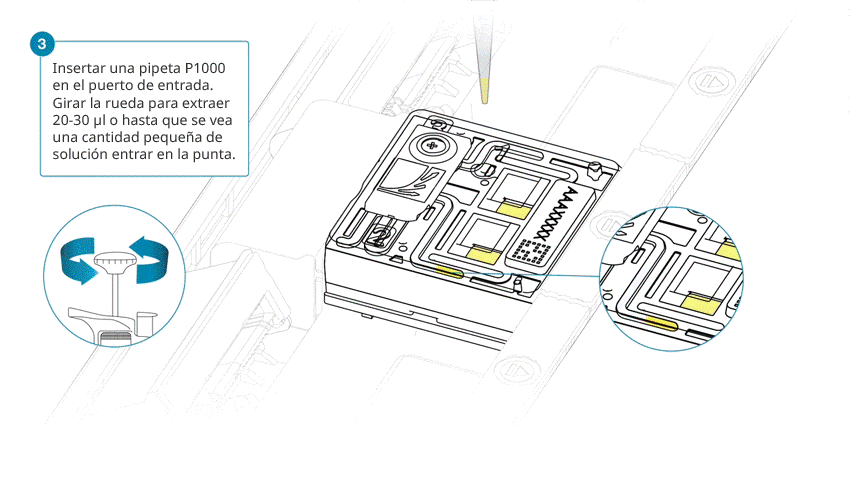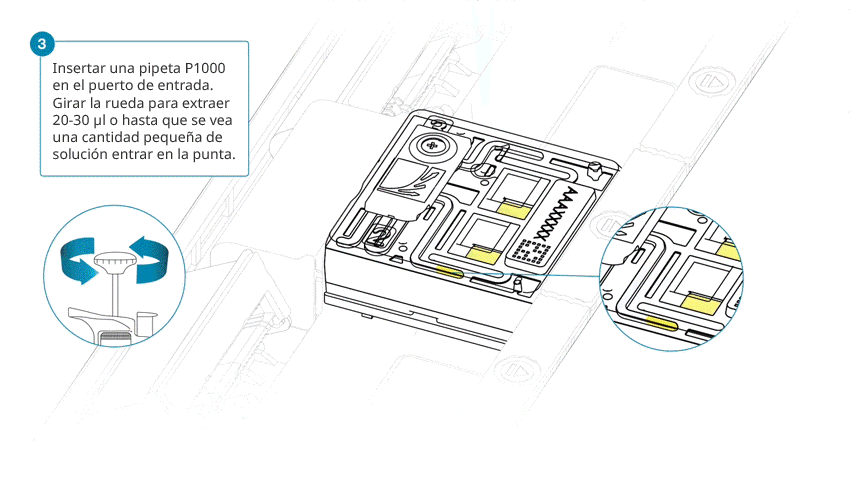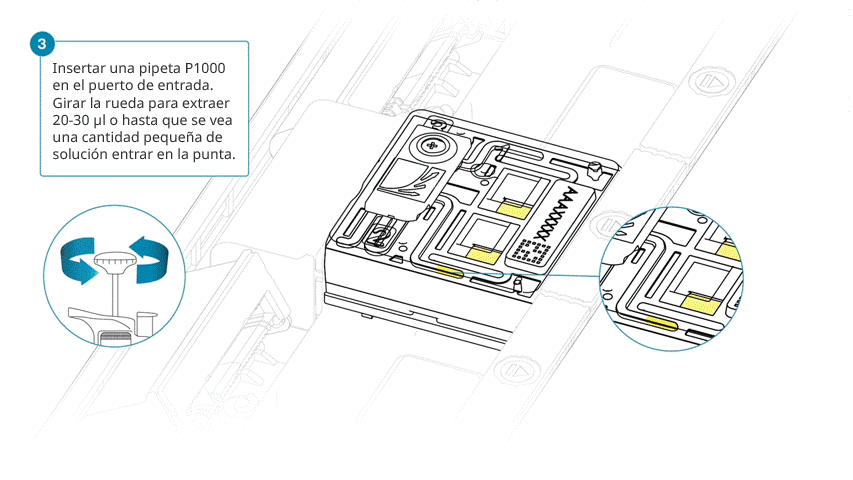
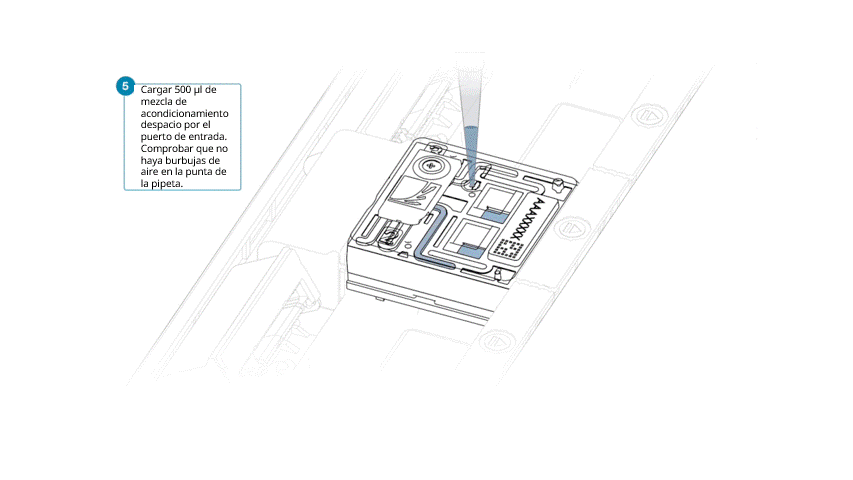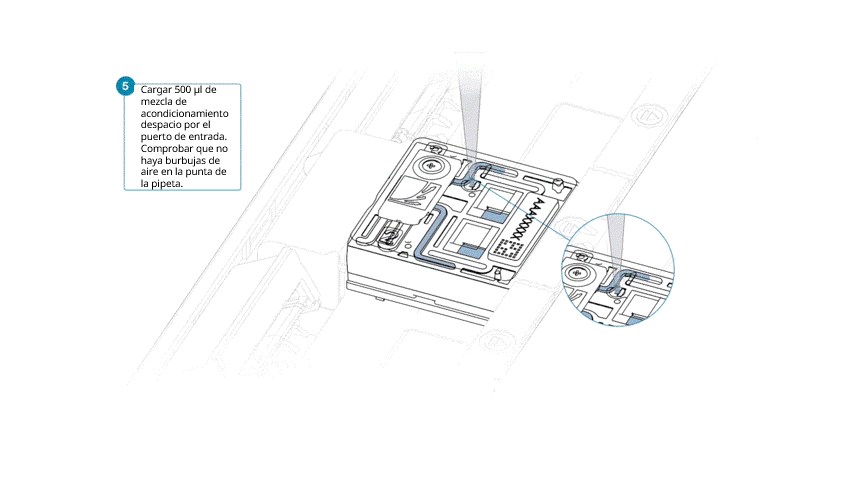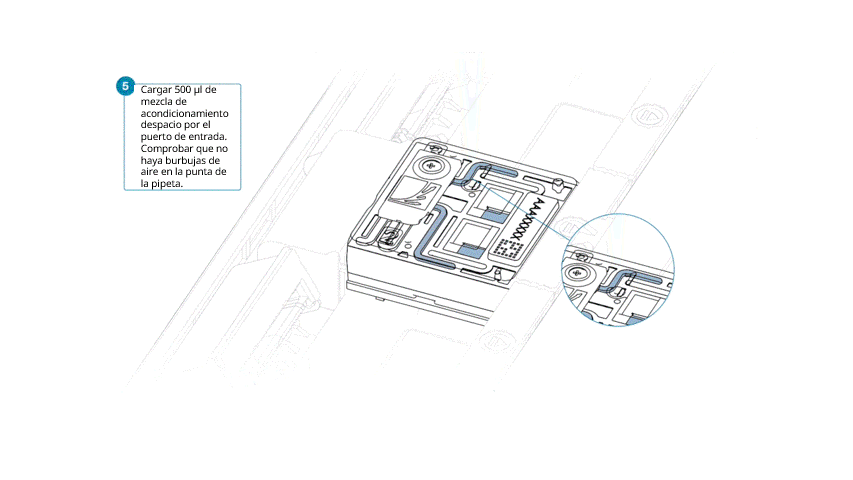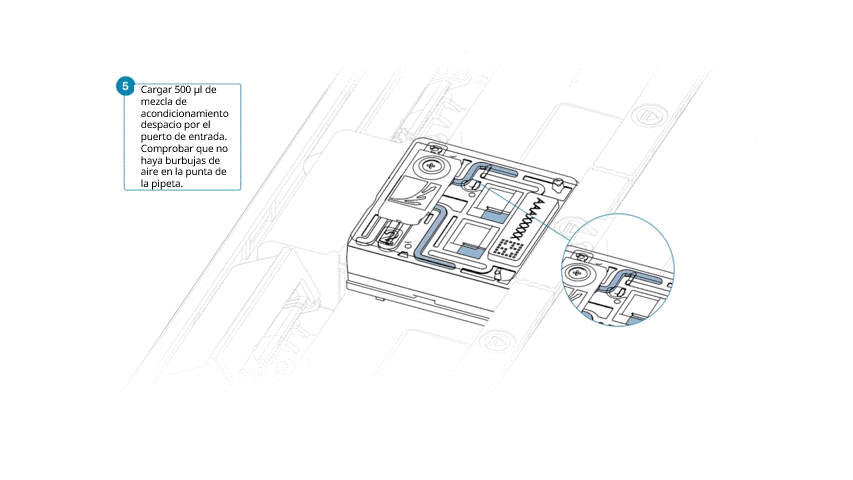
Cargar 500 μl de mezcla de acondicionamiento por el puerto de entrada, evitando introducir burbujas de aire. Esperar cinco minutos. Mientras tanto, preparar la biblioteca siguiendo los siguientes pasos.
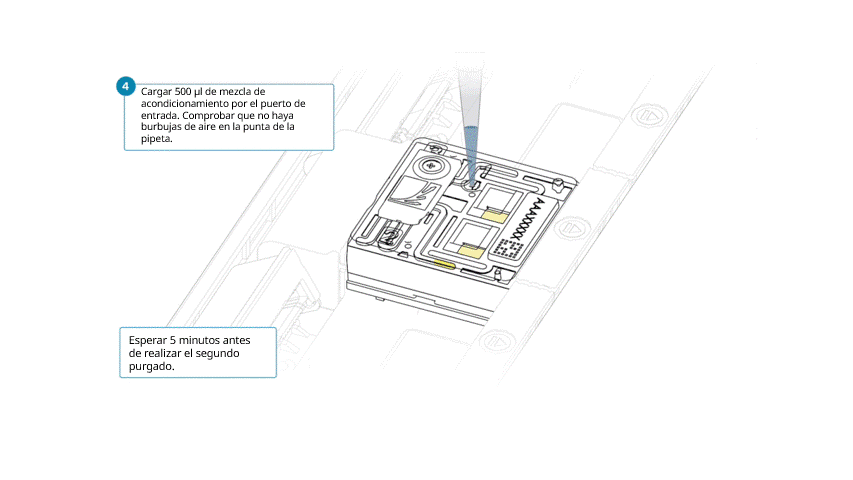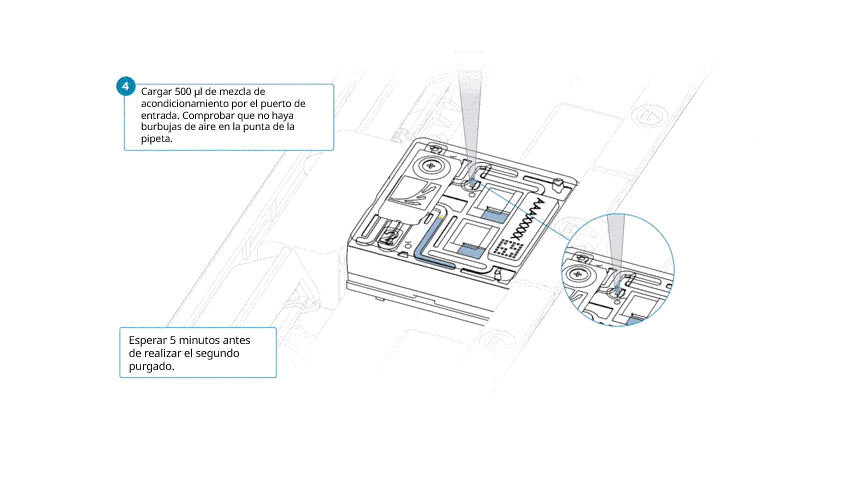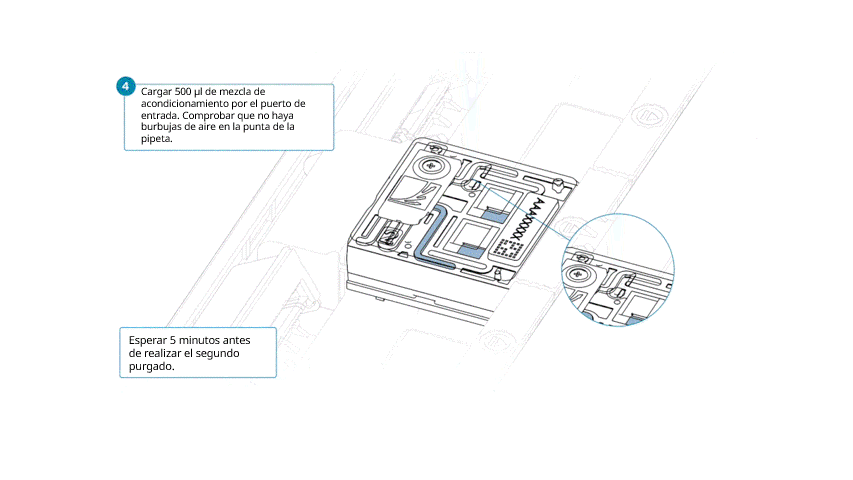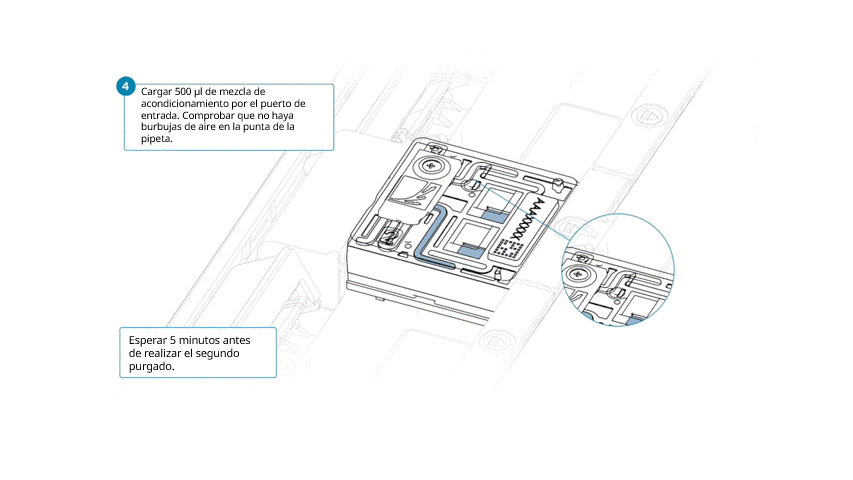
Mezclar minuciosamente con la pipeta el contenido del vial Library Beads (LIB).
El vial Library Beads (LIB) contiene microesferas en suspensión, que sedimentan muy rápido; por eso es crucial mezclarlas justo antes de su uso.
Recomendamos utilizar Library Beads (LIB) en la mayoría de experimentos de secuenciación. No obstante, con bibliotecas más viscosas recomendamos utilizar Library Solution (LIS).
En un tubo Eppendorf DNA LoBind de 1,5 ml preparar la biblioteca de la siguiente manera:
| Reactivos | Volumen por celda de flujo |
|---|---|
| Sequencing Buffer (SB) | 100 µl |
| Library Beads (LIB) bien mezclado antes de su uso | 68 µl |
| Biblioteca de ADN | 32 µl |
| Total | 200 µl |
Nota: la biblioteca resultante se cargará en la celda de flujo. Conservar en hielo o a 4 °C hasta el momento de cargar.
Terminar de acondicionar la celda de flujo cargando lentamente 500 µl de mezcla de preparación por el puerto de entrada.
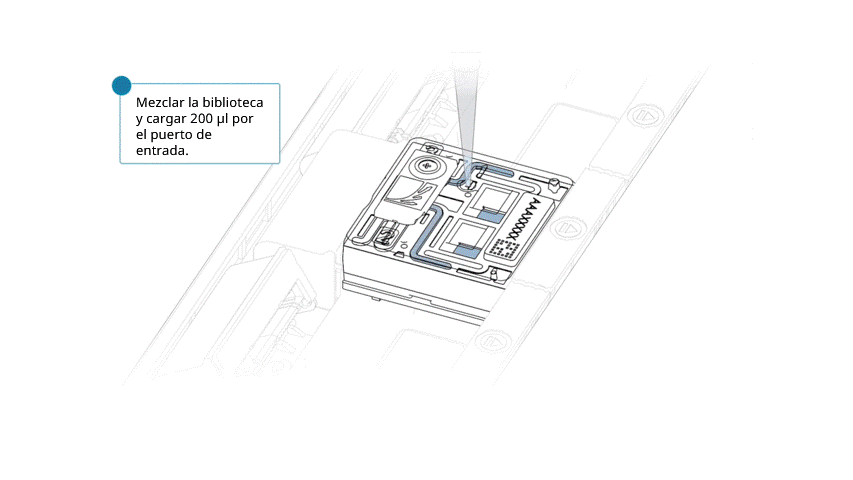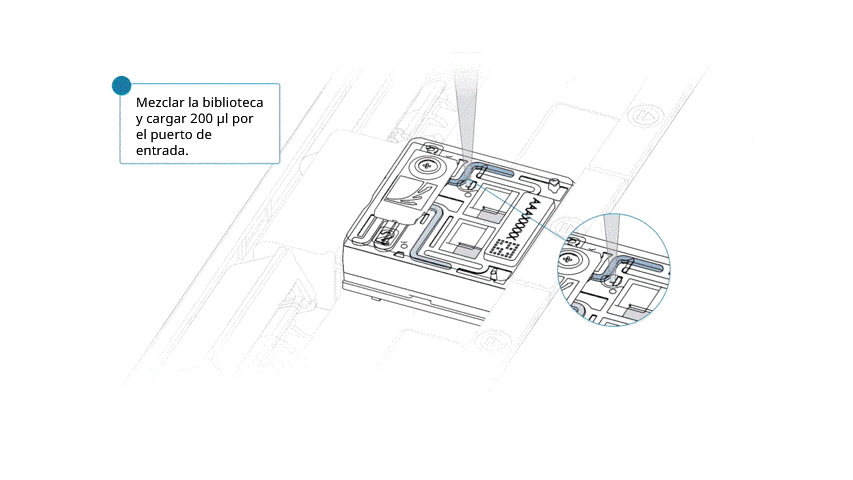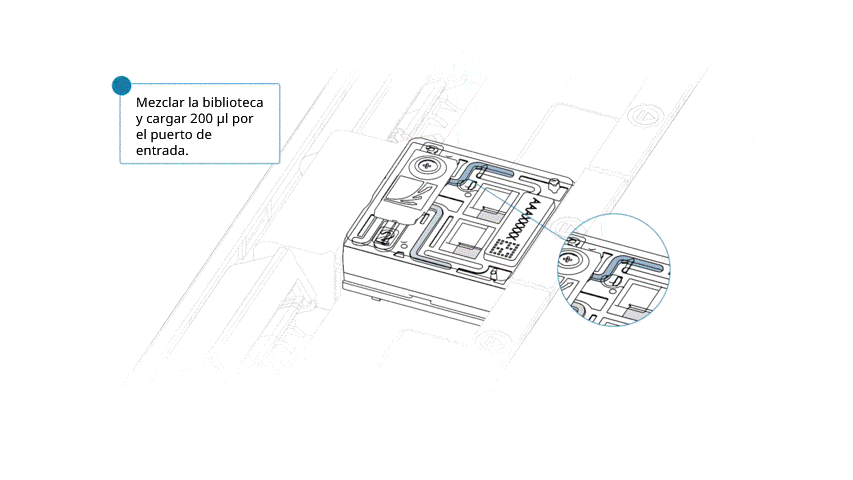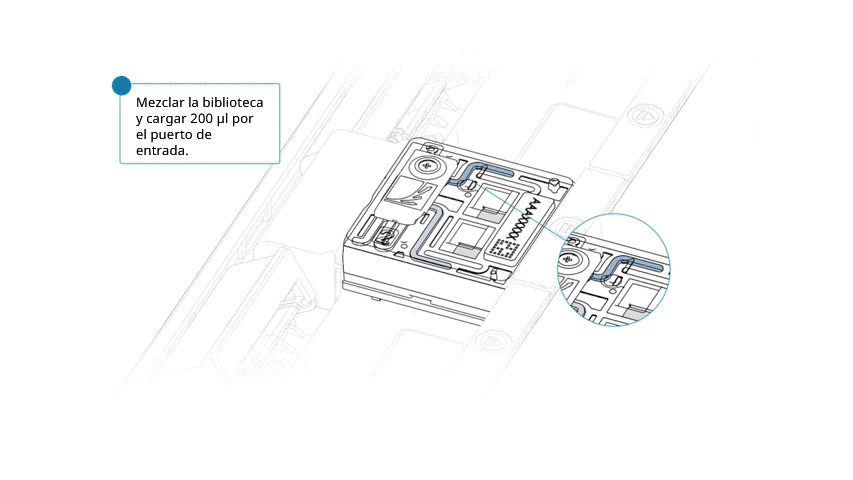
Mezclar la biblioteca aspirando y dispensando con cuidado antes de cargarla.
Con una pipeta P1000, cargar 200 μl de biblioteca por el puerto de entrada.
Cerrar la válvula y sellar así el puerto de entrada.
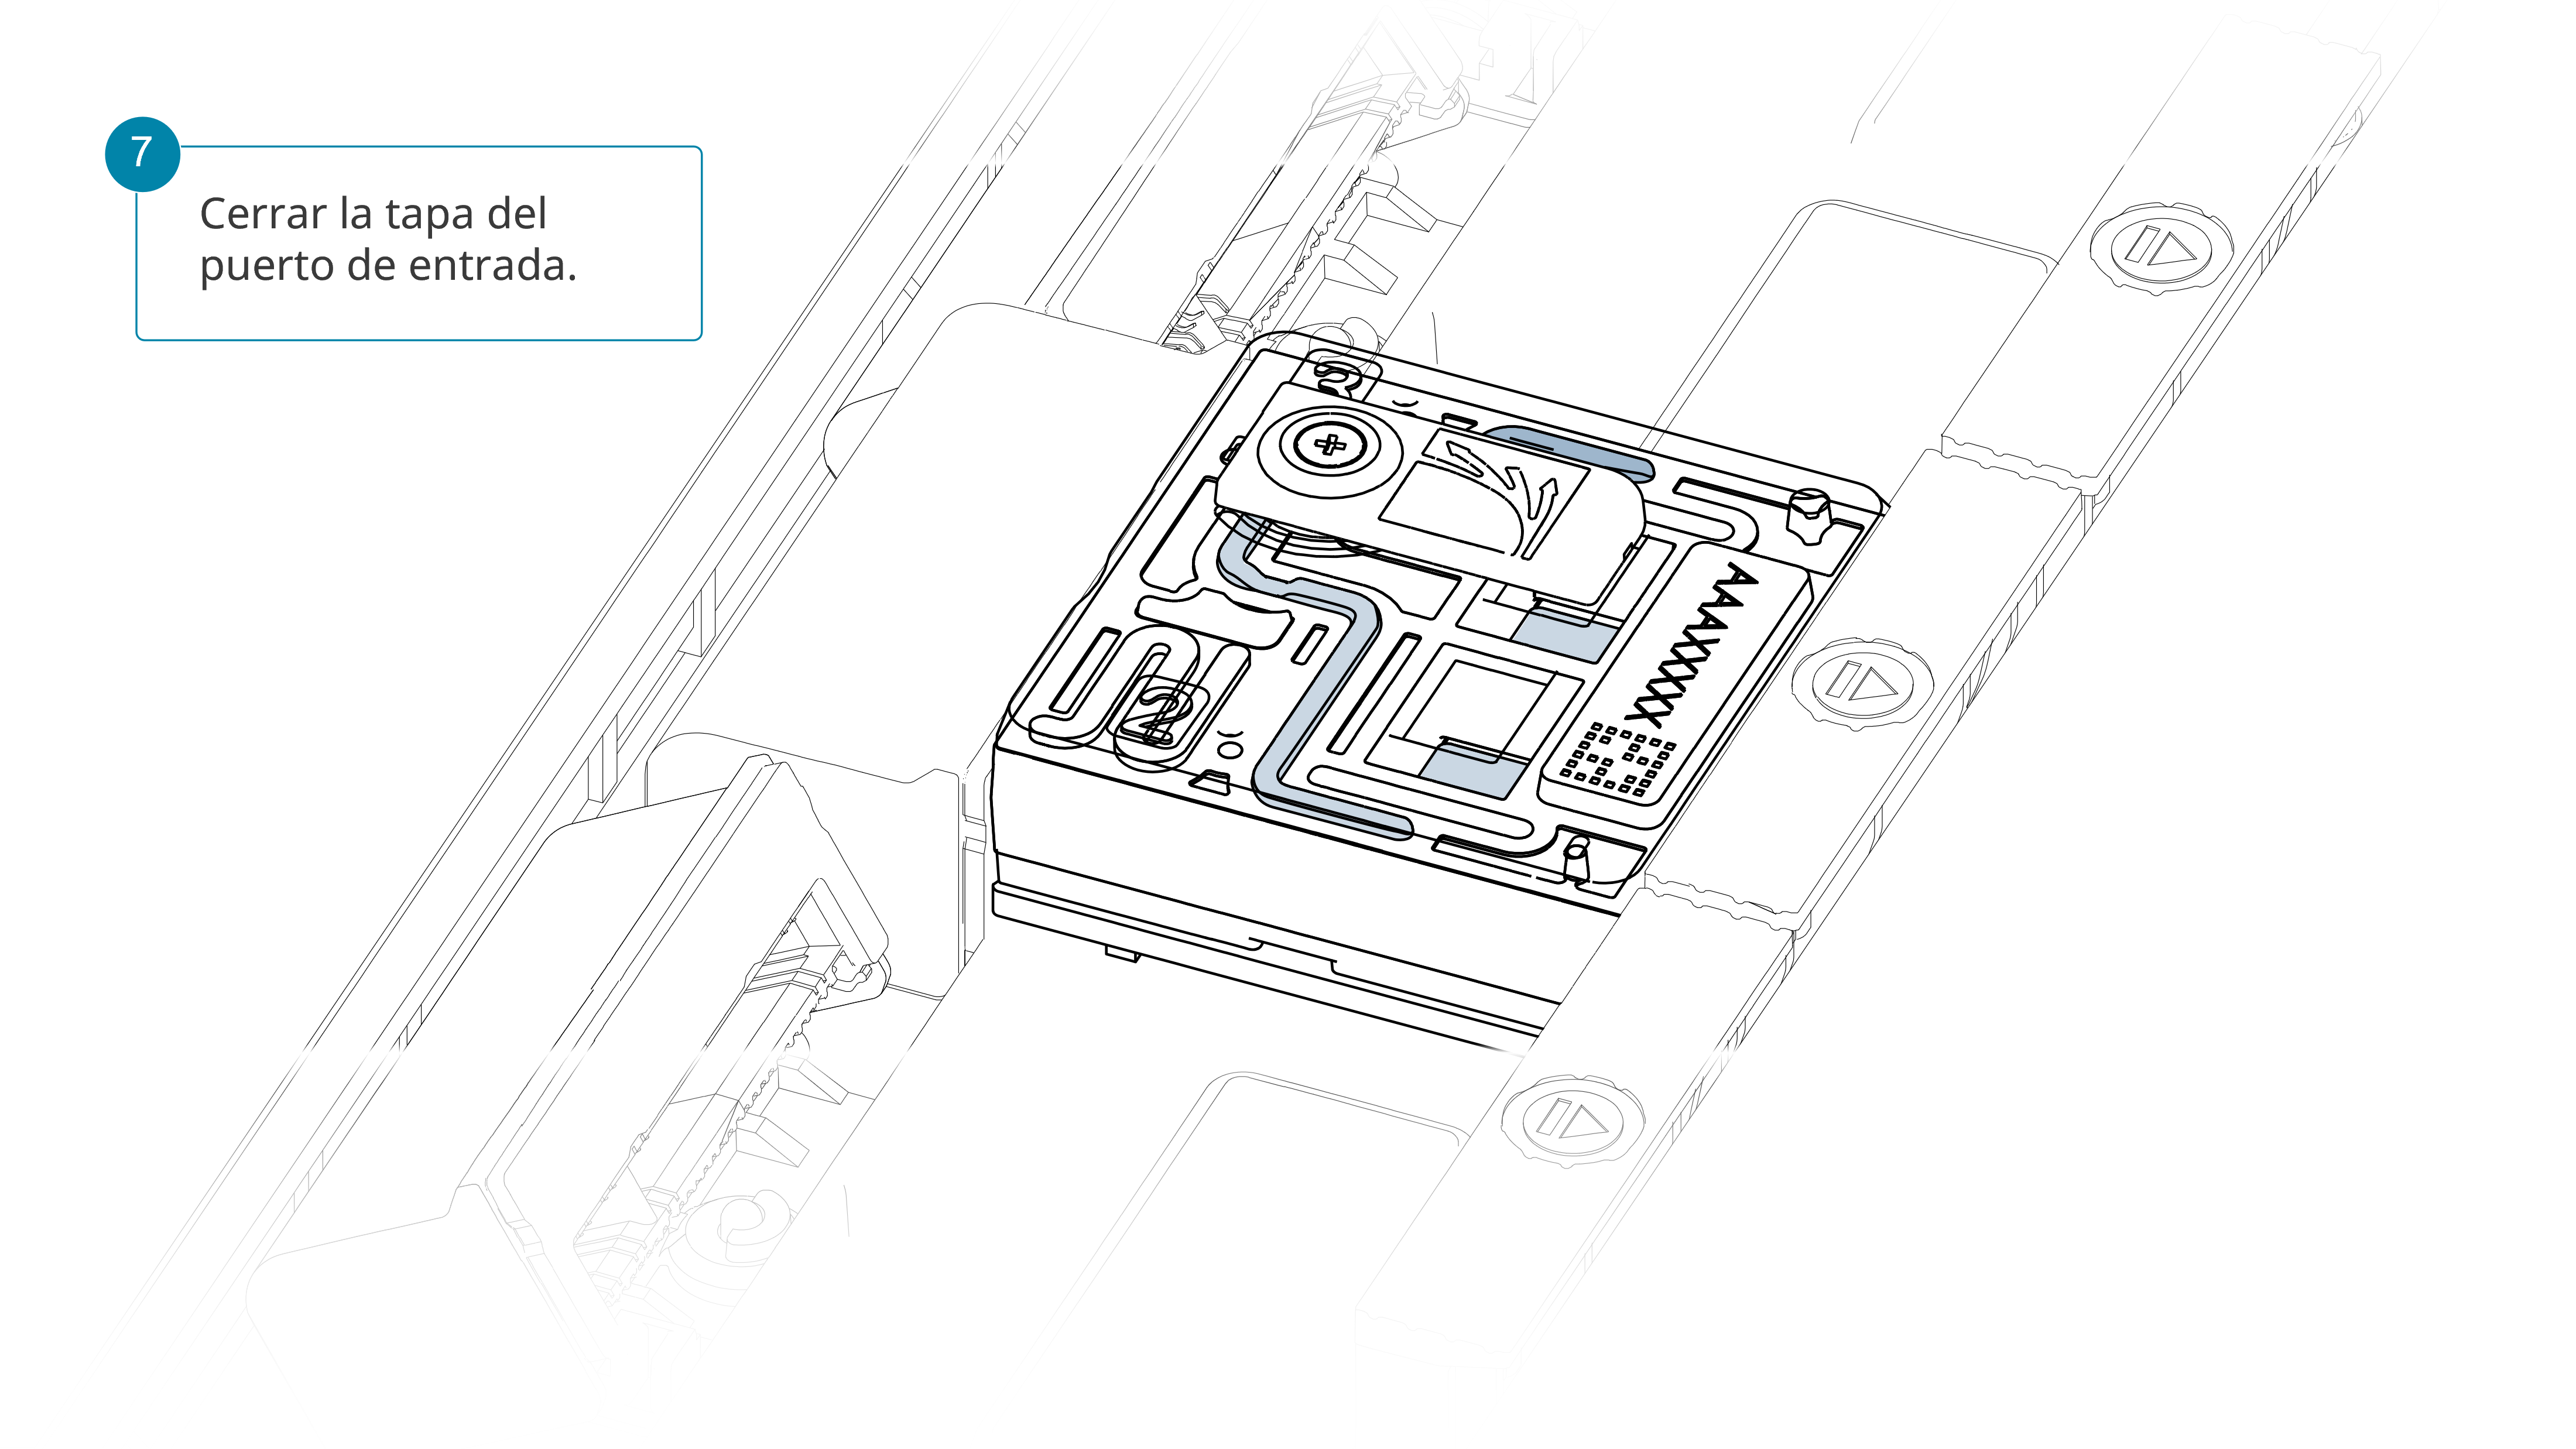
Colocar la pantalla protectora sobre la celda de flujo en cuanto se haya cargado la biblioteca. Así se obtiene un rendimiento de secuenciación óptimo.
Recomendamos no retirarla mientras la biblioteca esté cargada ni durante los lavados o las recargas. Se retira una vez se haya extraído la biblioteca.
Si se ha quitado antes de lo previsto, se coloca de la siguiente manera:
- Alinear la abertura de la pantalla con la tapa del puerto de entrada. El borde delantero de la pieza debe quedar por encima del identificador de la celda de flujo.
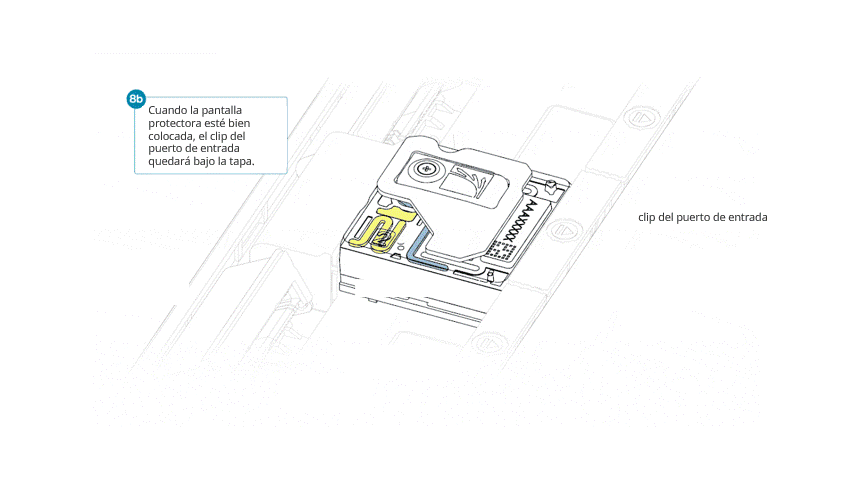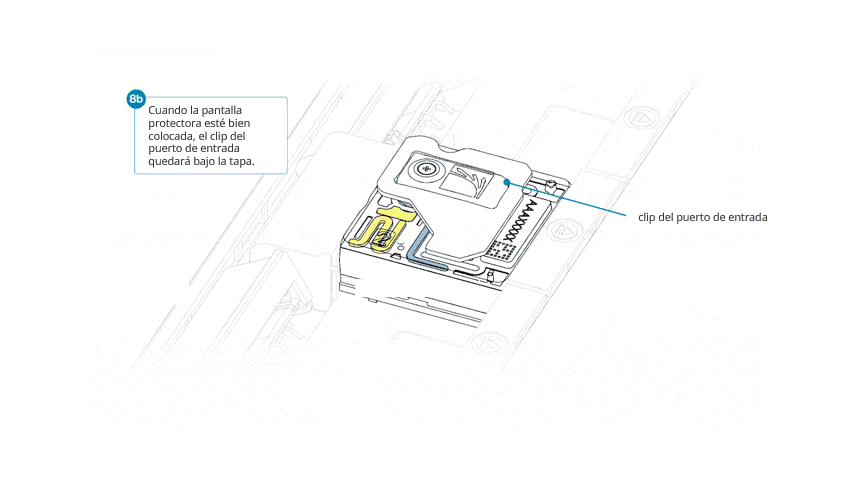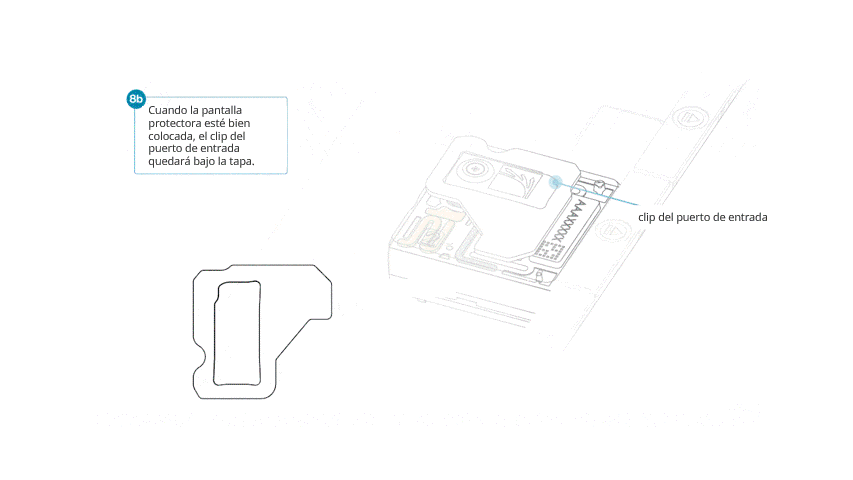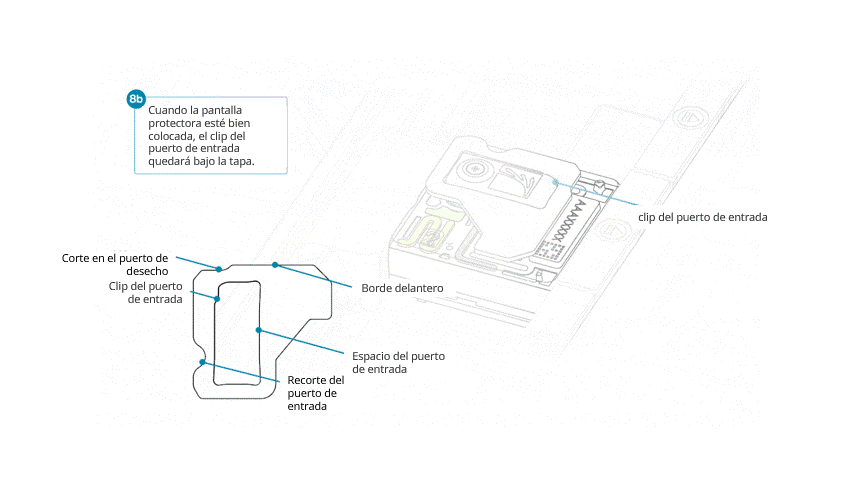
- Presionar la pantalla protectora con firmeza alrededor de la tapa del puerto de entrada. Cuando el clip encaje bajo la tapa del mismo, se producirá un clic.
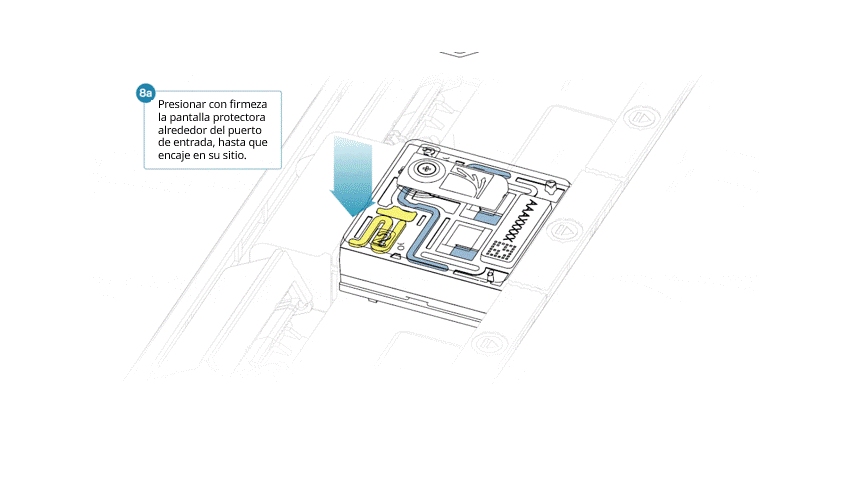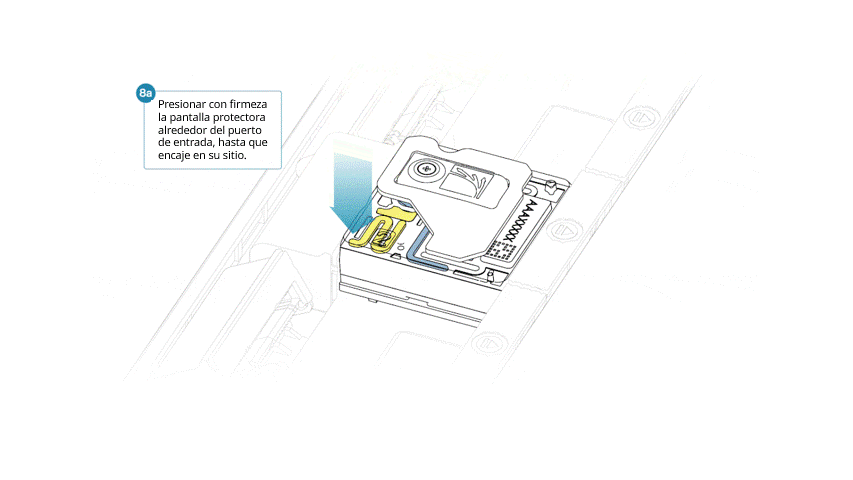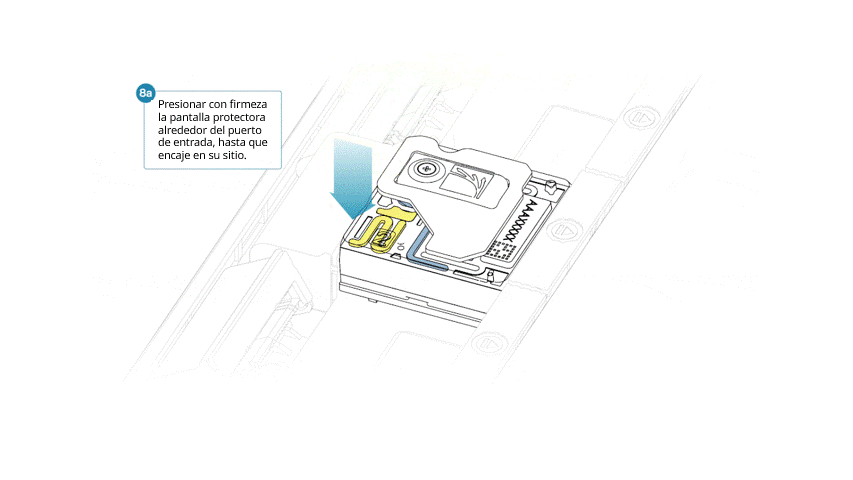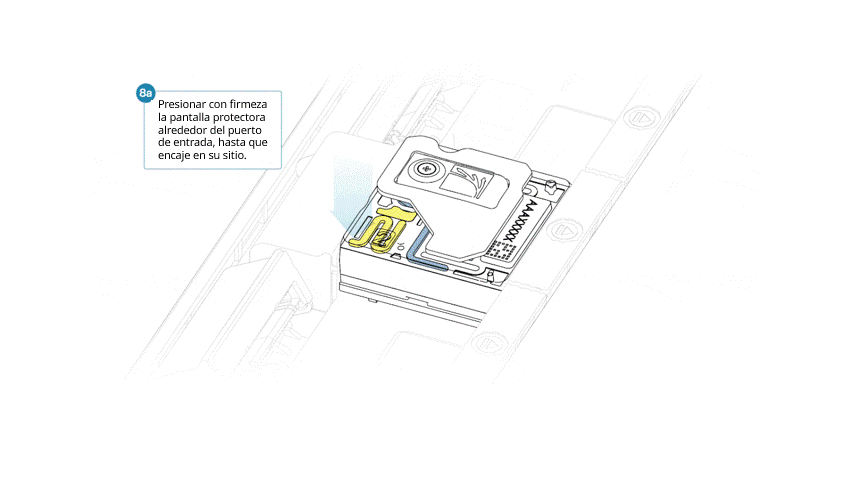
Cuando esté todo listo para empezar la secuenciación en MinKNOW, cerrar la tapa del dispositivo.
Tras cargar las celdas de flujo, esperar al menos 10 minutos antes de iniciar el experimento; de este modo se contribuye a aumentar el rendimiento de la secuenciación.
Las instrucciones de configuración de experimentos de secuenciación están en la sección Adquisición de datos e identificación de bases de este protocolo.
Recuerde: en este protocolo, tras 30 h de secuenciación aproximadamente, recomendamos lavar la celda de flujo y cargar una biblioteca nueva; así se mantendrá elevada la adquisición de datos.
Para ello, siga las instrucciones que se indican a continuación.
8. Lavar y volver a cargar celdas de flujo PromethION
Material
- Biblioteca de ADN con adaptadores ligados (sección anterior)
- Kit Flow Cell Wash (EXP-WSH004)
- Material complementario Sequencing Auxiliary Vials V14 (EXP-AUX003)
Consumibles
- Tubos Eppendorf DNA LoBind de 1,5 ml
Instrumental
- Pipeta y puntas P1000
- Pipeta y puntas P20
- Cubeta con hielo
- Mezclador vórtex
Recomendamos lavar y volver a cargar la celda de flujo después de unas 30 h de secuenciación.
En este método, la celda de flujo se lava tras 30 h, con el fin de restablecer los poros y garantizar una adquisición de datos eficaz.
Por eso se creó suficiente biblioteca para cargar 2 celdas de flujo, en la fase de ligación del adaptador.
- Este lavado tiene por objeto eliminar la mayor parte de la biblioteca inicial y desbloquear los poros, de modo que la celda de flujo esté lista antes de cargar la siguiente biblioteca.
- La adquisición de datos en MinKNOW debe interrumpirse durante el lavado y la carga de la biblioteca.
- Una vez finalizado el lavado, es posible cargar la siguiente biblioteca.
El número de poros utilizables se muestra en el gráfico de actividad o en el de los resultados de la exploración.
A continuación se presentan datos de ejemplo sobre el estado de los poros, observado en una celda de flujo antes y después de realizar los pasos de lavado. Además, es posible observar un ejemplo de los datos de secuenciación acumulados, incluyendo los pasos de lavado y recarga. Los asteriscos rojos indican los lavados y recargas realizados.
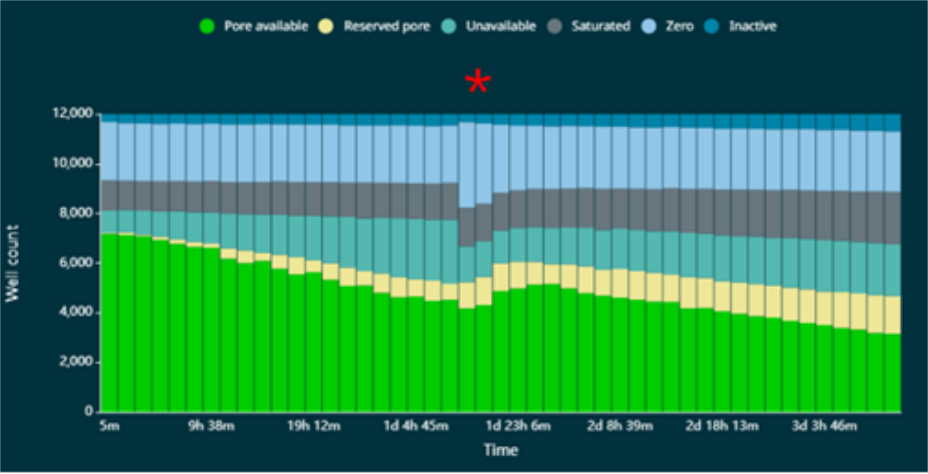
Figura 1. Estado de los canales durante 72 horas de funcionamiento. Los lavados de las celdas de flujo están incluidos en el método, con el fin de restablecer los poros bloqueados y permitir una adquisición continua de datos. Los asteriscos rojos indican que se ha realizado un purgado.
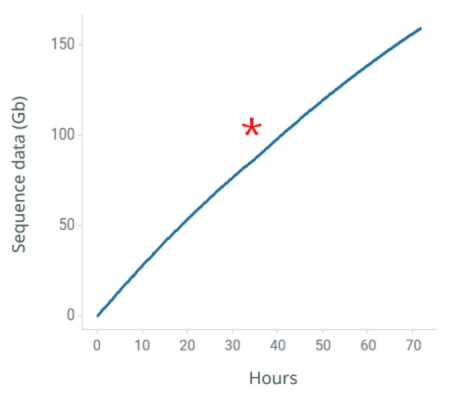
Figura 2. Datos de secuenciación acumulados durante una ejecución de 72 horas. Los asteriscos rojos indican que se ha realizado un purgado.
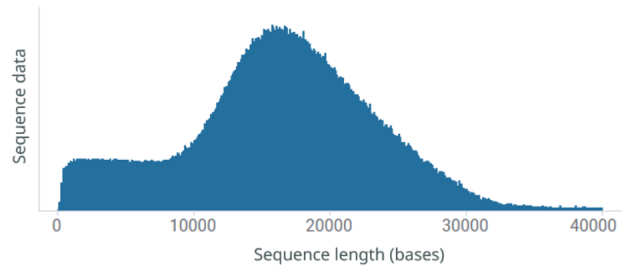
Figura 3. Perfil de longitudes de lectura de una biblioteca con un N50 de 15 kb. La forma casi gaussiana es característica del ADNg tras la fragmentación con Megaruptor.
Vídeo de lavado y recarga de celdas de flujo PromethION
En él se muestra cómo lavar una celda de flujo tras un experimento de secuenciación y cómo cargar una nueva biblioteca.
Si se va a cargar de inmediato una segunda biblioteca, recomendamos mantener la pantalla protectora colocada durante el lavado.
Se puede quitar, si la celda de flujo se va a lavar y guardar.
Colocar el tubo Wash Mix (WMX) en hielo. No mezclar en vórtex.
Descongelar un vial de Wash Diluent (DIL) a temperatura ambiente.
Mezclar su contenido minuciosamente mediante vórtex, centrifugar brevemente y colocar en hielo.
En un tubo Eppendorf DNA LoBind de 1,5 ml preparar la siguiente mezcla de lavado:
| Reactivos | Volumen por celda de flujo |
|---|---|
| Wash Mix (WMX) | 2 μl |
| Wash Diluent (DIL) | 398 μl |
| Total | 400 μl |
Mezclar bien con la pipeta y colocar en hielo. No mezclar en vórtex.
Detener el experimento de secuenciación en MinKNOW y dejar la celda de flujo en el dispositivo.
Es fundamental que el puerto de entrada esté cerrado antes de extraer los desechos; de lo contrario, el aire atravesaría la zona de la matriz de sensores, lo que provocaría una pérdida significativa de canales de secuenciación.
Retirar el amortiguador de desecho de la siguiente manera:
- Cerrar el puerto de entrada.
- Insertar una pipeta P1000 en el puerto de desecho y extraer el amortiguador.
Nota: como el orificio de entrada está cerrado, ningún fluido debe salir de la zona de la matriz de sensores.
Abrir la tapa del puerto de entrada deslizándola en el sentido de las agujas del reloj.
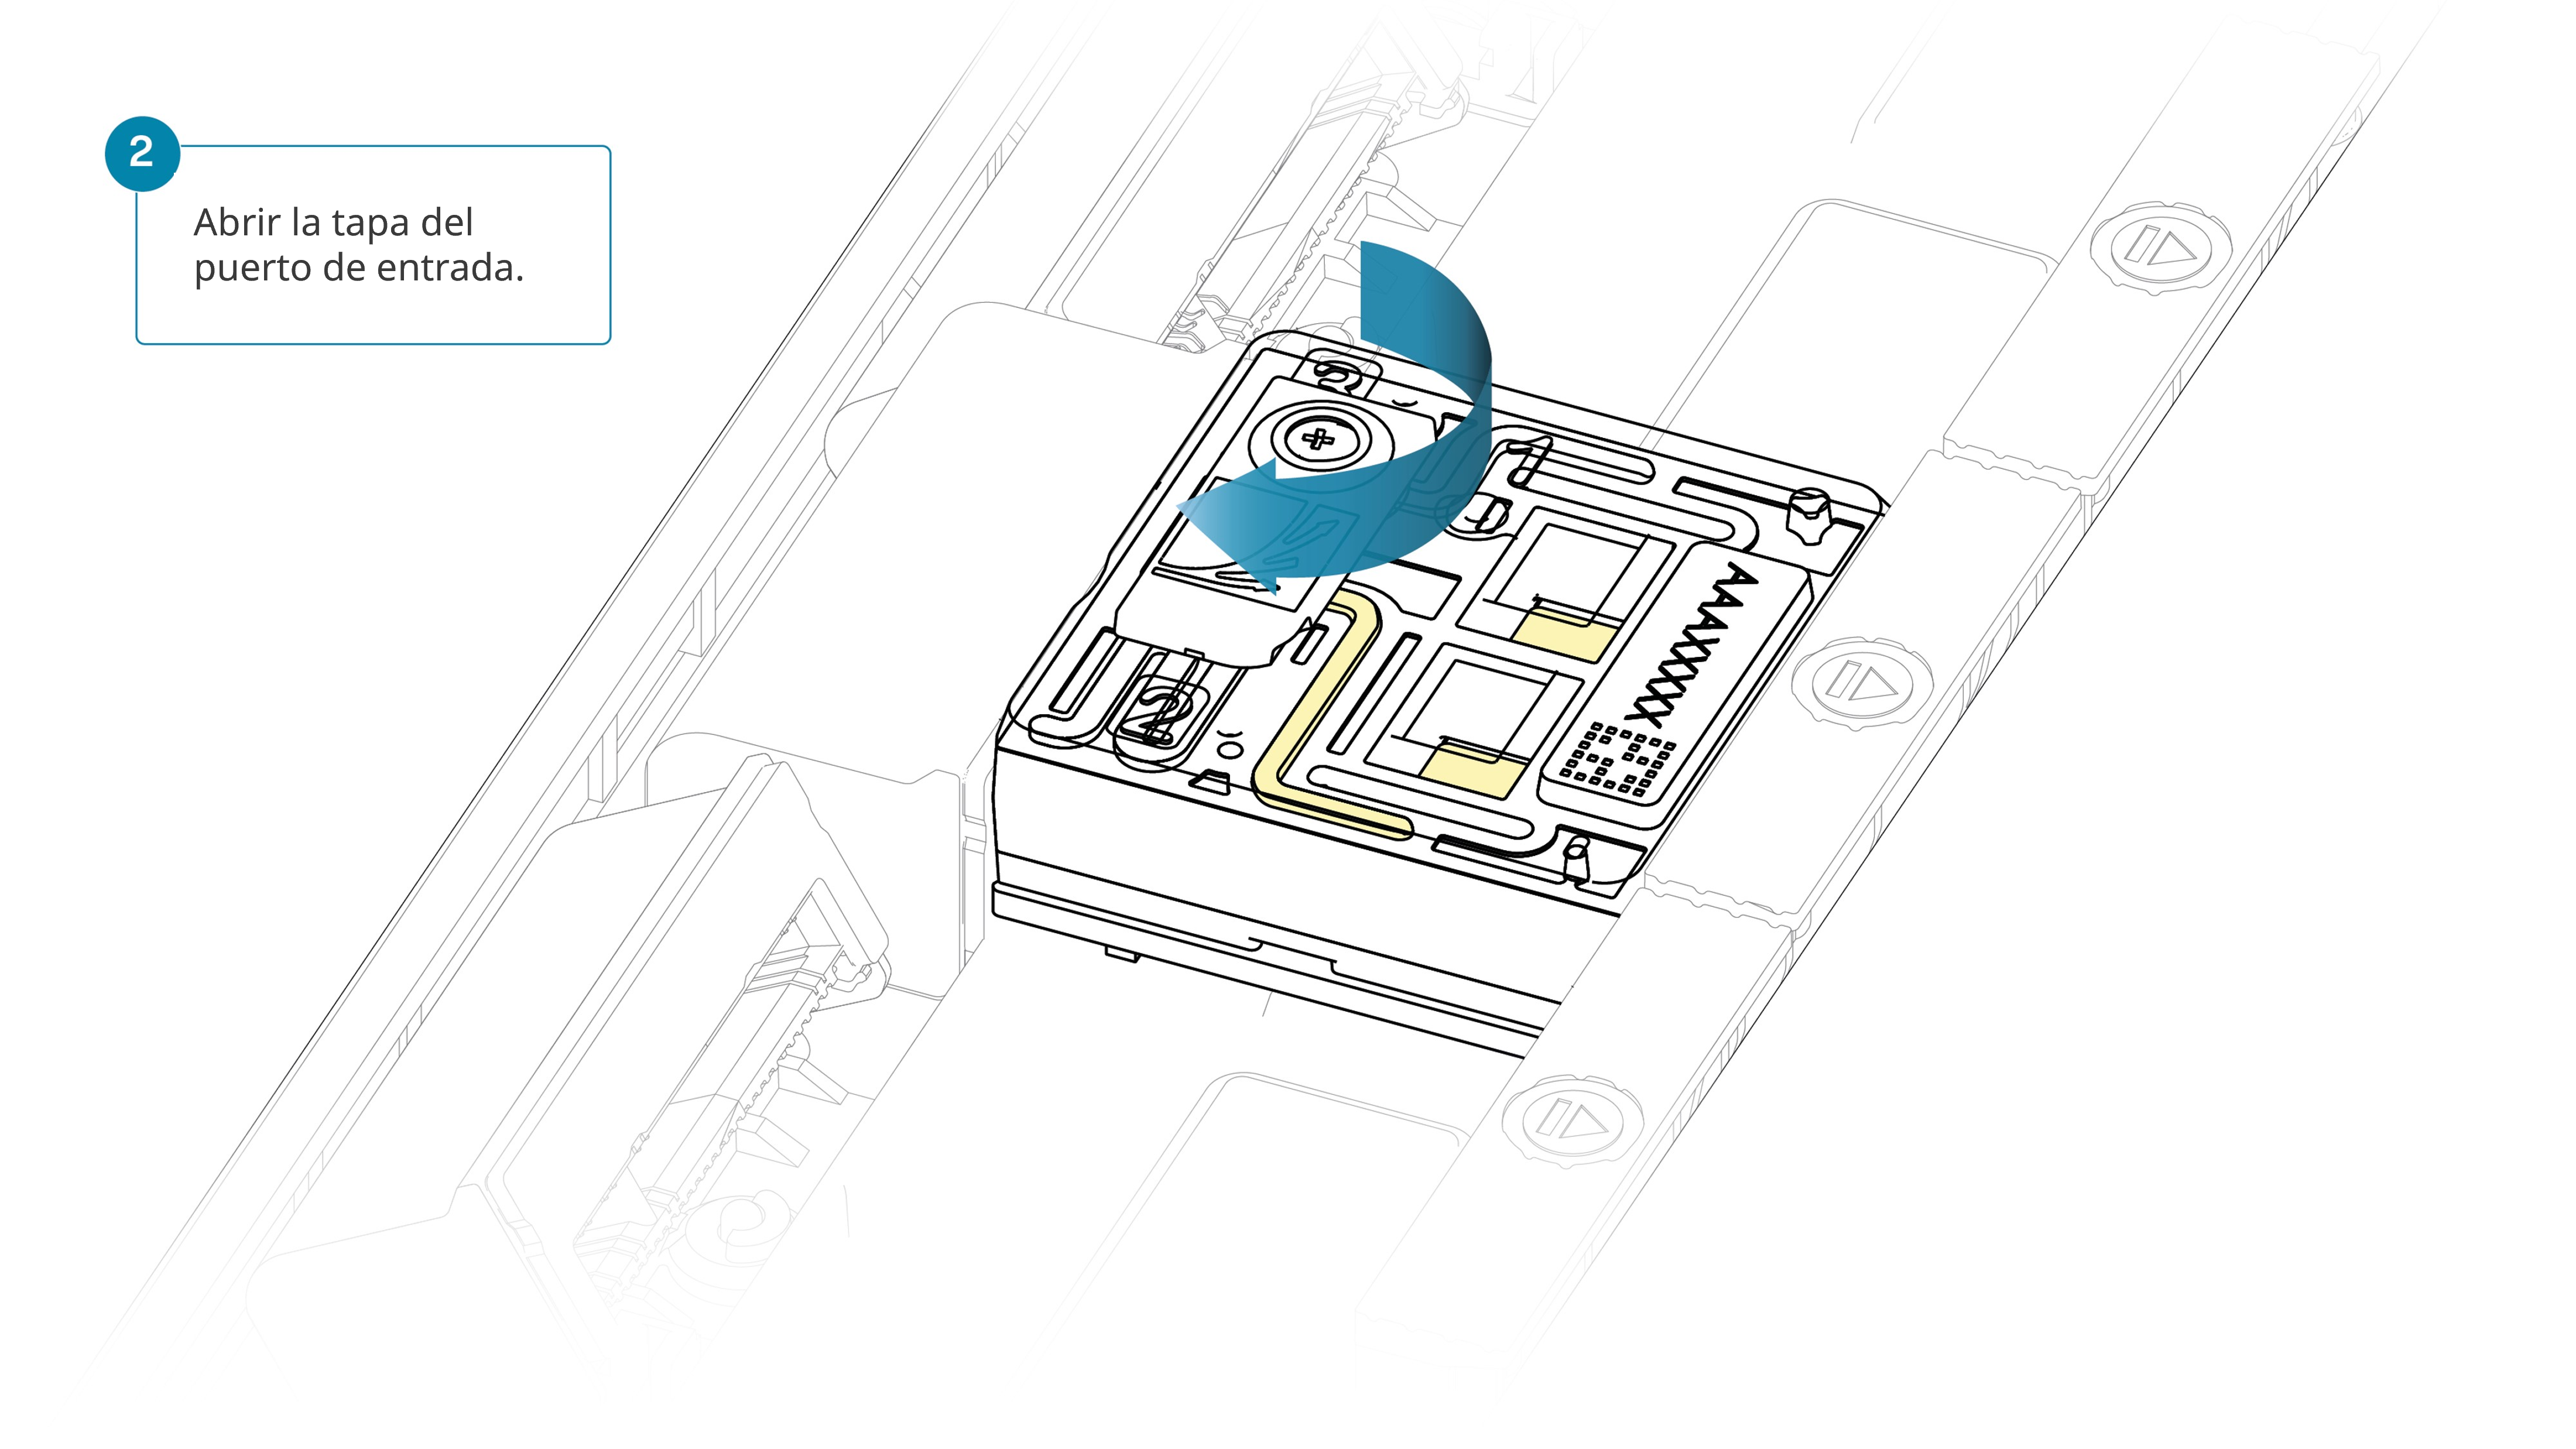
Tenga cuidado al extraer el amortiguador. No aspirar más de 20-30 μl y comprobar que cubra la matriz de poros en todo momento. La introducción de burbujas de aire en la matriz daña los poros de manera irreversible.
Tras abrir el puerto de entrada, comprobar si hay una pequeña burbuja bajo la tapa. Extraer una pequeña cantidad de líquido a fin de eliminar posibles burbujas:
- Ajustar una pipeta P1000 a 200 μl.
- Introducir la punta en el puerto de entrada.
- Girar la rueda hasta que el indicador de volumen marque 220-230 μl o hasta que se pueda ver un poco de amortiguador entrar en la punta de la pipeta.
Cargar 200 μl de mezcla de lavado por el puerto de entrada, de la siguiente manera:
- Con una pipeta P1000, extraer 200 µl de mezcla de lavado.
- Comprobar que no haya burbujas de aire e introducir la punta de la pipeta en el puerto de entrada.
- Girar la rueda de la pipeta (si dispone de ella) o empujar el émbolo muy despacio, dejando una pequeña cantidad de amortiguador en la punta.
- Programar el temporizador e incubar durante 5 minutos.
Acabado el tiempo, cargar los 200 μl de mezcla de lavado restante en el puerto de entrada, con cuidado y de la siguiente manera:
- Con una pipeta P1000, extraer 200 µl de mezcla de lavado.
- Comprobar que no haya burbujas de aire e introducir la punta de la pipeta en el puerto de entrada.
- Girar la rueda de la pipeta (si dispone de ella) o empujar el émbolo muy despacio, dejando una pequeña cantidad de amortiguador en la punta.
Cerrar el puerto de entrada y esperar 1 hora.
Es fundamental que el puerto de entrada esté cerrado antes de extraer los desechos; de lo contrario, el aire atravesaría la zona de la matriz de sensores, lo que provocaría una pérdida significativa de canales de secuenciación.
Extraer el amortiguador de desecho de la siguiente manera:
- Comprobar que el puerto de entrada esté cerrado.
- Introducir una pipeta P1000 en el puerto de desecho y extraer el amortiguador.
Nota: como el puerto de entrada está cerrado, ningún fluido debe salir del área de la matriz de sensores.
Tras utilizar estos amortiguadores, no es posible comprobar la celda de flujo. Cargue directamente la siguiente biblioteca. En cualquier caso, la siguiente exploración mostrará el número de poros utilizables.
Descongelar los viales Sequencing Buffer (SB), Library Beads (LIB) o Library Solution (LIS), -si se requiere-, Flow Cell Tether (FCT) y un tubo de Flow Cell Flush (FCF) a temperatura ambiente y mezclar en vórtex. Centrifugar brevemente y poner en hielo.
Preparar la mezcla de acondicionamiento en un tubo adecuado al número de celdas de flujo que se vayan a purgar. Una vez añadidos, mezclar bien con un breve vórtex.
| Reactivos | Volumen por celda de flujo |
|---|---|
| Flow Cell Flush (FCF) | 1 170 µl |
| Flow Cell Tether (FCT) | 30 µl |
| Volumen total | 1 200 µl |
Abrir la tapa del puerto de entrada deslizándola en el sentido de las agujas del reloj.
Tenga cuidado al extraer el amortiguador. No aspire más de 20-30 μl y compruebe que cubra la matriz de poros en todo momento. La introducción de burbujas de aire en la matriz daña los poros de manera irreversible.
Tras abrir el puerto de entrada, aspirar un pequeño volumen y extraer así cualquier burbuja:
- Ajustar una pipeta P1000 a 200 μl.
- Introducir la punta en el puerto de entrada.
- Girar la rueda hasta que el indicador de volumen marque 220-230 μl o hasta que se vea una pequeña cantidad entrar en la punta.
Cargar 500 μl de mezcla de acondicionamiento por el puerto de entrada, de la siguiente manera:
- Con una pipeta P1000, extraer 500 µl de la mezcla.
- Comprobar que no haya burbujas de aire e introducir la punta de la pipeta en el puerto de entrada.
- Girar la rueda de la pipeta (si dispone de ella) o empujar el émbolo muy despacio, dejando una pequeña cantidad de amortiguador en la punta.
Es esencial esperar cinco minutos entre los purgados con mezcla de acondicionamiento para garantizar la eliminación eficaz de la nucleasa.
Cerrar el puerto de entrada y esperar cinco minutos.
Mientras tanto, preparar la biblioteca siguiendo los siguientes pasos.
Mezclar minuciosamente con la pipeta el contenido del vial Library Beads (LIB).
El vial Library Beads (LIB) contiene microesferas en suspensión que sedimentan muy rápido; por eso es crucial mezclarlas justo antes de su uso.
Recomendamos utilizar Library Beads (LIB) en la mayoría de experimentos de secuenciación. No obstante, con bibliotecas más viscosas recomendamos utilizar Library Solution (LIS).
En un tubo Eppendorf DNA LoBind de 1,5 ml preparar la biblioteca de la siguiente manera:
| Reactivos | Volumen por celda de flujo |
|---|---|
| Sequencing Buffer (SB) | 100 µl |
| Library Beads (LIB) bien mezclado antes de su uso o Library Solution (LIS) | 68 µl |
| Biblioteca de ADN | 32 µl |
| Total | 200 µl |
Nota: con el fin de mejorar la cobertura de la matriz de poros, hemos aumentado el volumen de carga de la biblioteca.
Es fundamental que el puerto de entrada esté cerrado antes de extraer los desechos; de lo contrario, el aire atravesaría la zona de la matriz de sensores, lo que provocaría una pérdida significativa de canales de secuenciación.
Extraer el amortiguador de desecho de la siguiente manera:
- Comprobar que el puerto de entrada esté cerrado.
- Introducir una pipeta P1000 en el puerto de desecho y extraer el amortiguador.
Nota: como el puerto de entrada está cerrado, ningún fluido debe salir del área de la matriz de sensores.
Abrir la tapa del puerto de entrada deslizándola en el sentido de las agujas del reloj.
Tenga cuidado al extraer el amortiguador. No aspire más de 20-30 μl y compruebe que el amortiguador cubra la matriz de poros en todo momento. La introducción de burbujas de aire en la matriz daña los poros de manera irreversible.
Tras abrir el puerto de entrada, aspirar un pequeño volumen y extraer así cualquier burbuja:
- Ajustar una pipeta P1000 a 200 μl.
- Introducir la punta en el puerto de entrada.
- Girar la rueda hasta que el indicador de volumen marque 220-230 μl o hasta que se vea una pequeña cantidad entrar en la punta.
Cargar 500 μl de mezcla de acondicionamiento por el puerto de entrada, de la siguiente manera:
- Con una pipeta P1000, extraer 500 µl de mezcla de acondicionamiento.
- Comprobar que no haya burbujas de aire e introducir la punta en el puerto de entrada.
- Girar la rueda de la pipeta (si dispone de ella) o empujar el émbolo muy despacio, dejando una pequeña cantidad de amortiguador en la punta.
Es fundamental que el puerto de entrada esté cerrado antes de extraer los desechos; de lo contrario, el aire atravesaría la zona de la matriz de sensores, lo que provocaría una pérdida significativa de canales de secuenciación.
Retirar el amortiguador de desecho de la siguiente manera:
- Cerrar el puerto de entrada.
- Insertar una pipeta P1000 en el puerto de desecho y extraer el amortiguador.
Nota: como el orificio de entrada está cerrado, ningún fluido debe salir de la zona de la matriz de sensores.
Abrir la tapa del puerto de entrada deslizándola en el sentido de las agujas del reloj.
Tenga cuidado al extraer el amortiguador. No aspire más de 20-30 μl y compruebe que el amortiguador cubra la matriz de poros en todo momento. La introducción de burbujas de aire en la matriz daña los poros de manera irreversible.
Tras abrir el puerto de entrada, aspirar un pequeño volumen y extraer así cualquier burbuja:
- Ajustar una pipeta P1000 a 200 μl.
- Introducir la punta en el puerto de entrada.
- Girar la rueda hasta que el indicador de volumen marque 220-230 μl o hasta que se vea una pequeña cantidad de amortiguador entrar en la punta.
Mezclar la biblioteca aspirando y dispensando con cuidado antes de cargarla.
Con una pipeta p1000, cargar 200 μl de biblioteca por el puerto de entrada.
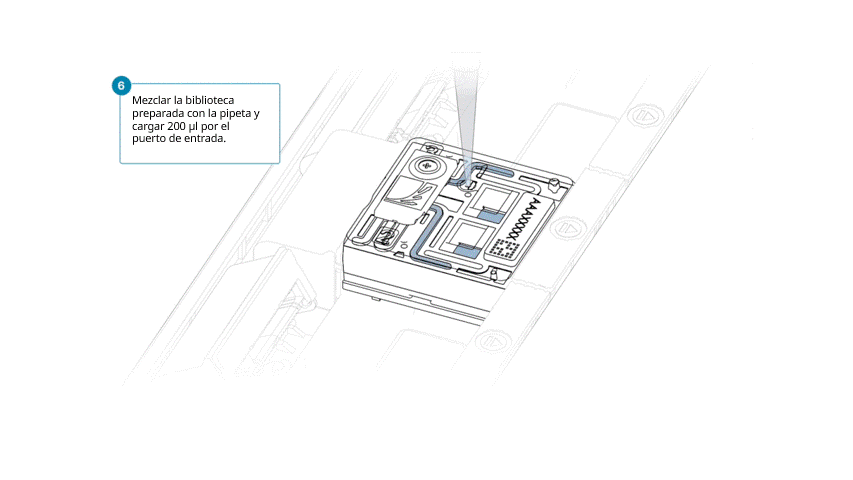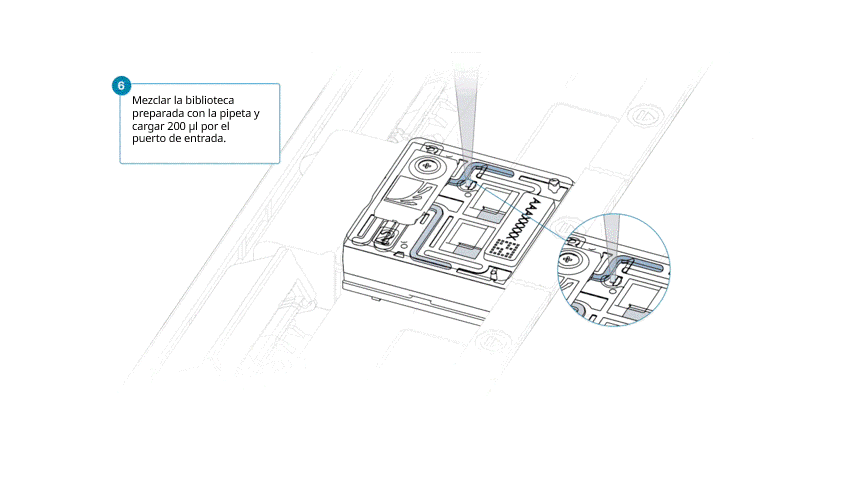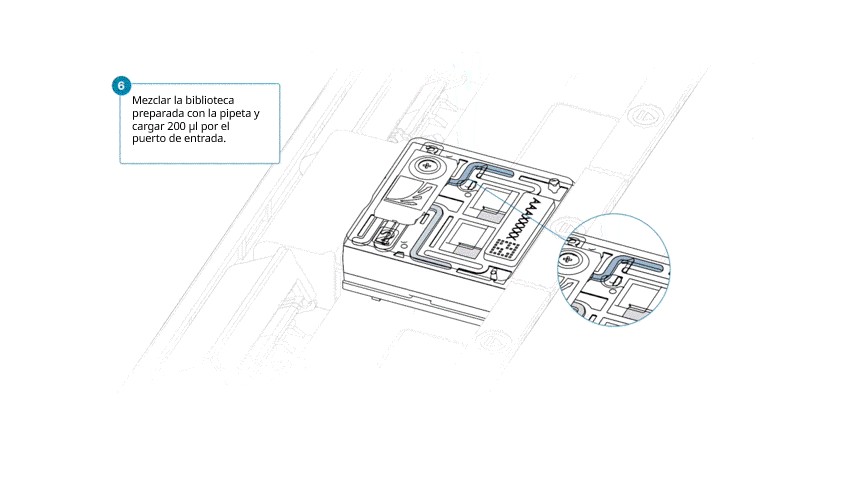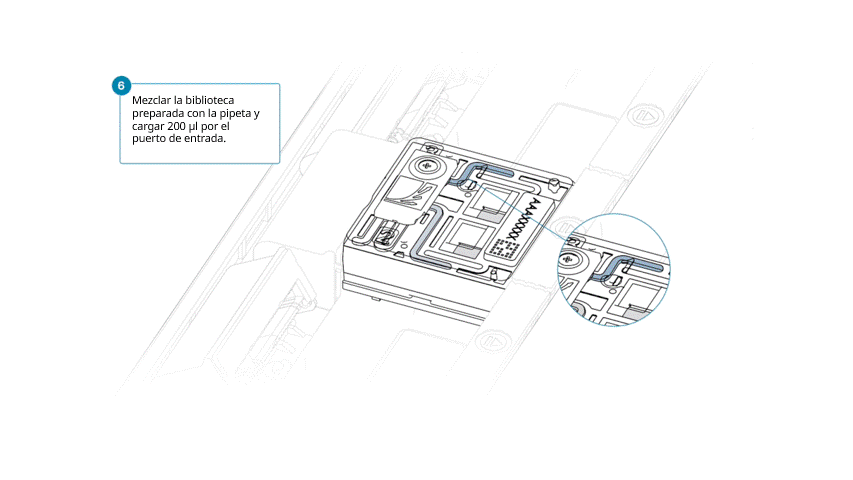
Cerrar la válvula y sellar así el puerto de entrada.
Colocar la pantalla protectora sobre la celda de flujo en cuanto se haya cargado la biblioteca. Así se obtiene un rendimiento de secuenciación óptimo.
Recomendamos no retirarla mientras la biblioteca esté cargada ni durante los lavados o las recargas. Se retira una vez se haya extraído la biblioteca.
Si se ha quitado antes de lo previsto, se coloca de la siguiente manera:
- Alinear la abertura de la pantalla con la tapa del puerto de entrada. El borde delantero de la pieza debe quedar por encima del identificador de la celda de flujo.
- Presionar la pantalla protectora con firmeza alrededor de la tapa del puerto de entrada. Cuando el clip encaje bajo la tapa del mismo, se producirá un clic.
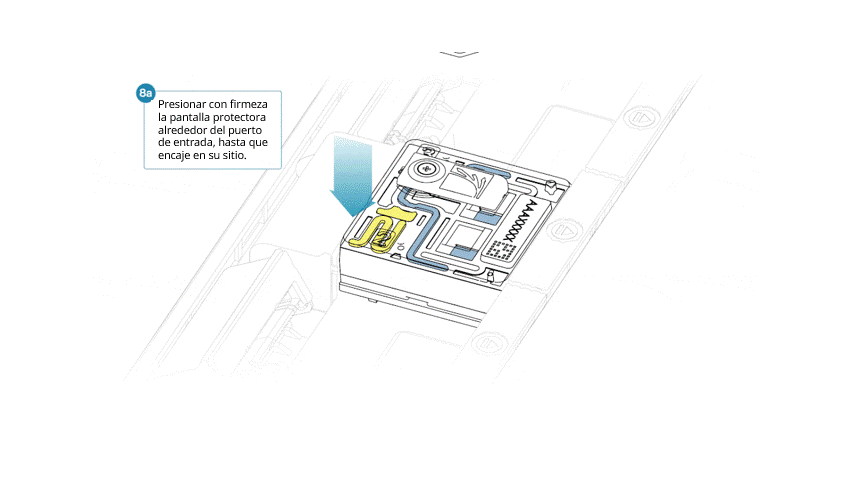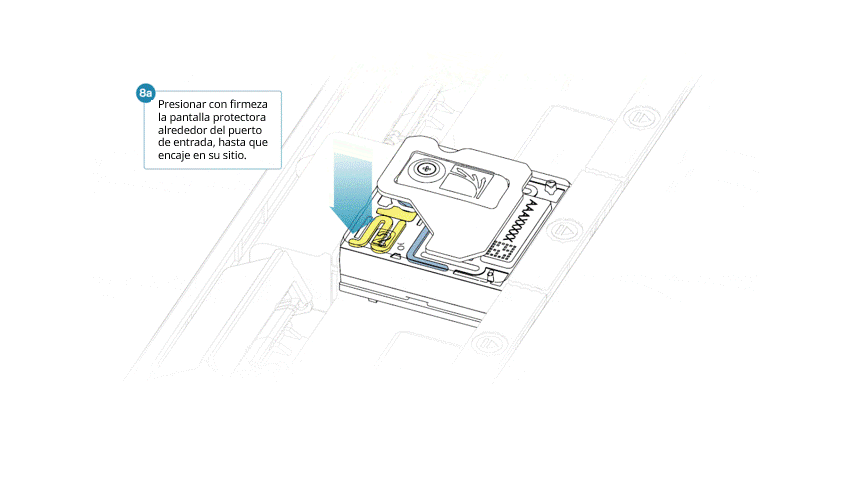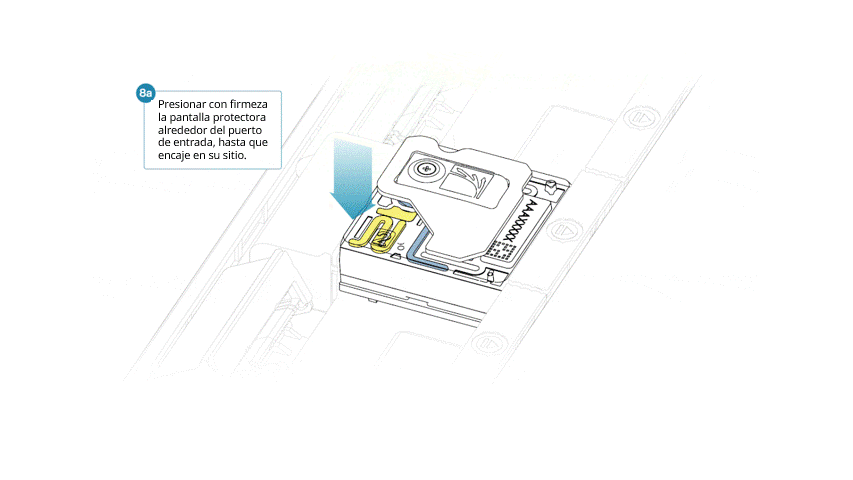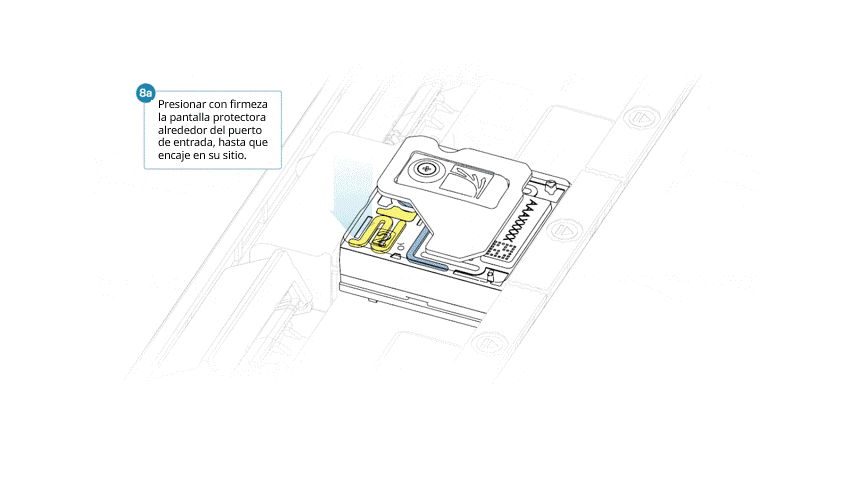
Cuando esté todo listo para empezar un experimento de secuenciación en MinKNOW, cerrar la tapa del PromethION.
Tras cargar las celdas de flujo, esperar al menos 10 minutos antes de iniciar; de este modo se contribuye a aumentar el rendimiento de la secuenciación.
9. Adquisición de datos e identificación de bases
Cómo empezar a secuenciar
El programa MinKNOW se encarga de la gestión del dispositivo, la adquisición de datos y la identificación de bases en tiempo real.
Con dispositivos P2 Solo o P24/48, recomendamos identificar las bases en tiempo real con el modo de gran precisión HAC y seleccionar BAM como formato de salida.
Es preciso generar archivos en este formato, ya que es el que requiere el flujo de trabajo wf-human-variation.
Consulte en los enlaces a continuación las instrucciones de configuración del dispositivo y el experimento de secuenciación:
PromethION 24/48: "Iniciar un experimento de secuenciación con PromethION 24/48"
PromethION 2 Solo: "Iniciar un experimento de secuenciación con PromethION 2 Solo"
A continuación indicamos los parámetros de secuenciación recomendados en MinKNOW.
Configuración de MinKNOW de muestra de ADN celular extraído de 15 kb
Con muestras de partida de 15 kb, recomendamos ampliar la duración de la secuenciación a 72 h, con el lavado de la celda de flujo incluido, utilizar la opción de bases modificadas al identificar las bases y seleccionar BAM como formato de salida. Los demás parámetros se dejan en la configuración predeterminada. A continuación presentamos nuestras recomendaciones actuales:
Posiciones
Posición de celda de flujo: [Definida por el usuario]
Nombre del experimento: [definido por el usuario]
Tipo de celda de flujo: FLO-PRO114M
ID de la muestra: [definido por el usuario]
Kit
Selección del kit: Ligation Sequencing Kit (SQK-LSK114)
Configuración del experimento
Secuenciación y análisis
Identificación de bases: Activado [predeterminado] Bases modificadas: Activado, con la opción "Contextos CG 5mC y 5hmC" seleccionada Modelo: Identificación de bases de gran precisión (HAC) [predeterminado]
Adición de códigos de barras: Desactivado [predeterminado]
Alineamiento: Desactivado [predeterminado]
Actualmente no recomendamos realizar el alineamiento en tiempo real durante la secuenciación, ya que ralentiza el procesamiento del sistema.
Muestreo adaptativo: Desactivado [predeterminado]
Opciones avanzadas Selección de canales activos: Activado [predeterminado] Intervalo entre escaneos de poros: 1,5 [predeterminado] Reservar poros: Activado [predeterminado]
Objetivos de datos
Duración máxima de la ejecución: 72 horas [predeterminado]
Archivos de salida
Formato de archivos de salida POD5: Activado [predeterminado] FASTQ: Activado [predeterminado] BAM: Activado
Filtrado: Activado [predeterminado] Puntuación de calidad (Qscore): 9 [predeterminado] Longitud mínima de lectura: 200 bp [predeterminado]
No recomendamos realizar el alineamiento en tiempo real durante la secuenciación, ya que ralentiza el procesamiento del sistema.
Tras la secuenciación, es posible alinear el archivo BAM siguiendo uno de los siguientes métodos:
| Alineamiento del archivo BAM en MinKNOW | Alineamiento del archivo BAM durante el flujo de trabajo de wf-human-variation |
|---|---|
| Alinear el archivo de salida BAM tras la identificación de bases en tiempo real en MinKNOW. Así se evitará ralentizar el procesamiento del sistema. El archivo BAM alineado sirve como archivo de entrada en el flujo de trabajo wf-human-variation. Si se utiliza un archivo de entrada BAM alineado, el flujo de trabajo tardará entre 1 y 2 horas. | También es posible proporcionar un genoma de referencia junto con el archivo BAM sin alinear durante la configuración del flujo de trabajo wf-human-variation. Con un archivo de entrada BAM no alineado, el flujo de trabajo tardará entre 5 y 8 horas. |
Encontrará más información en la sección a continuación.
10. Análisis de datos
Análisis de los datos de secuenciación de ADN obtenido de células humanas
En este tipo de análisis, recomendamos utilizar el flujo de trabajo wf-human-variation, una solución bioinformática completa, desarrollada con el lenguaje de flujos de trabajo Nextflow, que incluye métodos de identificación de polimorfismos de un solo nucleótido (SNP) y variantes estructurales (SV), así como de elaboración de informes sobre la metilación del ADN.
Este flujo de trabajo conviene ejecutarlo desde el archivo BAM, que MinKNOW produce cuando en la identificación de bases se selecciona el modelo de bases modificadas. Si MinKNOW no alinea las lecturas con el genoma de referencia, recomendamos identificar las bases con el flujo de trabajo wf-basecalling. Guarde los resultados en formato BAM mediante la opción --output_bam.
Las siguientes herramientas se utilizan en el flujo bioinformático y se ejecutan de forma independiente o en conjunto:
Sniffles2 identifica variantes estructurales (SV) y genera archivos de salida que incluyen un informe HTML con parámetros de control de calidad, así como un archivo VCF con una lista de variantes y sus índices de calidad.
Clair3 identifica polimorfismos de un solo nucleótido (SNP) y genera archivos de salida que incluyen un informe HTML con parámetros de control de calidad, así como un archivo con una lista de variantes y sus índices de calidad.
modkit extrae la información de metilación del archivo BAM, que el sistema resume en un archivo en formato BEDmetil.
El flujo de trabajo wf-human-variation está preconfigurado con parámetros precisos y solo requiere elegir el genoma de referencia y el modelo Clair3. Encontrará más información en la documentación del proyecto.
Los resultados del flujo de trabajo wf-human-variation se estudian más a fondo en un navegador genómico con visualización por pistas, como IGV y se evalúan mediante un programa de análisis terciario que determina si presentan una patogenicidad conocida.
Análisis bioinformático en EPI2ME
El flujo de trabajo wf-human-variation se ejecuta con el programa Nextflow.
Recomendamos realizar el análisis con EPI2ME, ya que facilita los análisis bioinformáticos al permitir la ejecución de flujos de trabajo de Nextflow desde la interfaz gráfica de usuario (GUI). EPI2ME contiene un conjunto de flujos de trabajo bioinformáticos, seleccionados y revisados de forma continua por expertos en análisis de lecturas largas, que es posible consultar en este enlace.
Si es la primera vez que usa esta interfaz, en la guía de inicio rápido se explica cómo utilizarla.
Requisitos de ejecución del flujo de trabajo wf-human-variation en EPI2ME
| Requisitos recomendados | Requisitos mínimos |
|---|---|
| CPU = 32 | CPU = 16 |
| Memoria = 128 GB | Memoria = 32 GB |
Tiempo de ejecución aproximado: Variable en función de si se trata de secuenciación dirigida o secuenciación del genoma completo, así como de la cobertura y los distintos análisis solicitados. Por ejemplo, el análisis de una muestra humana con una cobertura de 90× (opciones: --snp --sv --mod --str --cnv --phased --sex male) tarda menos de 8 h con los recursos recomendados.
Compatibilidad con procesadores ARM: Falso
El flujo de trabajo wf-human-variation también se ejecuta desde la interfaz de la línea de comandos (CLI)
Encontrará más información en la página de Github.
Nota: recomendamos utilizar la línea de comandos (CLI) solo a usuarios experimentados.
Abrir la aplicación EPI2ME con el atajo de escritorio.
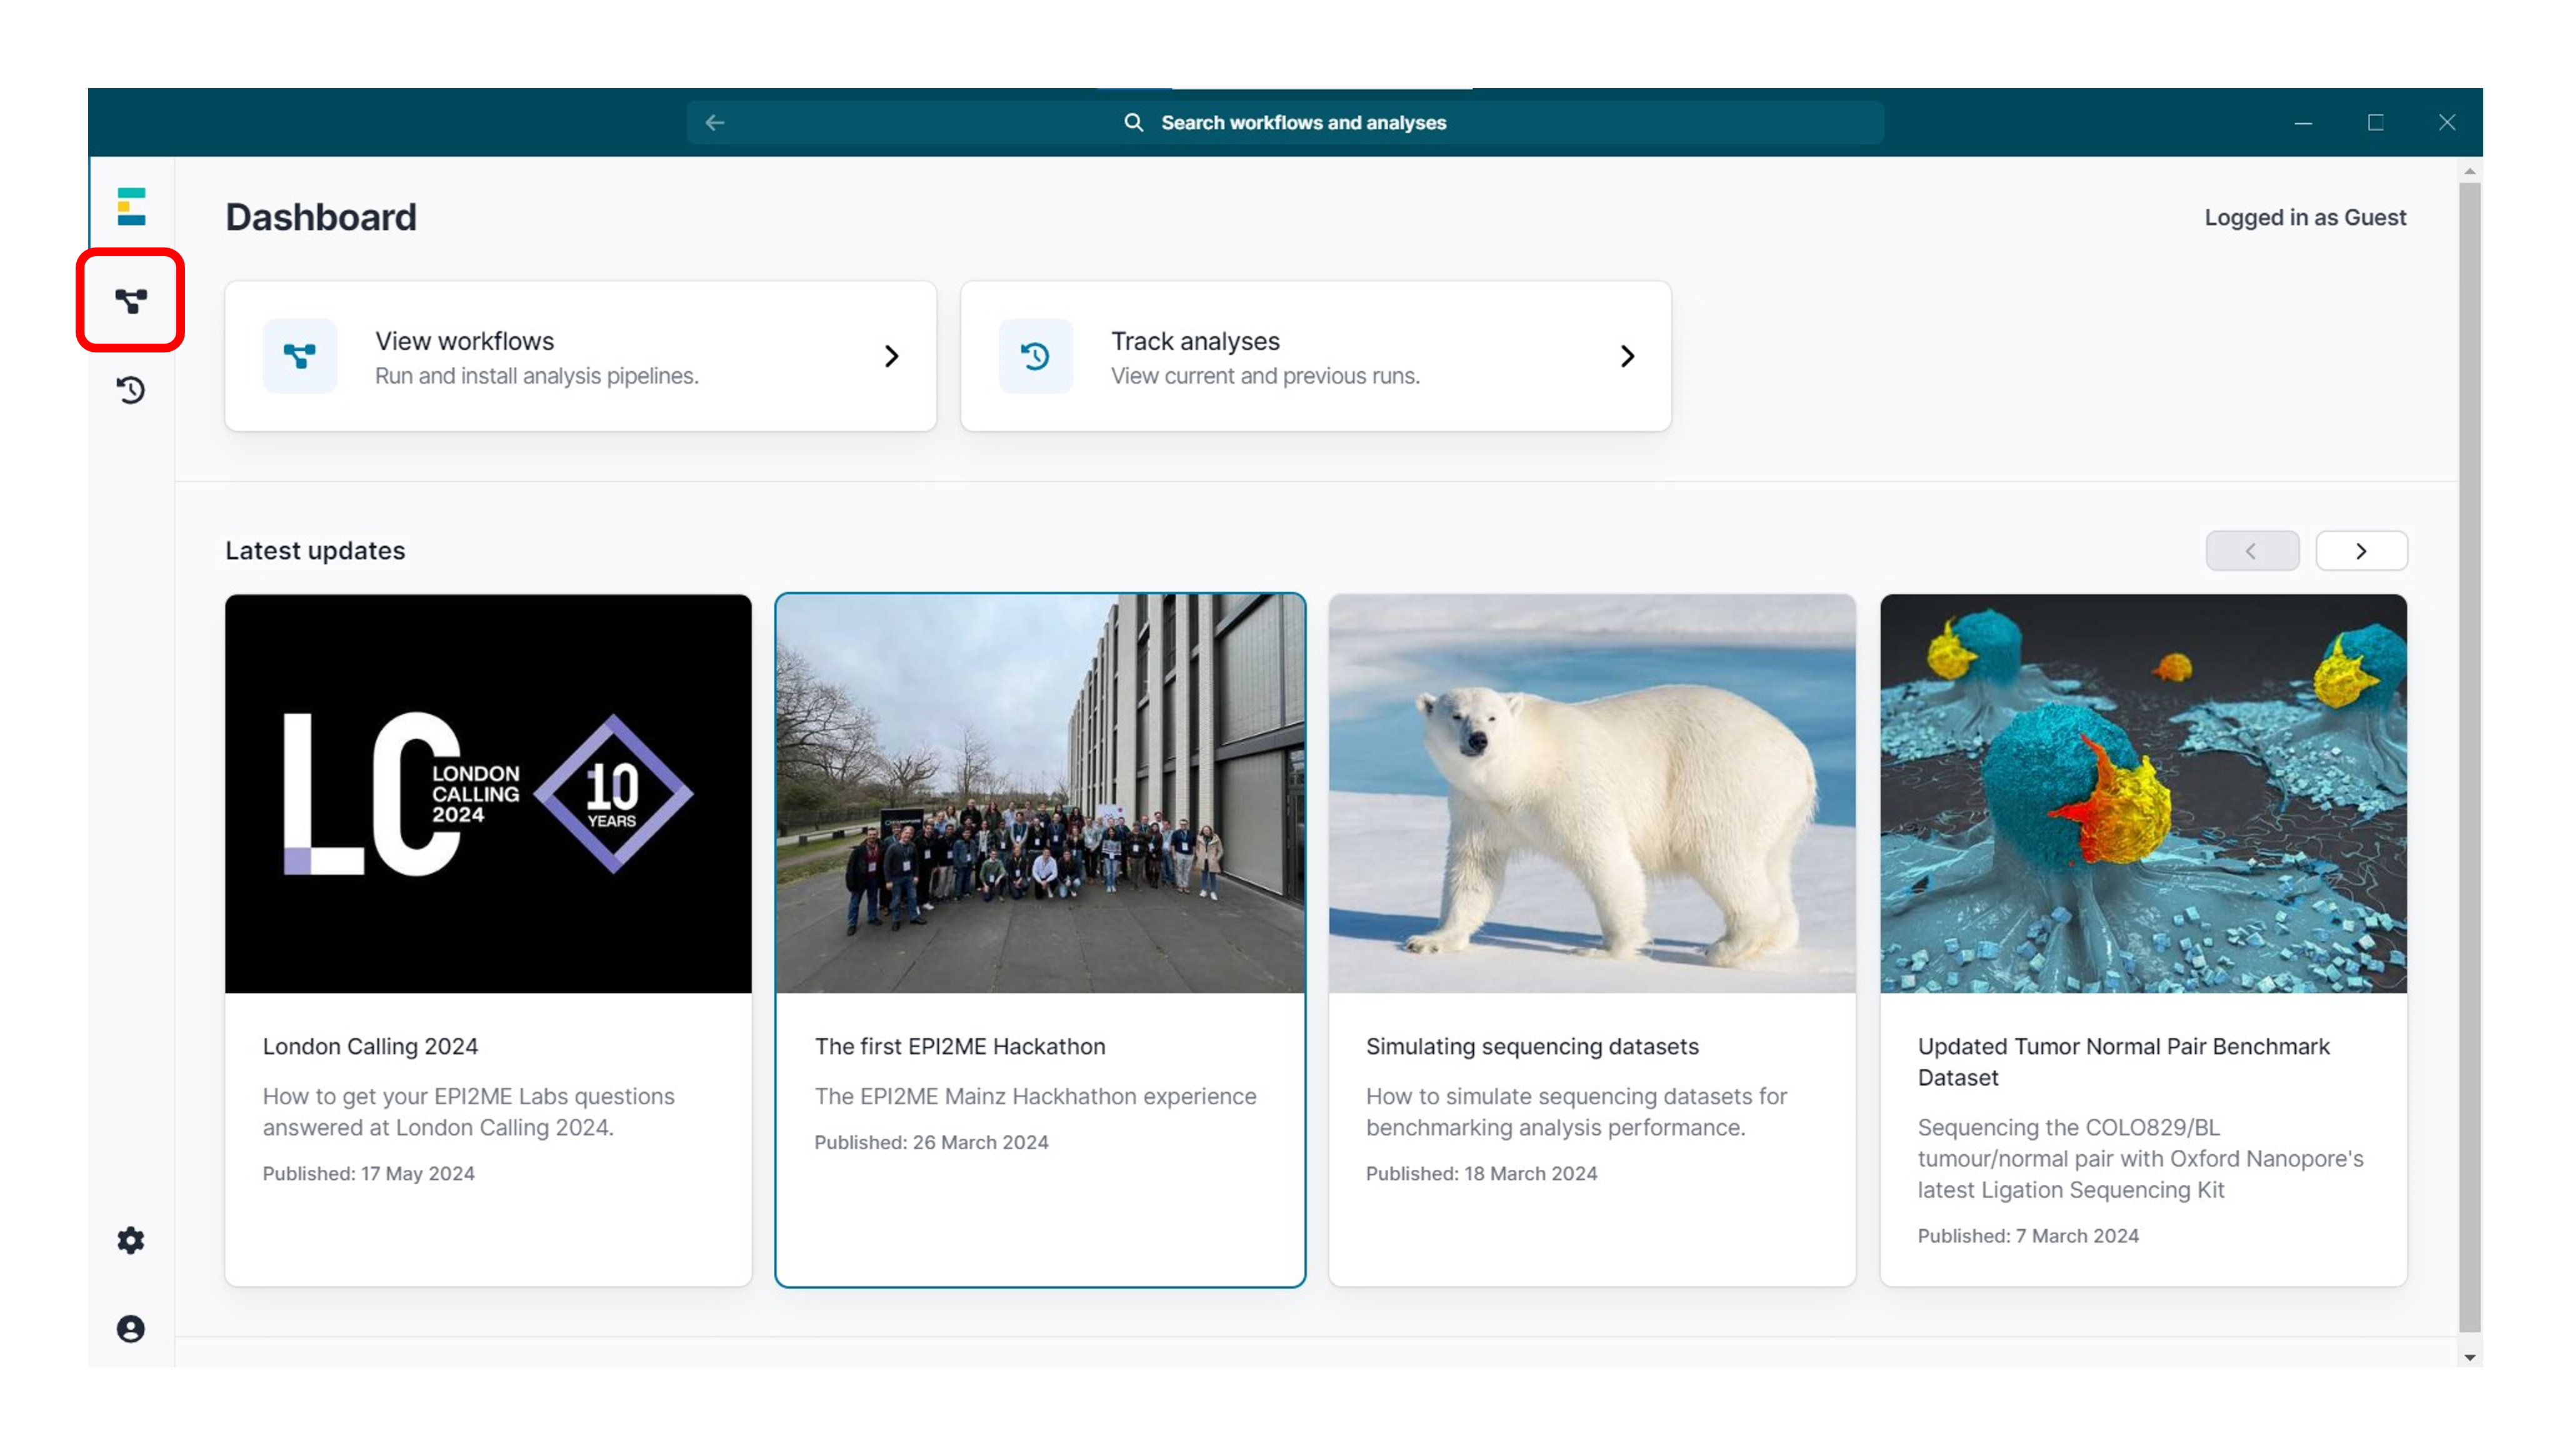
En la página de inicio, abrir la pestaña de flujos de trabajo en la barra lateral izquierda.
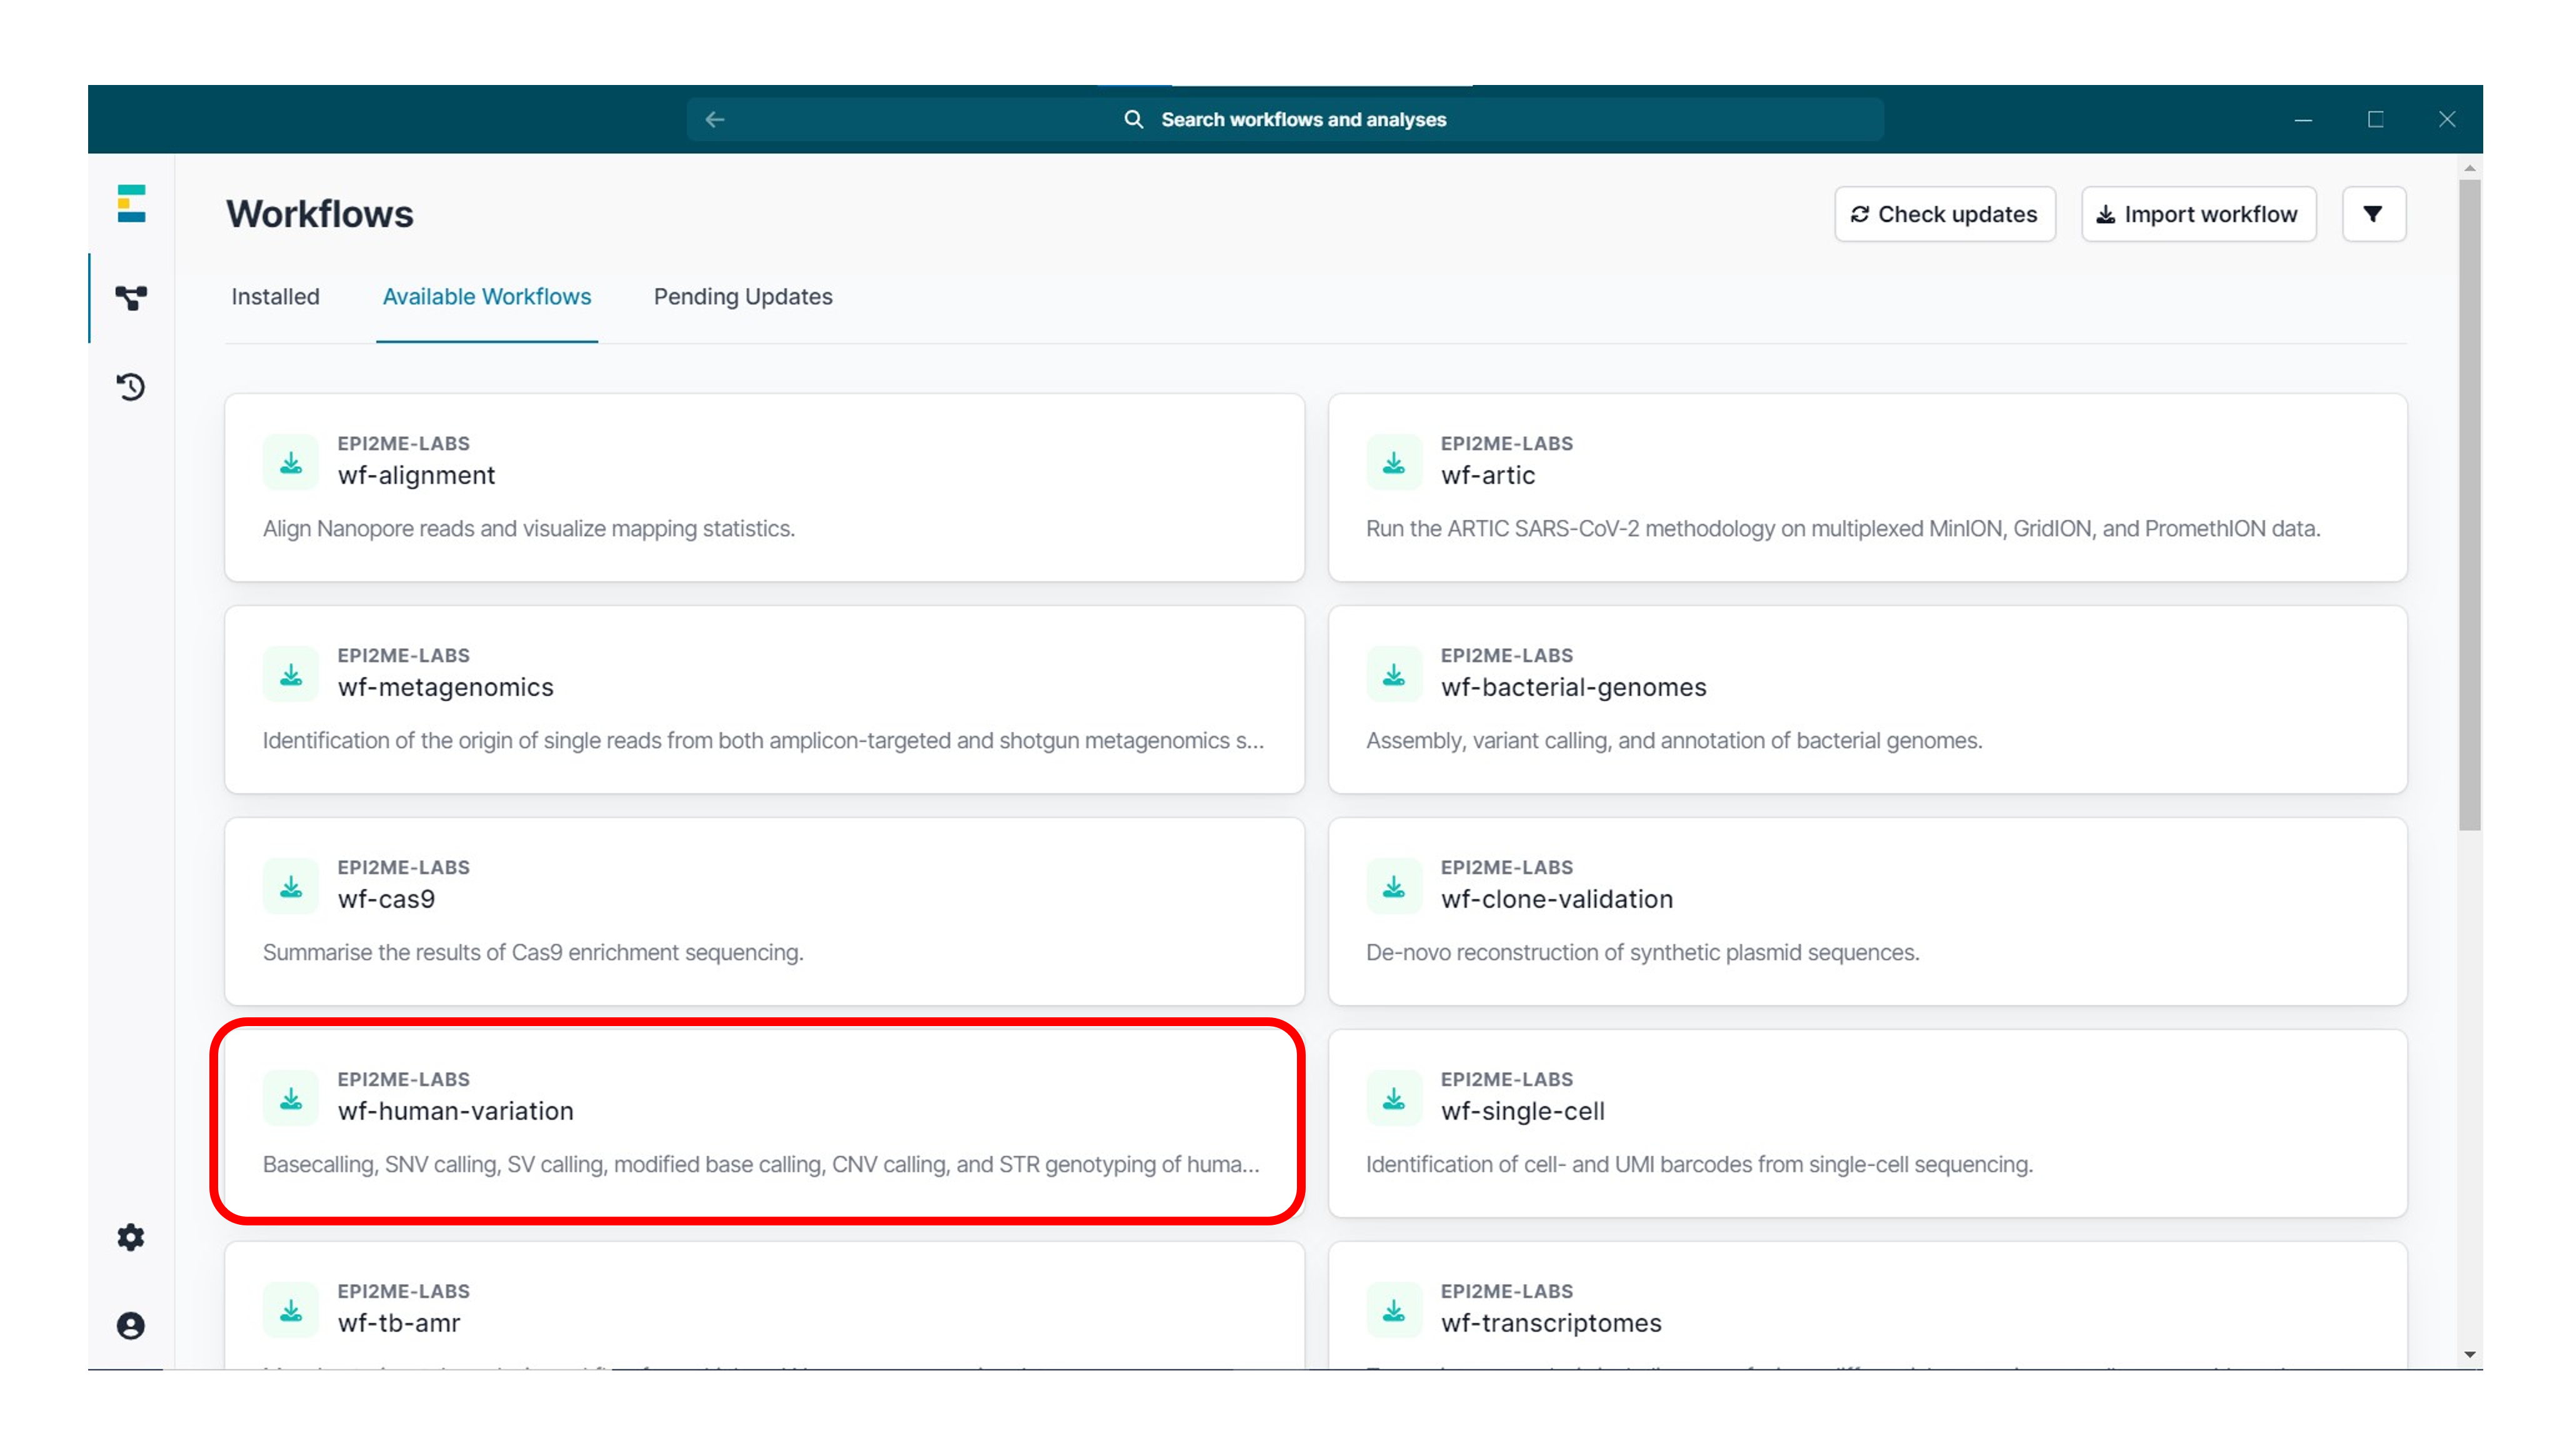
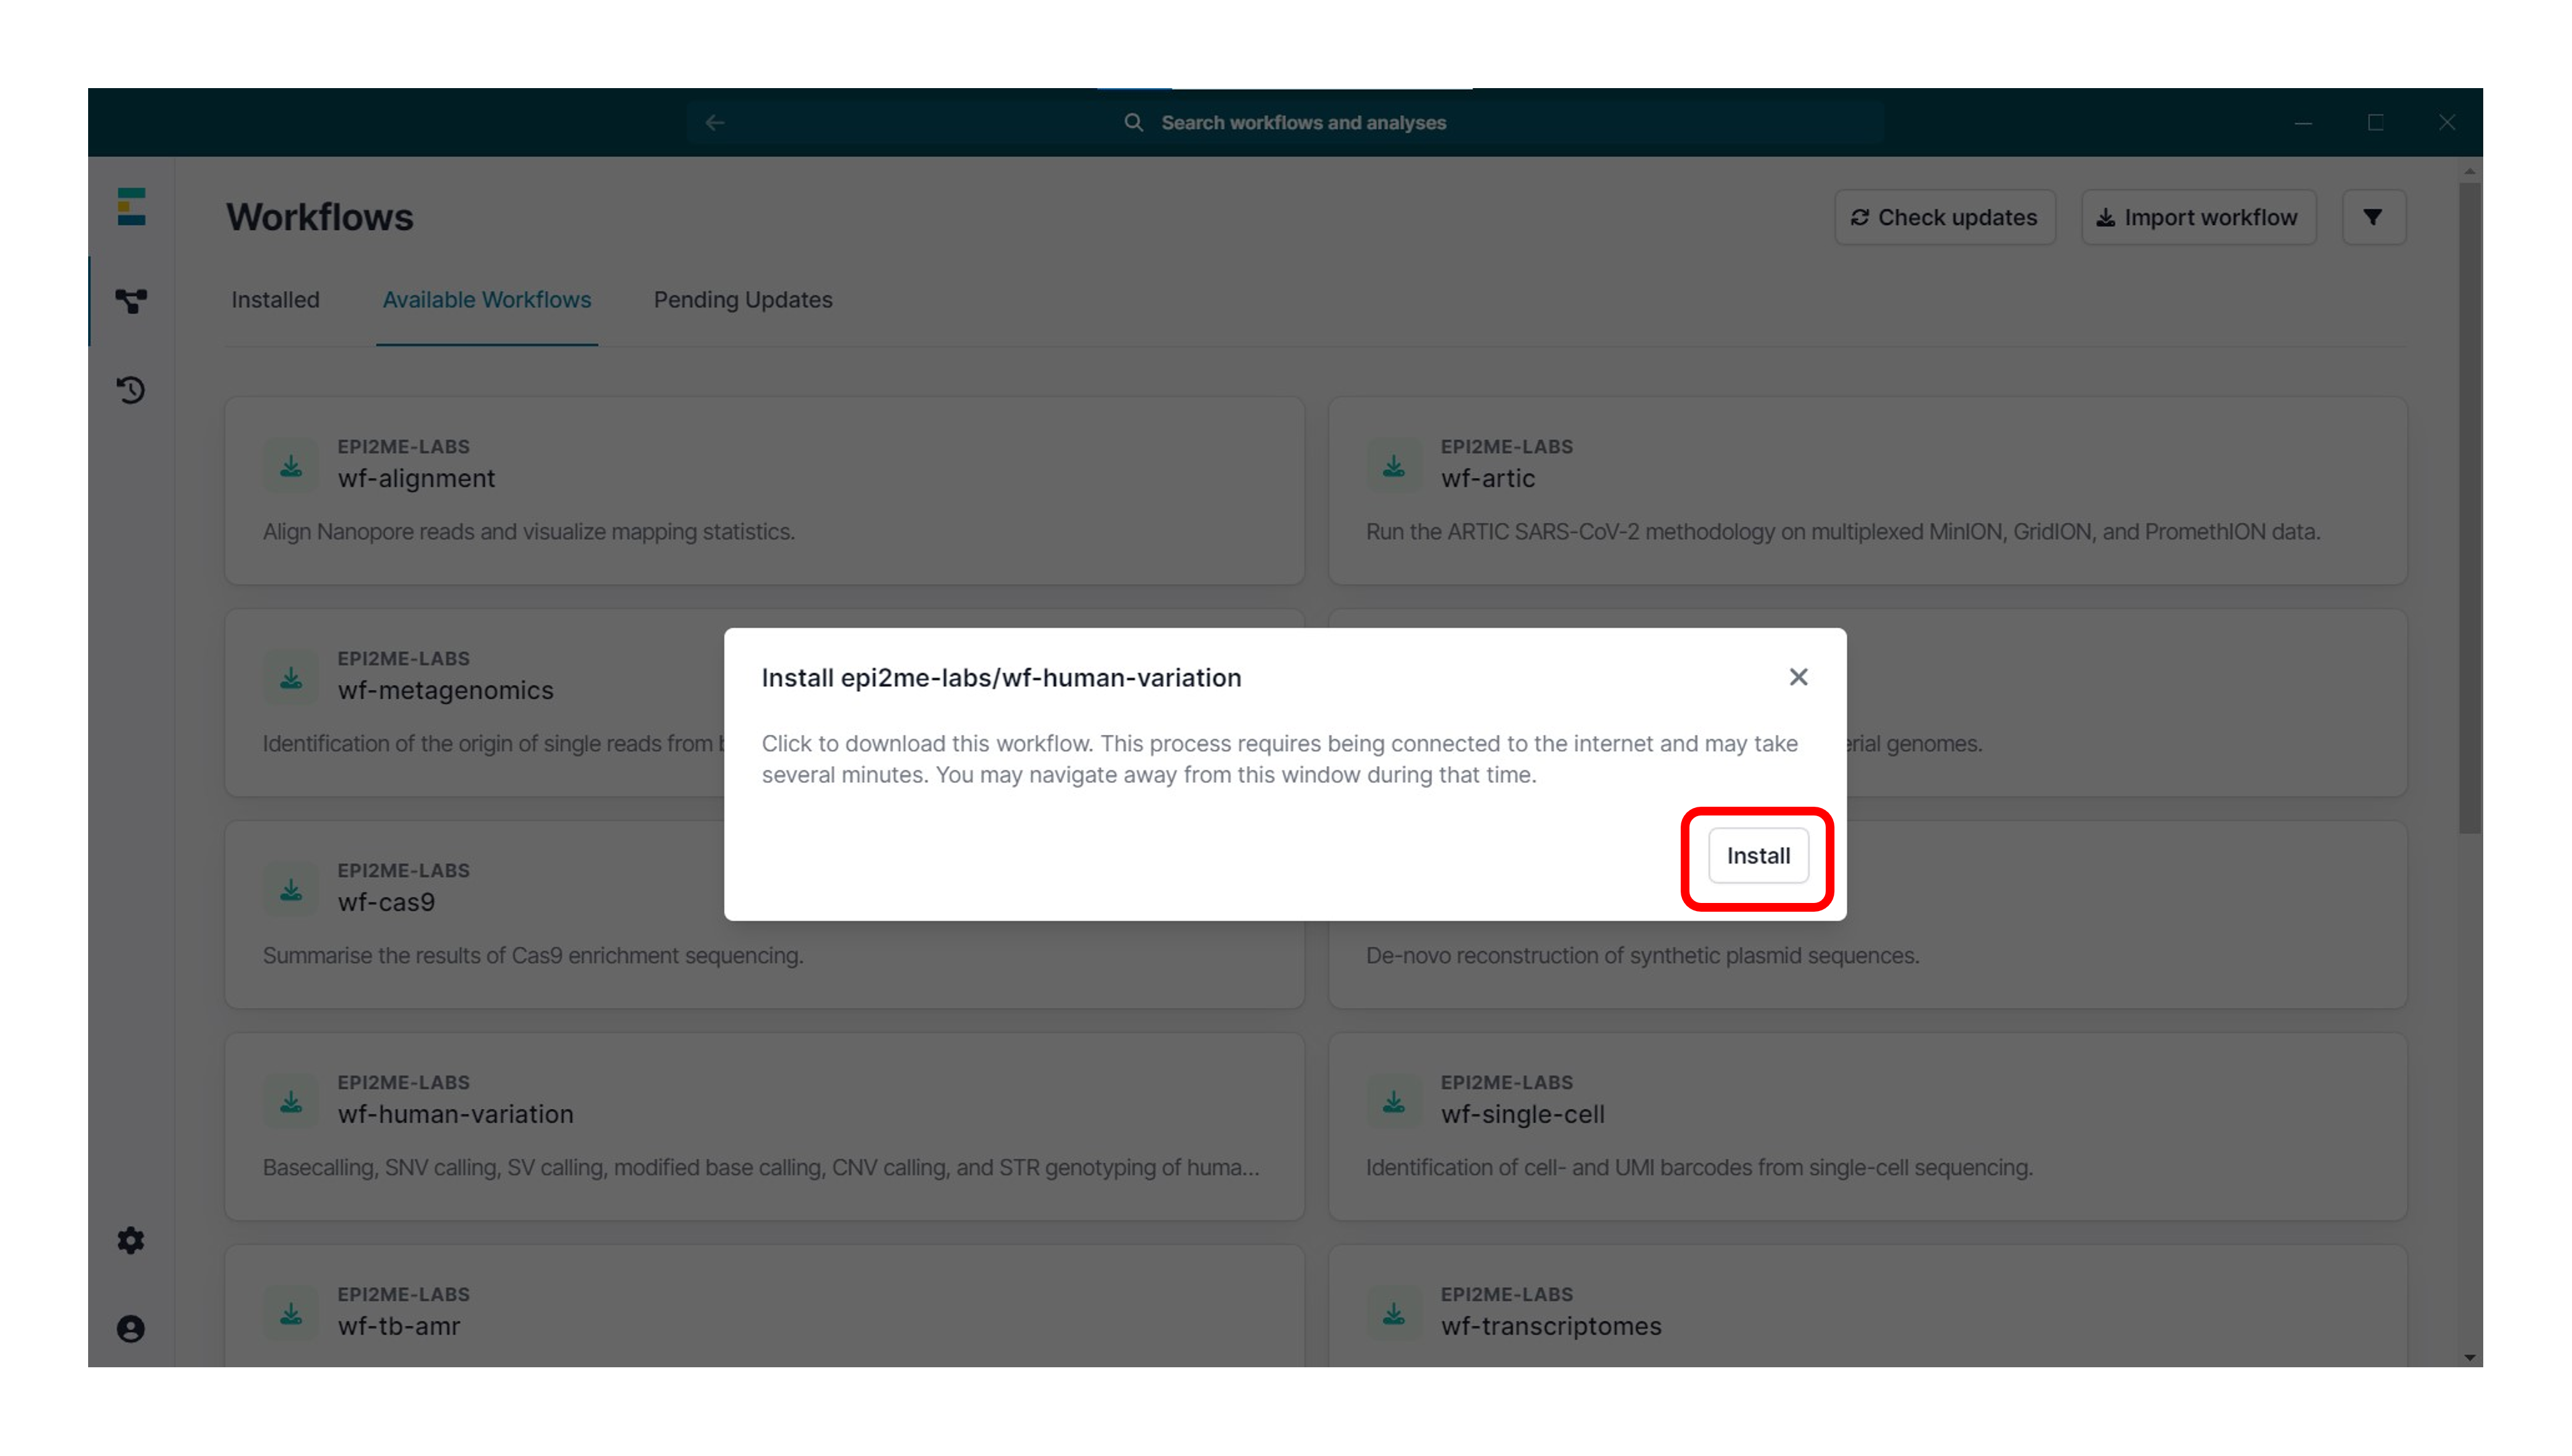
Abrir la pestaña Flujos de trabajo disponibles y pulsar en la opción wf-human-variation.
Pulsar Instalar.
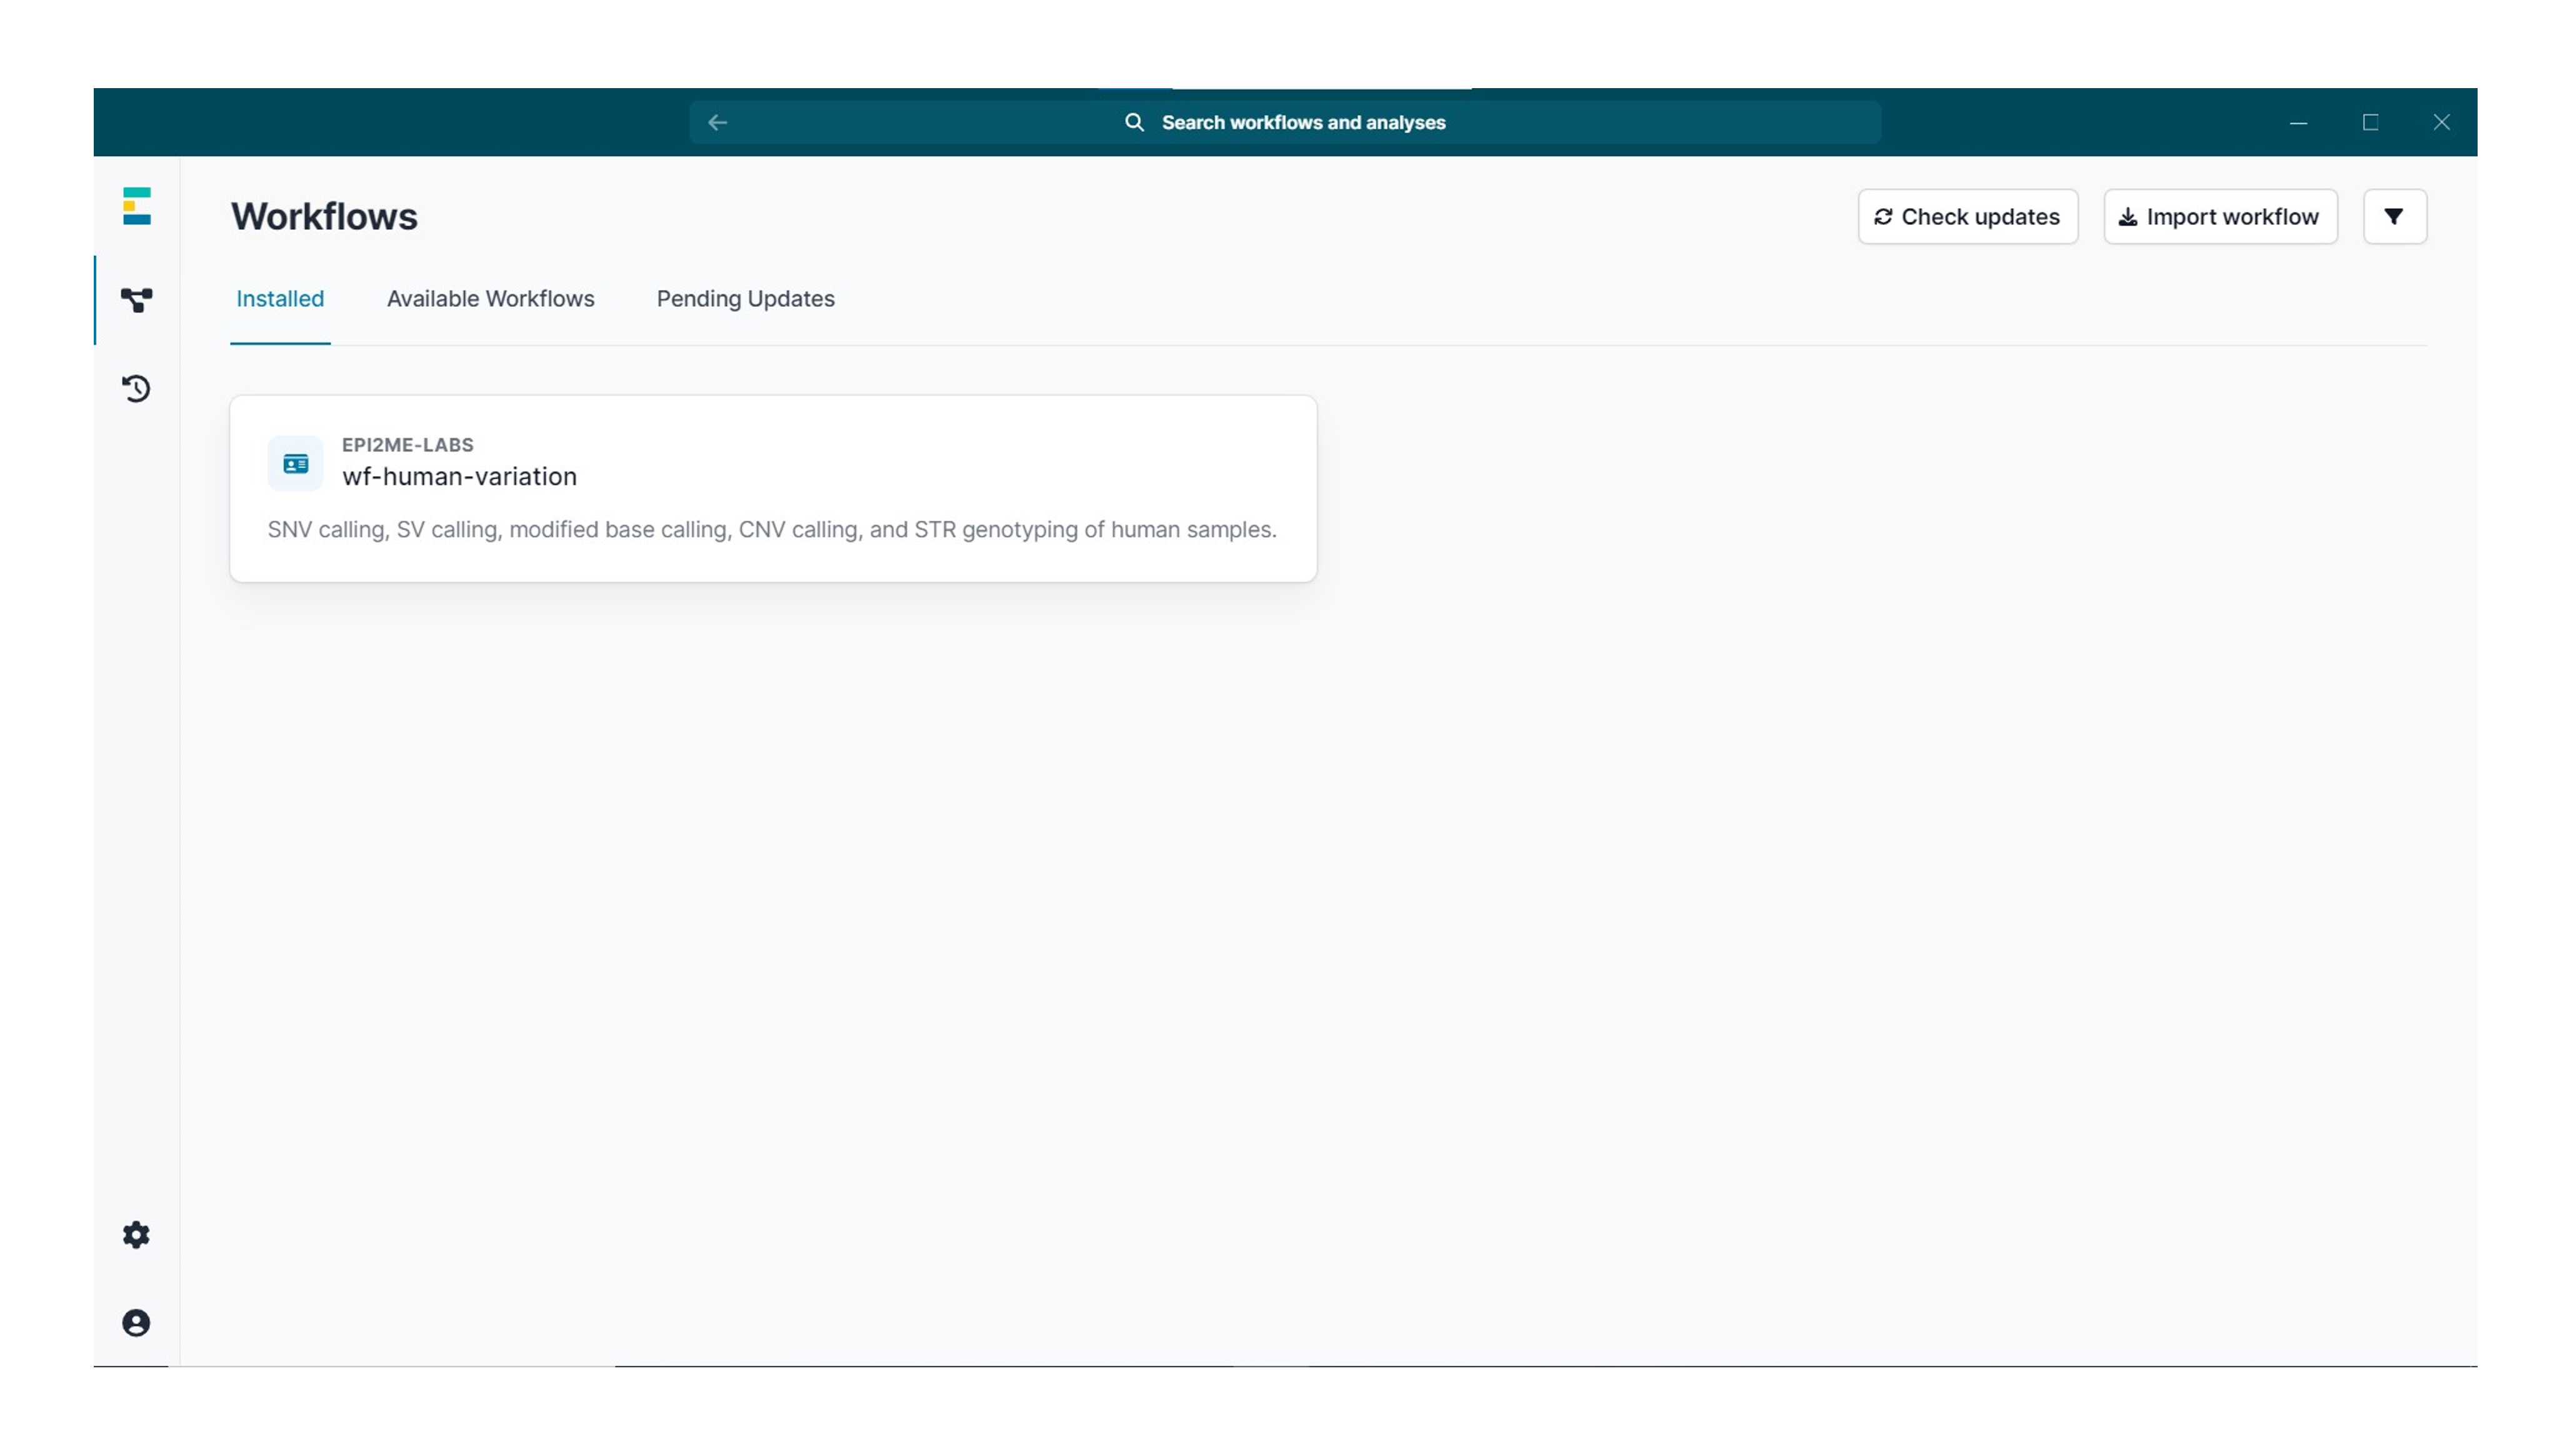
Ir la pestaña Flujos de trabajo instalados y pulsar en el flujo de trabajo wf-human-variation.
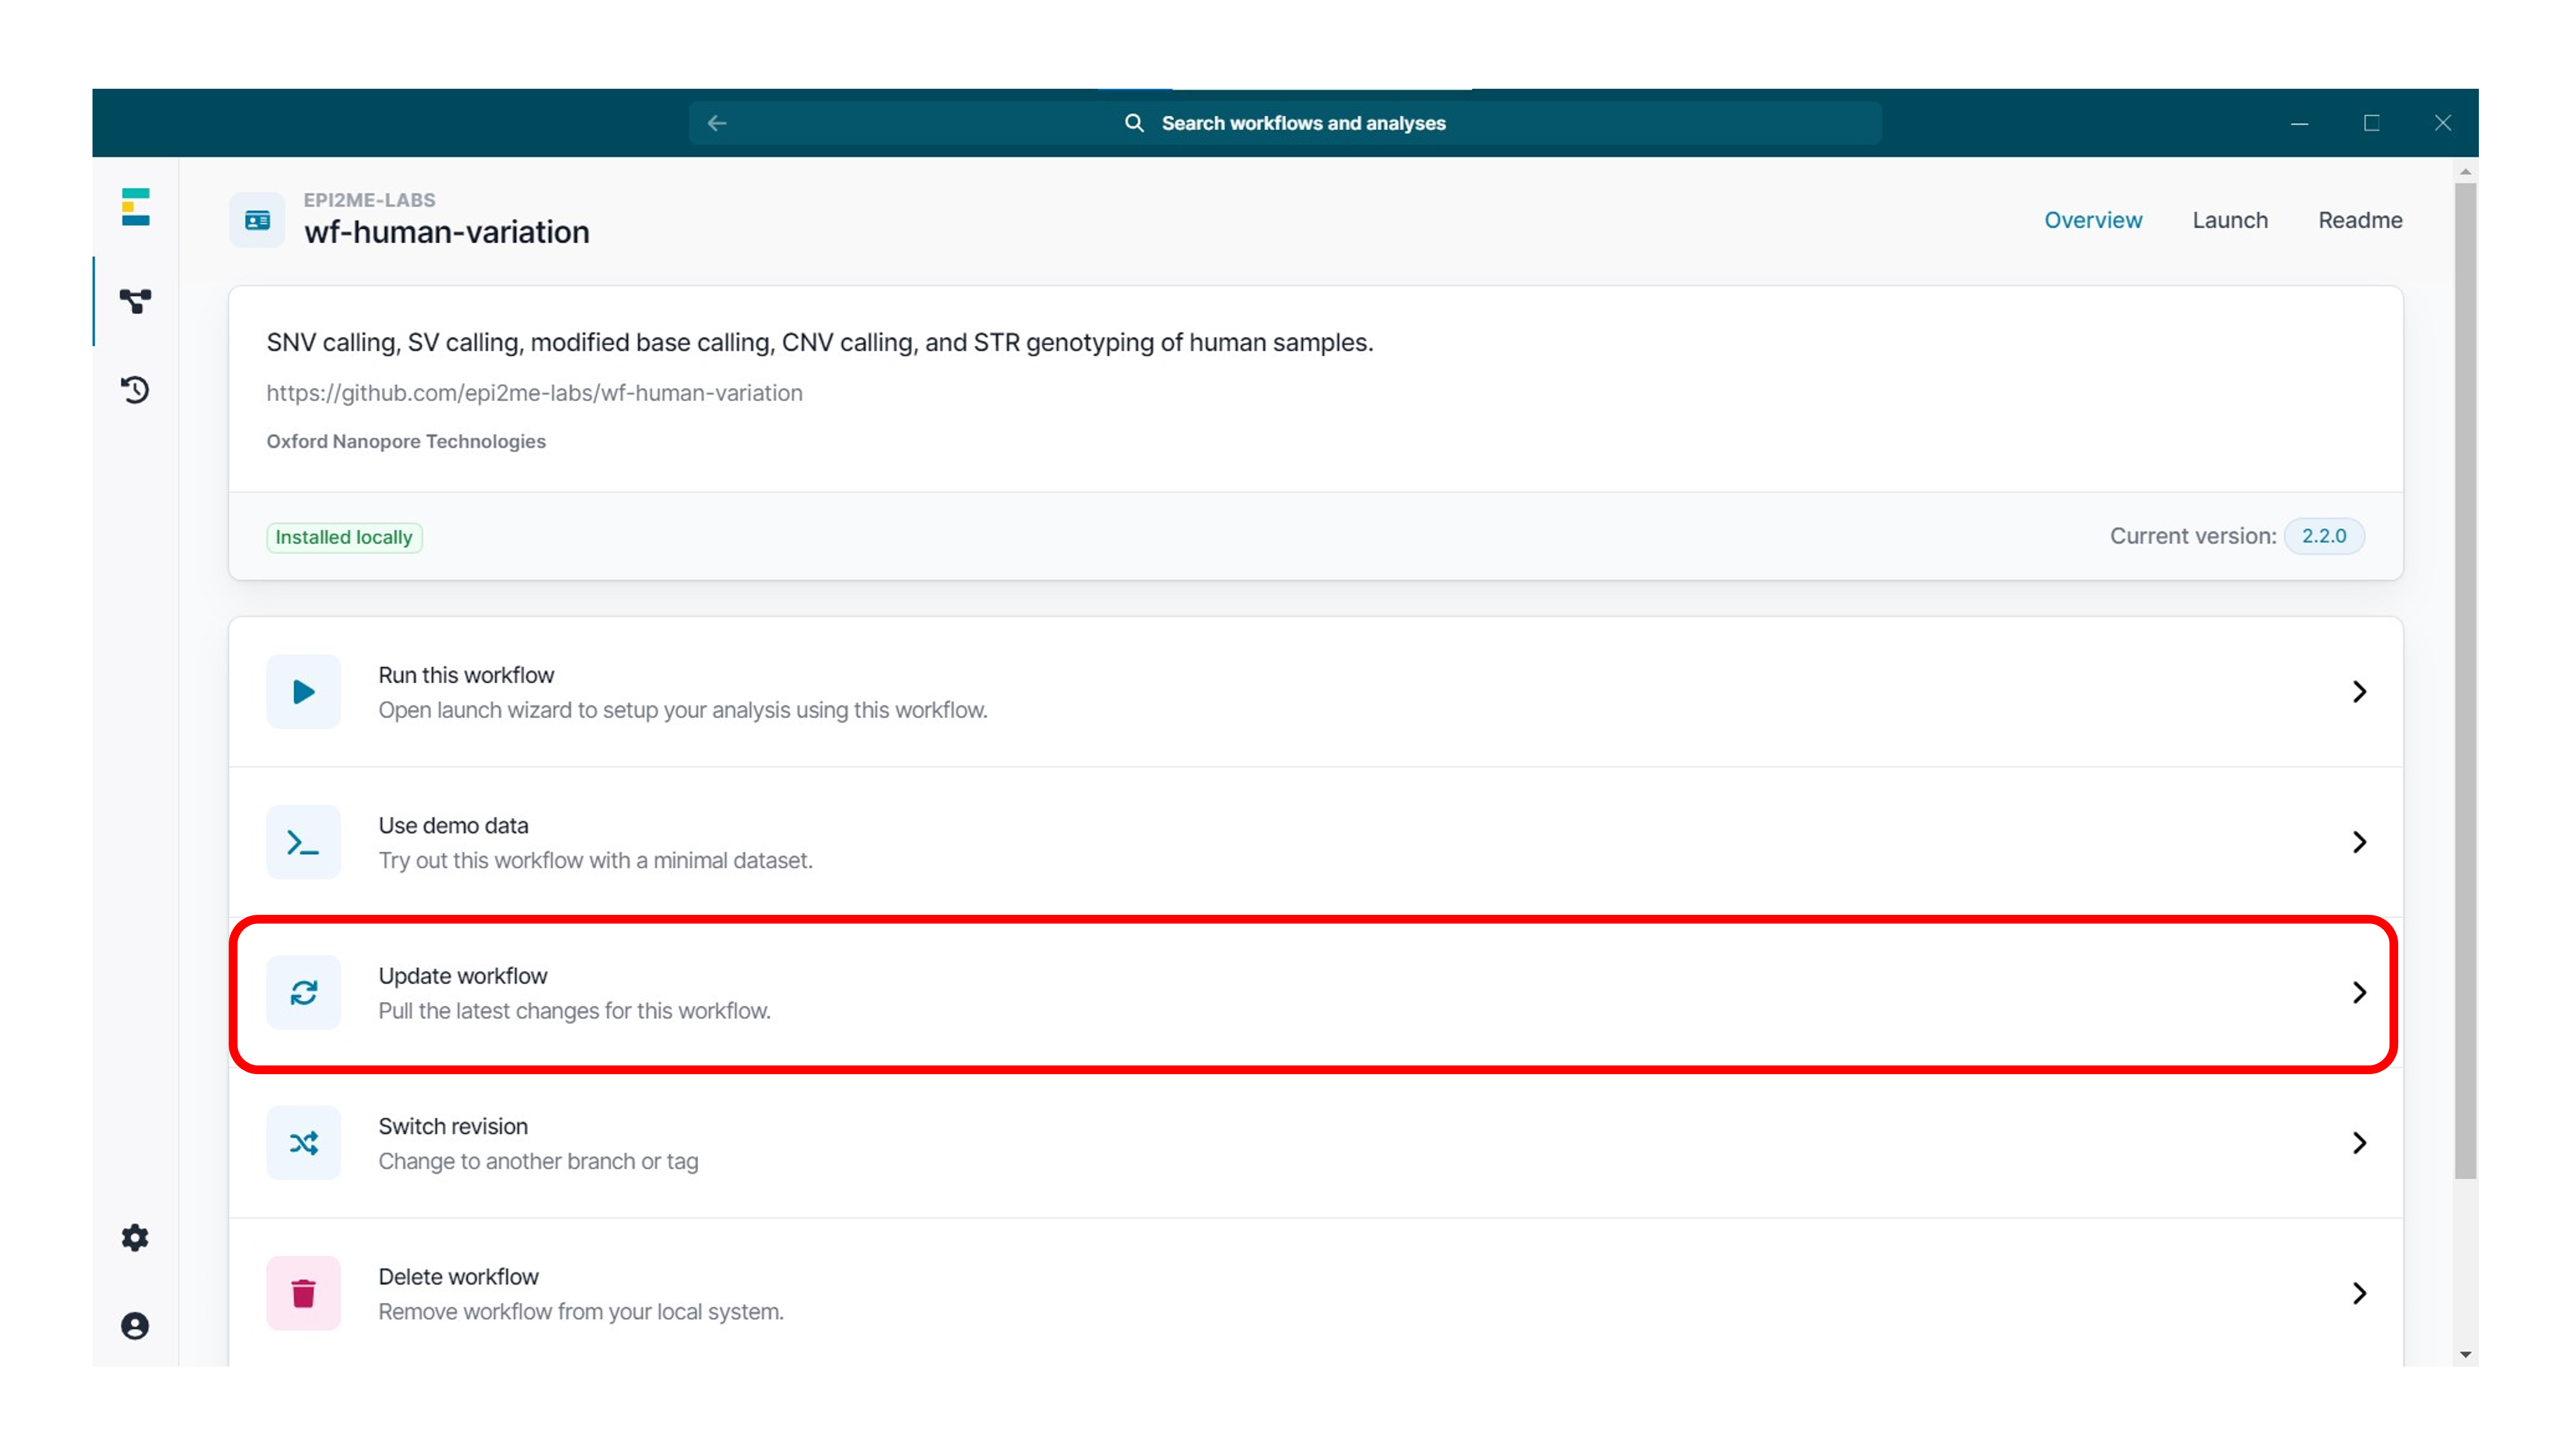
Si el flujo de trabajo ya está instalado, comprobar si hay actualizaciones pulsando en "Actualizar el flujo de trabajo".
Recomendamos utilizar la versión más reciente, ya que ofrece mejores resultados.
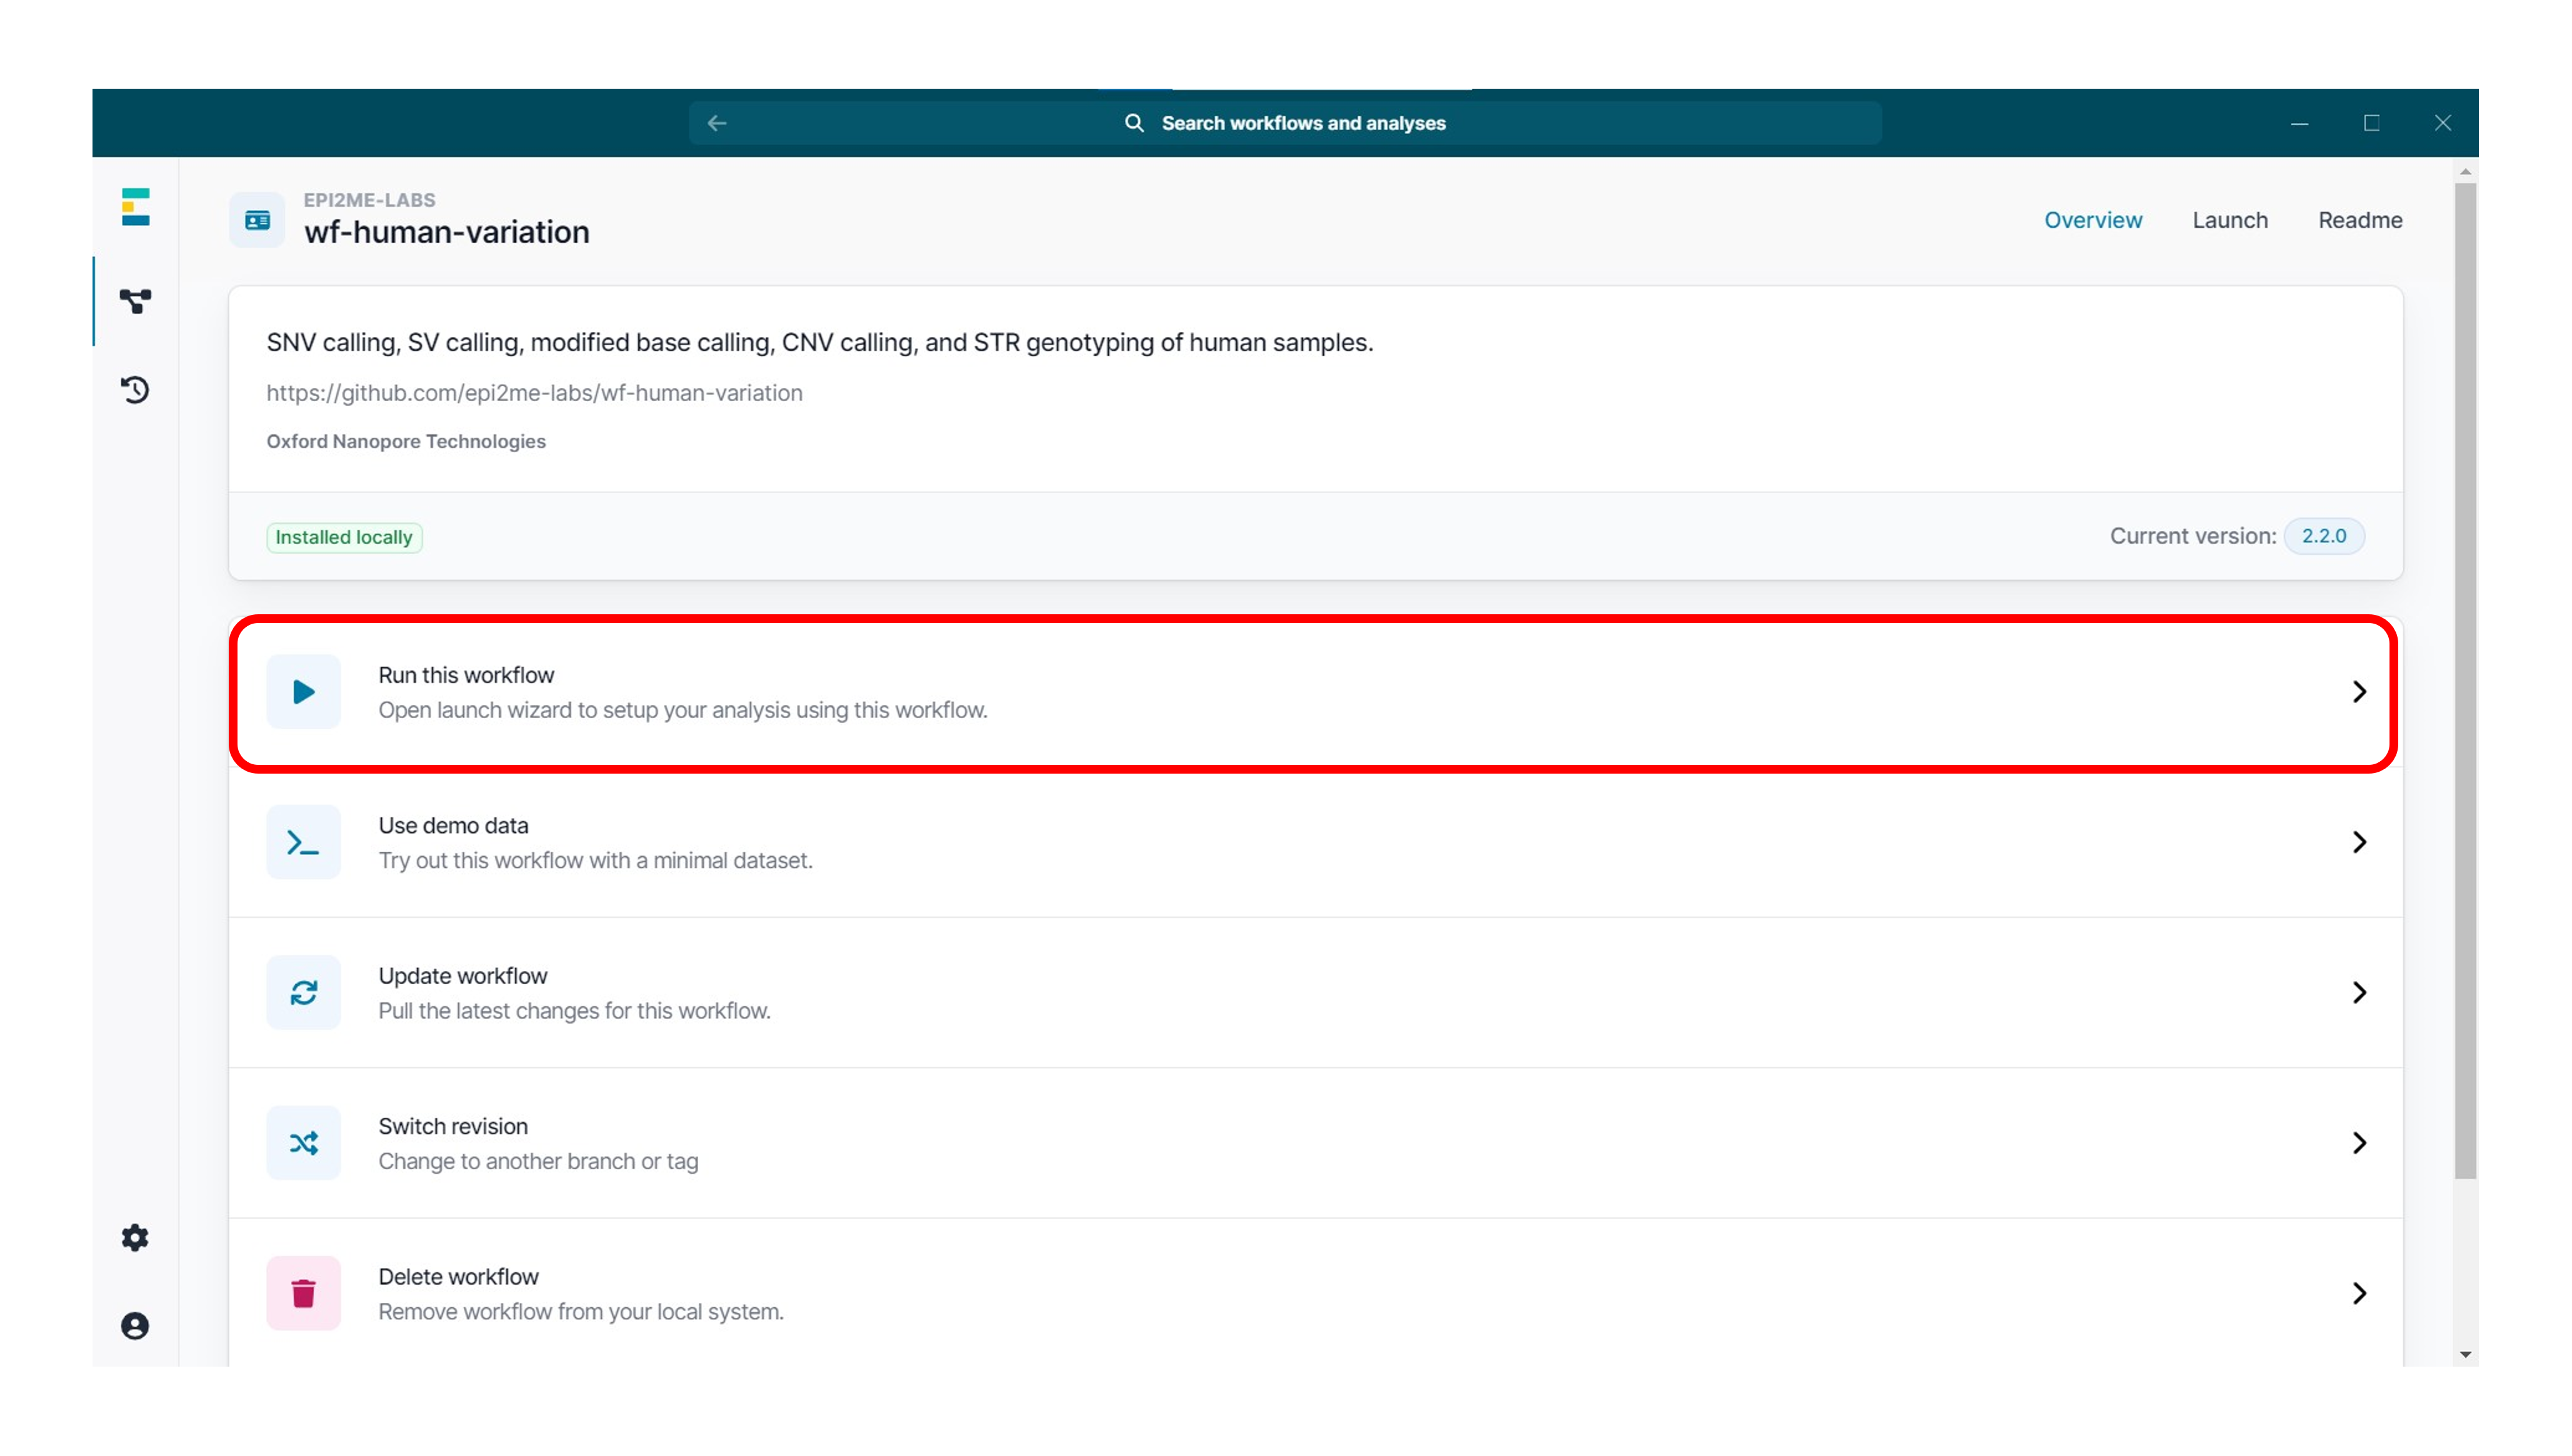
Pulsar en "Run this workflow» y se abrirá el asistente de inicio.
Seleccionar el entorno desde el que se está ejecutando el flujo de trabajo:
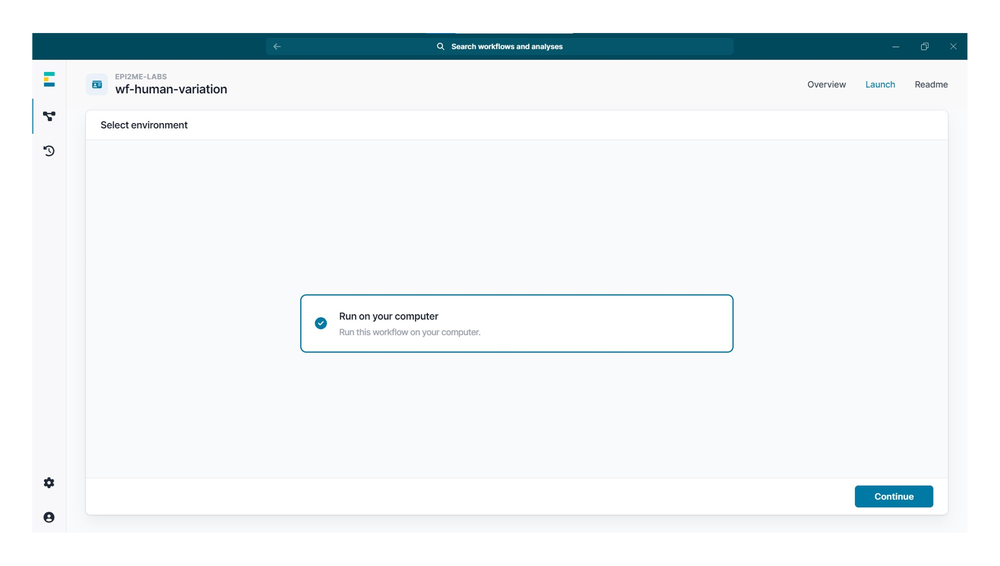
Pulsar en el/los subflujo(s) de trabajo que se desee ejecutar durante el análisis wf-human-variation.
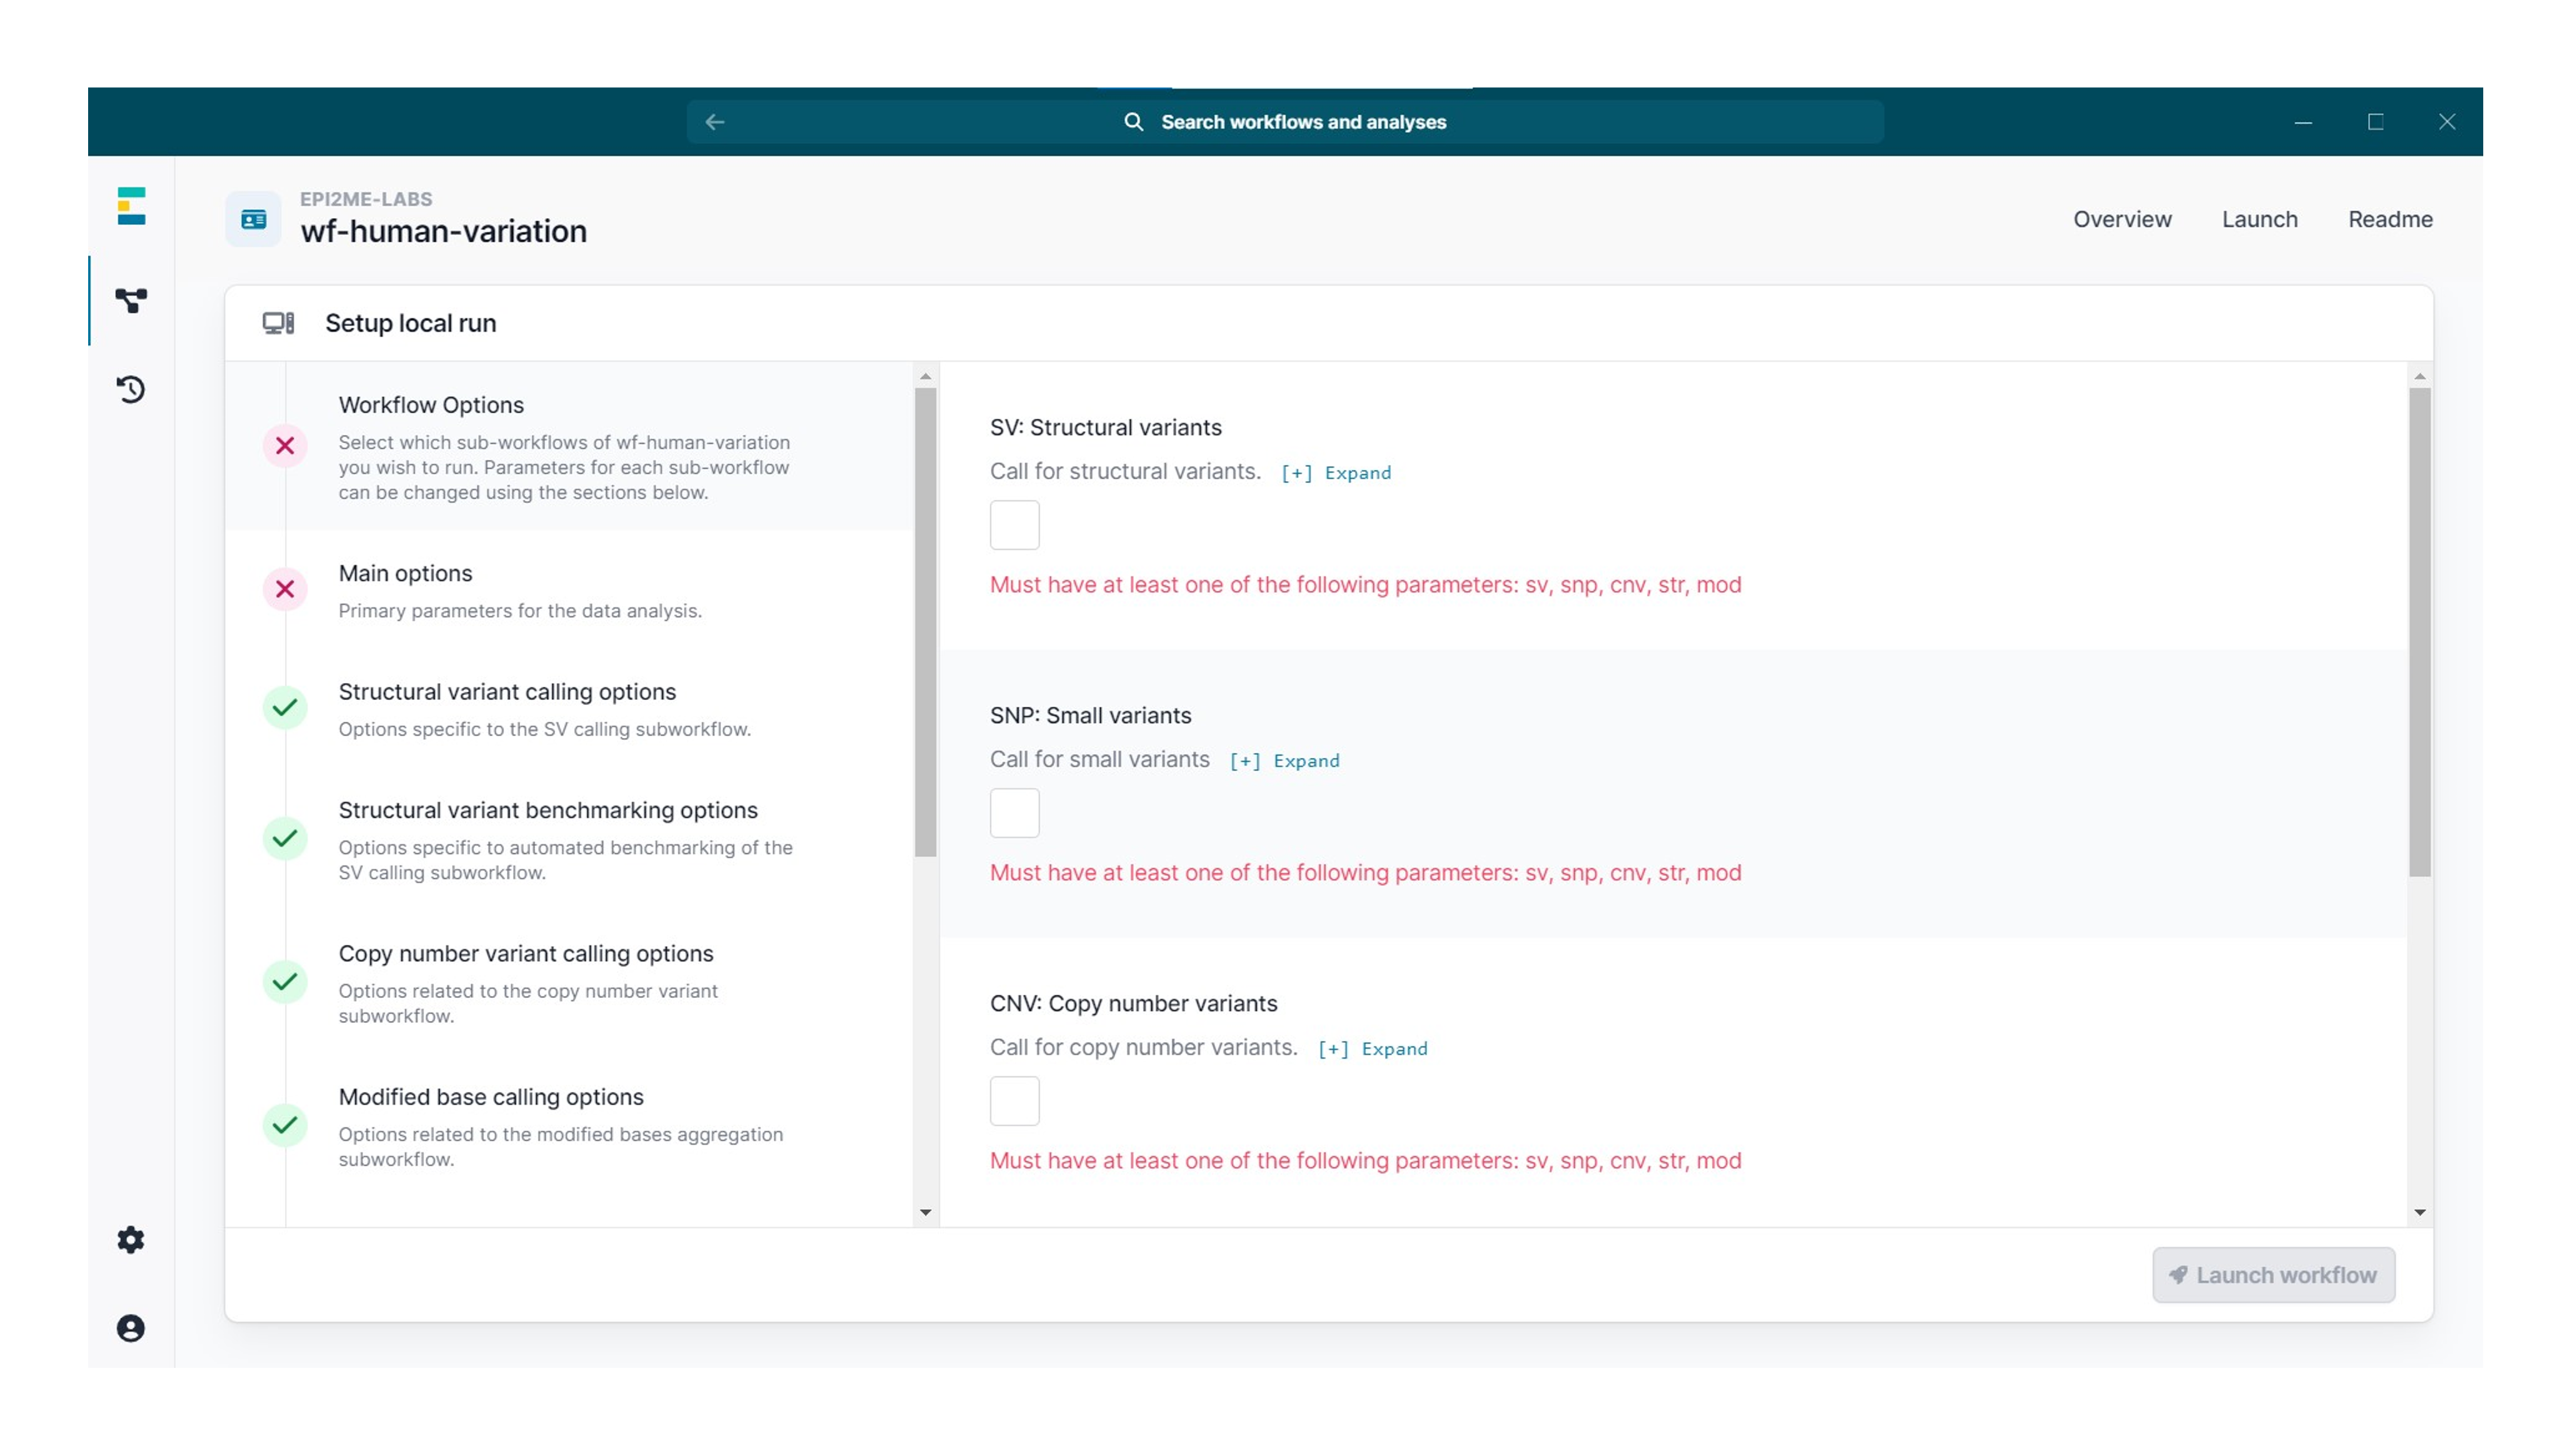
Se debe seleccionar al menos un subflujo de trabajo antes de continuar con el análisis.
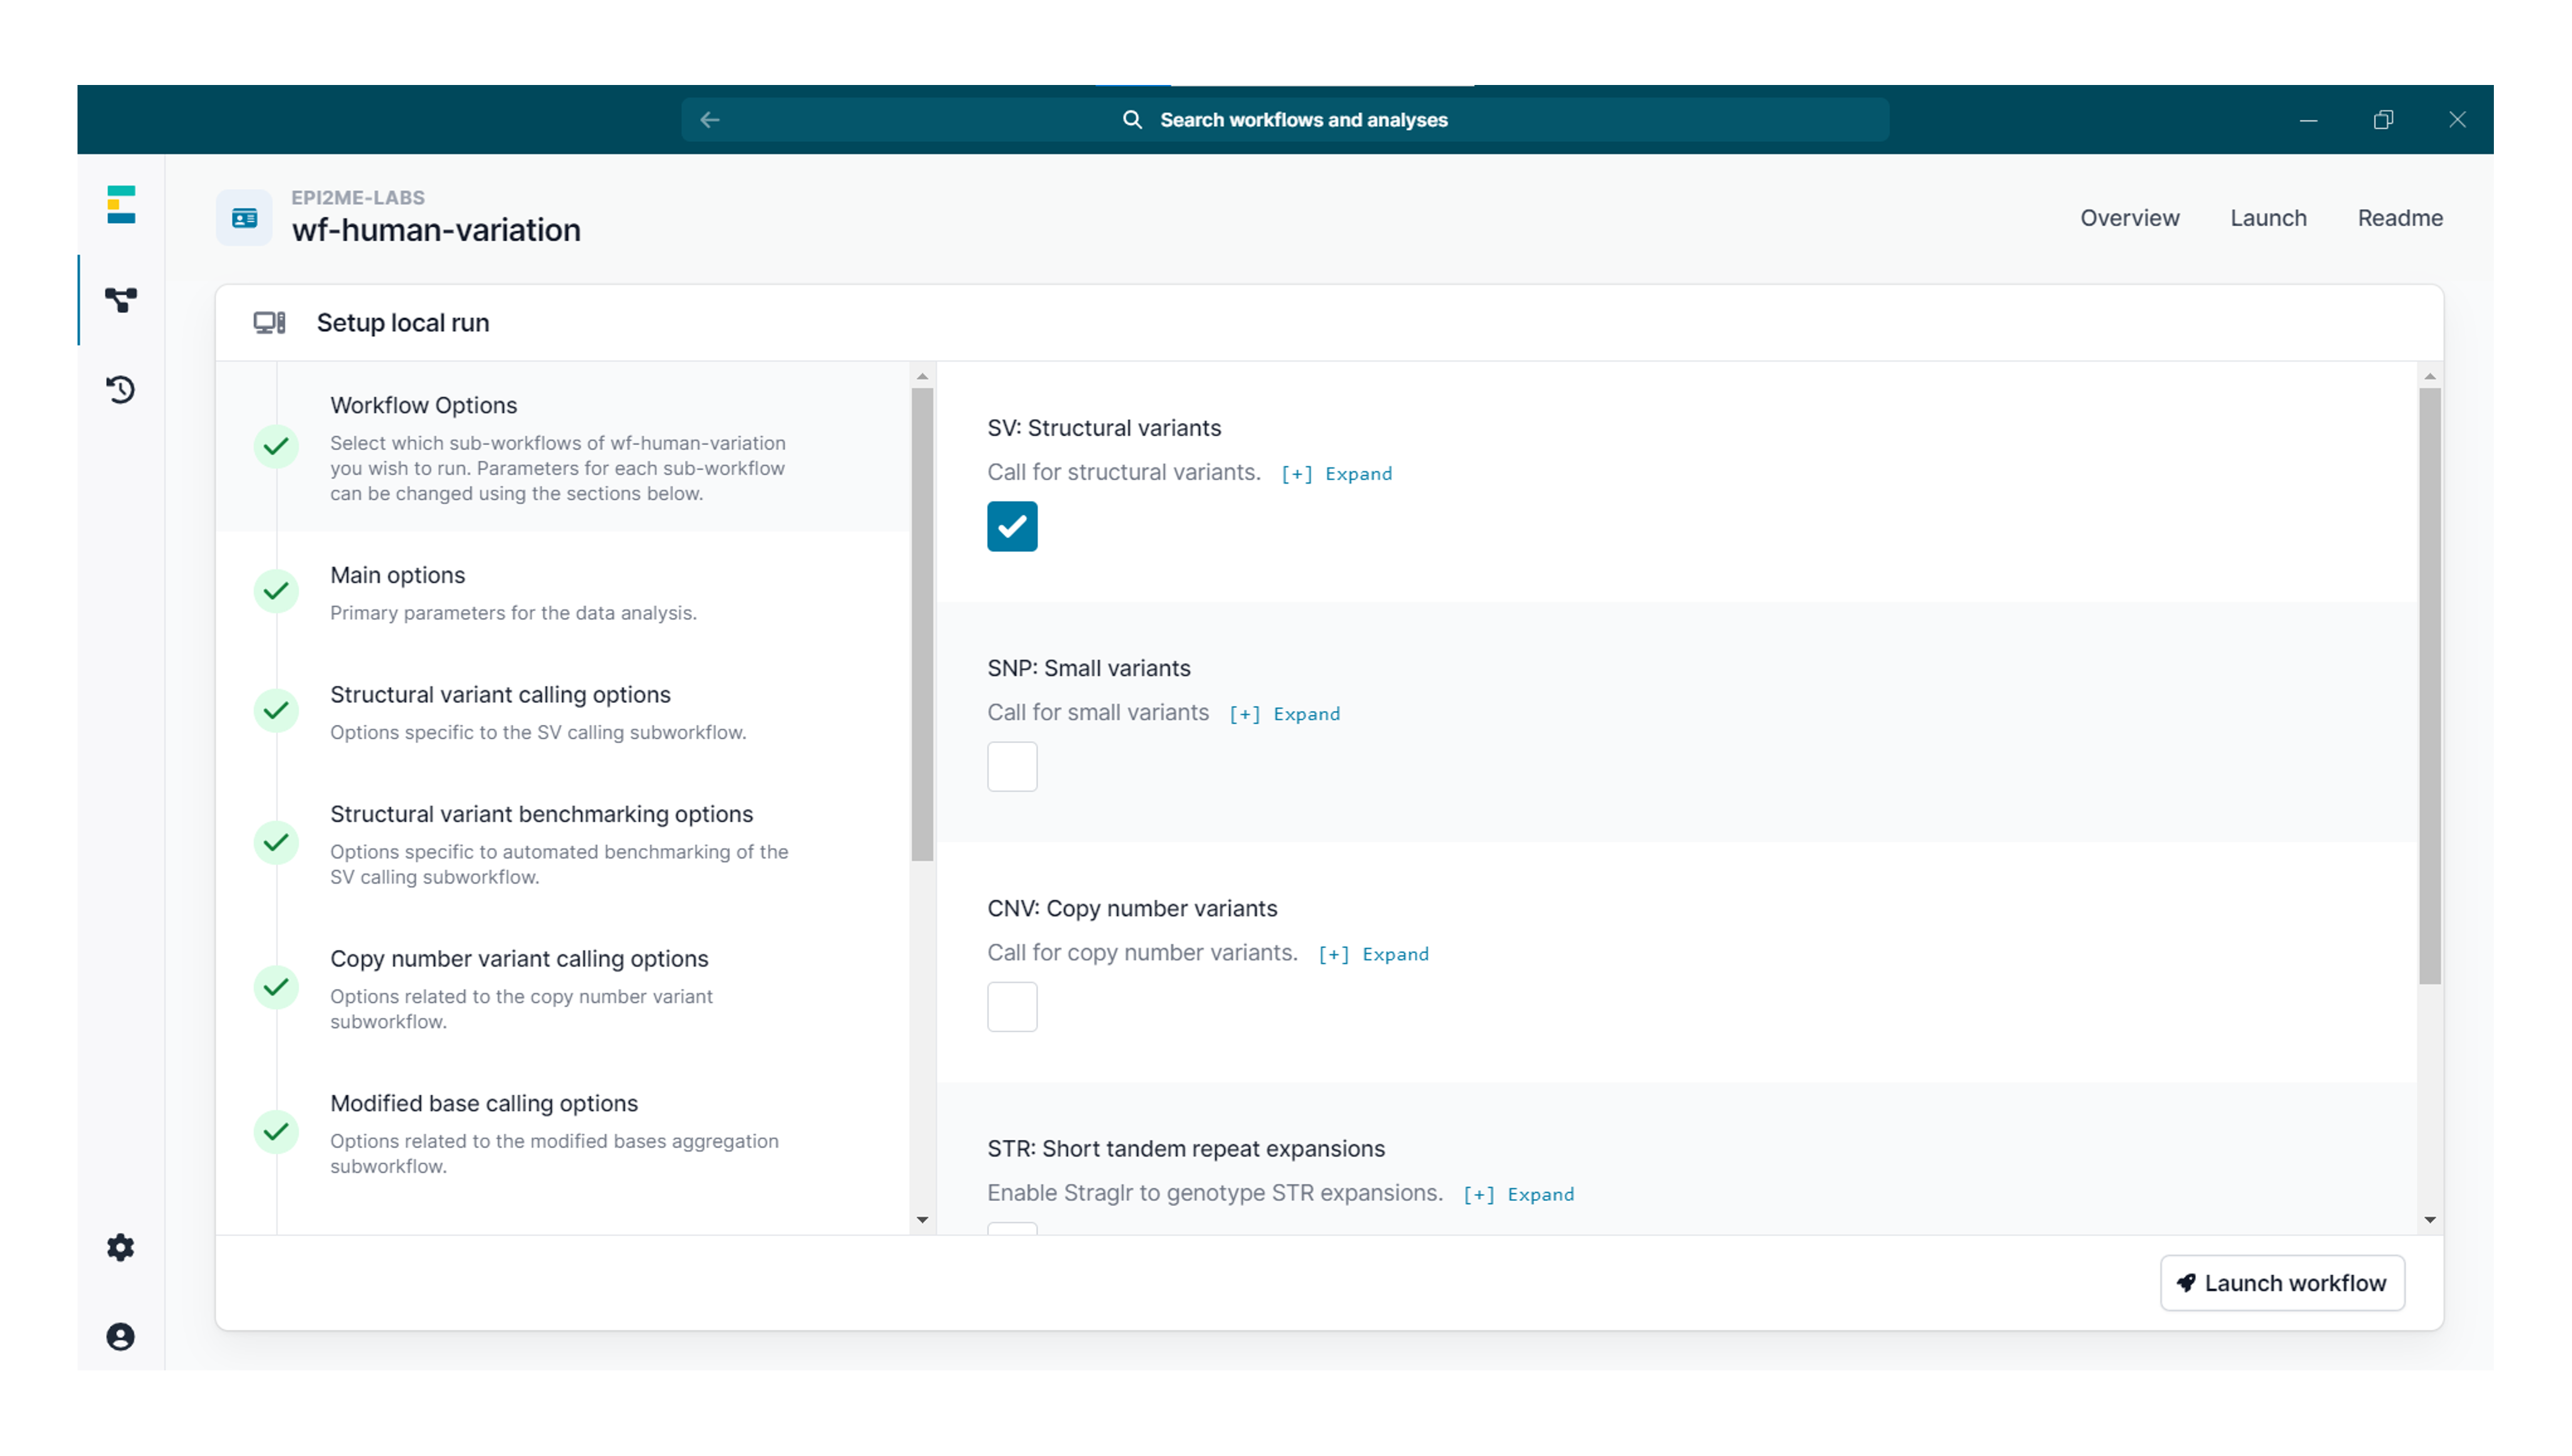
Nota: encontrará más información sobre el tema en la opción Expand o en la documentación en línea de EPI2ME.
Ir a la pestaña «Main options» y en el campo «Sample name» asignar un nombre que sirva de identificador en los resultados del flujo de trabajo.
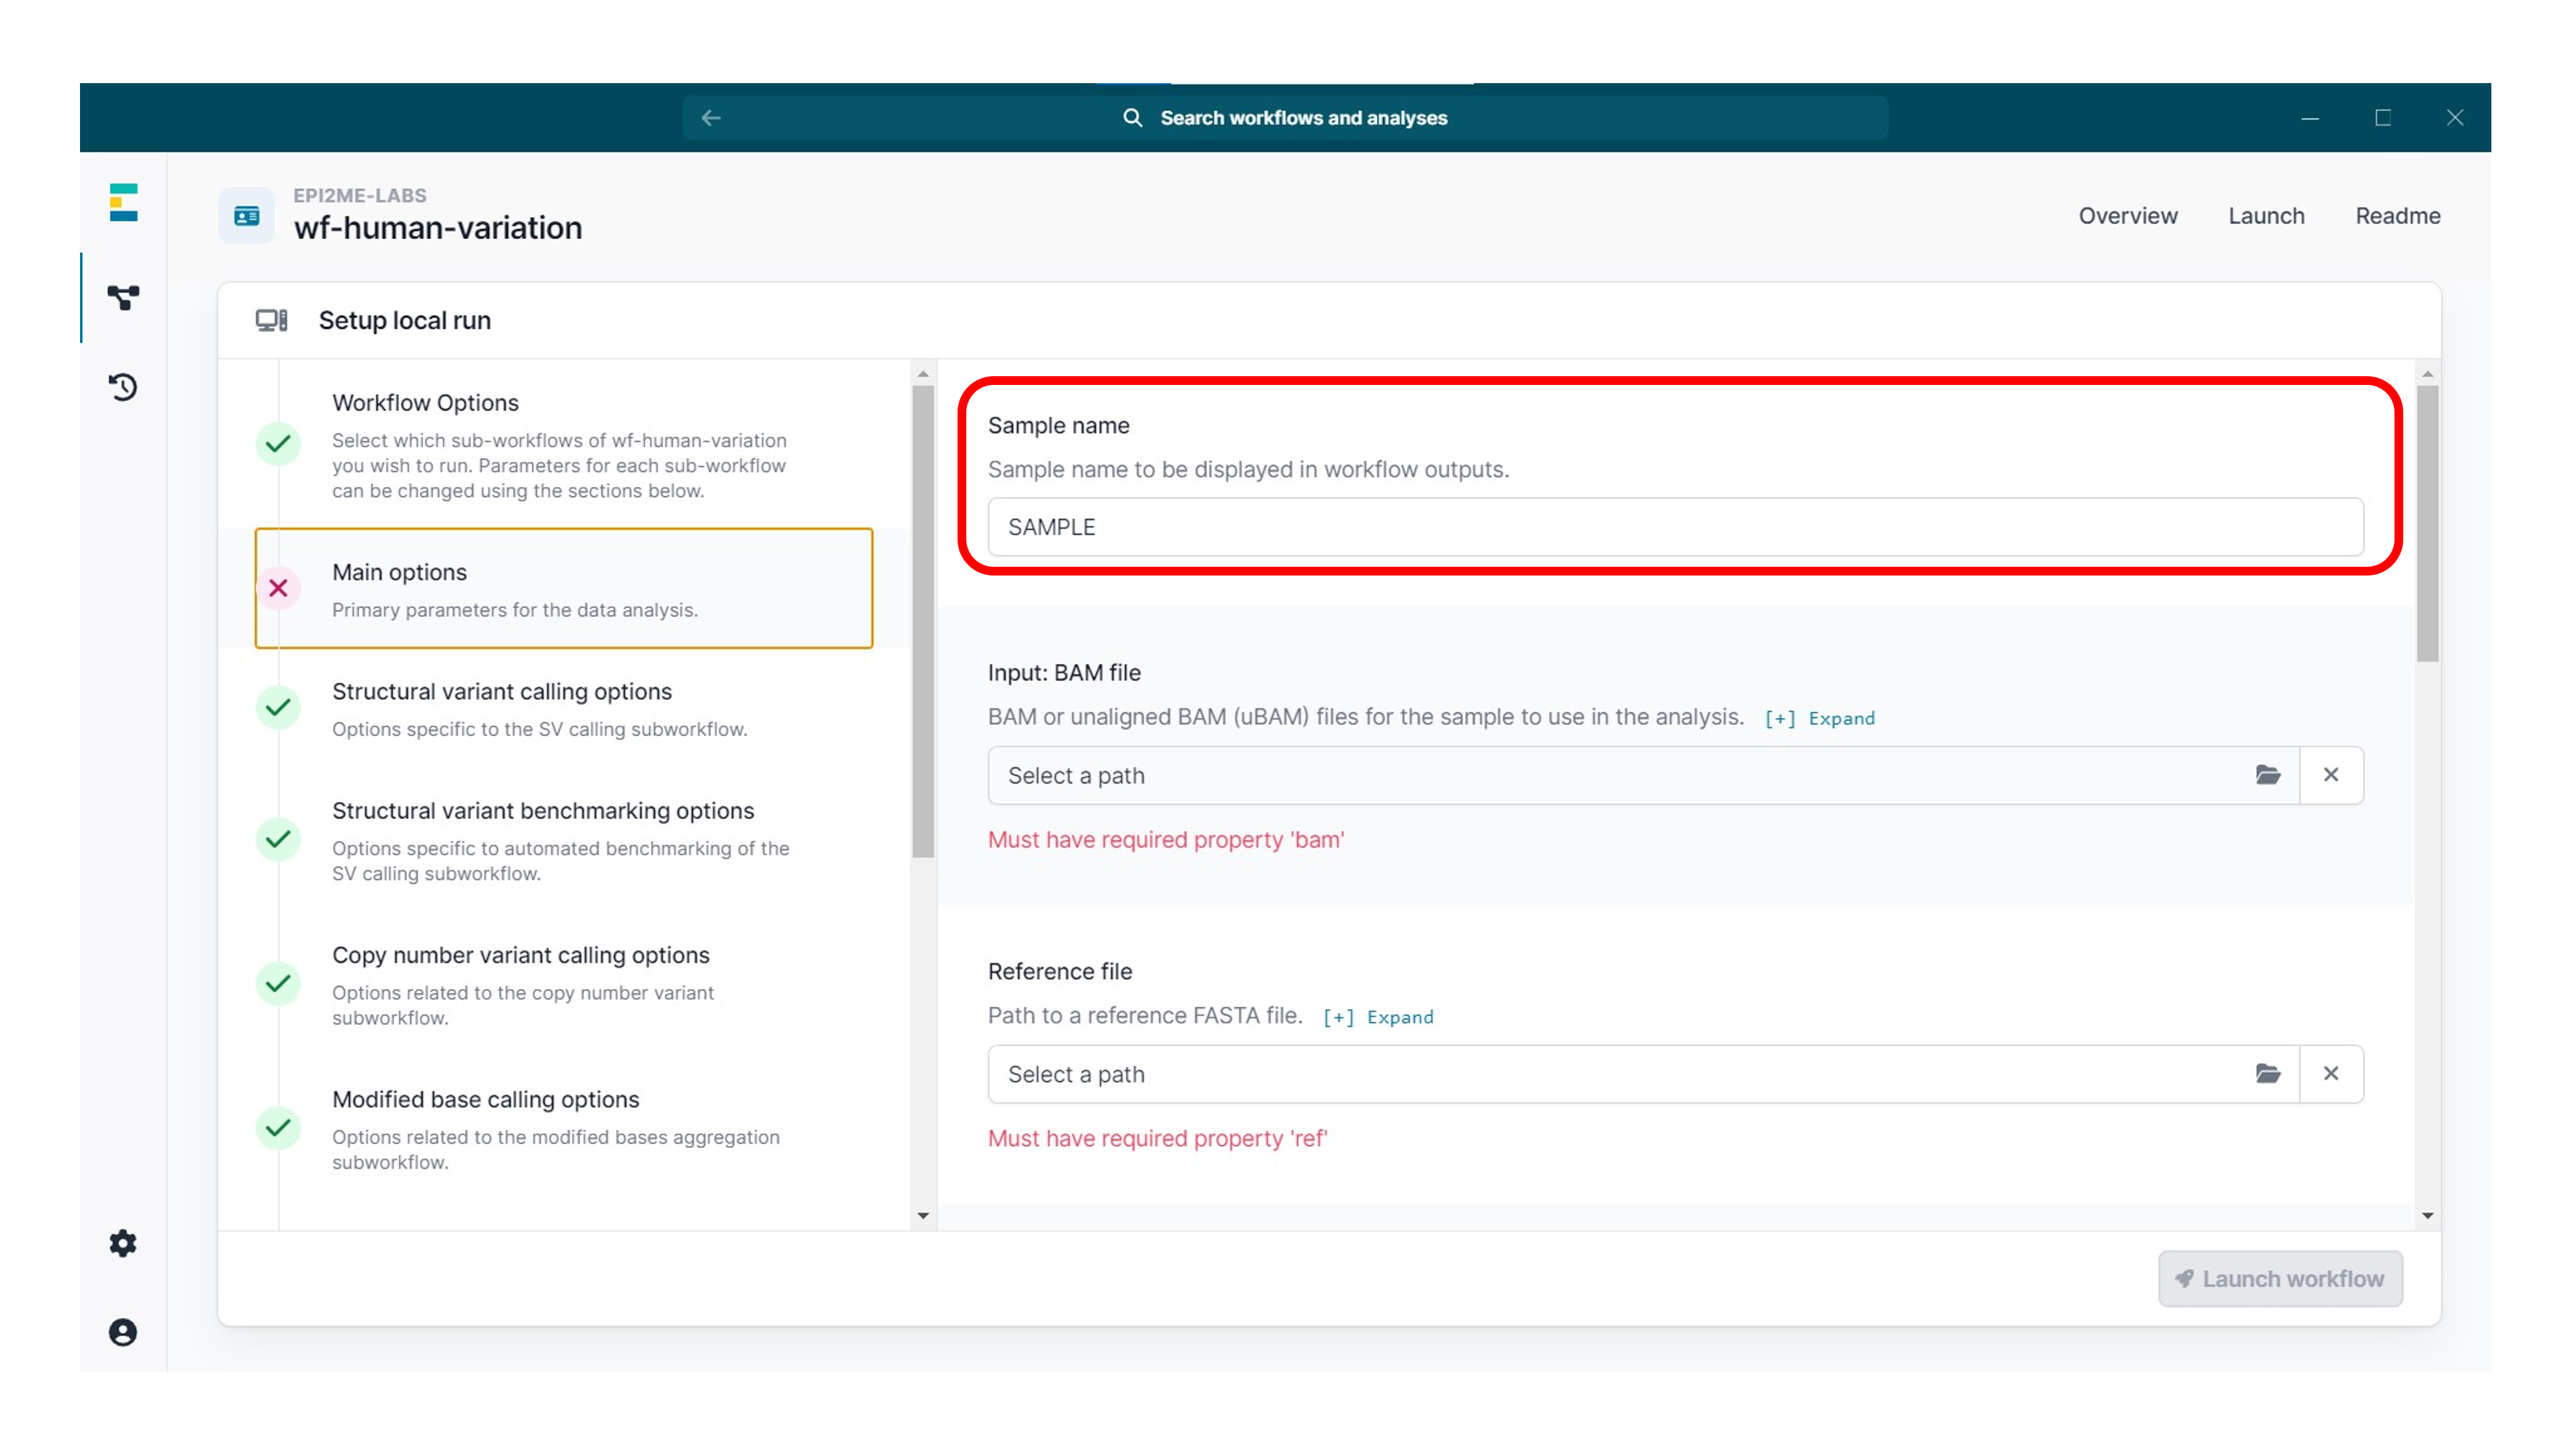
El flujo de trabajo wf-human-variation admite como entrada un archivo BAM o una carpeta de archivos BAM,
tanto alineados como sin alinear:
| Alineamiento del archivo BAM en MinKNOW (antes de ejecutar el flujo de trabajo wf-human-variation) | Alineamiento del archivo BAM en el flujo de trabajo wf-human-variation (durante el flujo de trabajo wf-human-variation) |
|---|---|
| Alinear el archivo BAM obtenido tras la identificación de bases en tiempo real en MinKNOW, evitará ralentizar el procesamiento del sistema. El archivo BAM alineado sirve como archivo de entrada en el flujo de trabajo wf-human-variation. Si necesita más información sobre el alineamiento tras la secuenciación en MinKNOW, consulte el protocolo MinKNOW. Si se utiliza un archivo de entrada BAM alineado, el flujo de trabajo tardará entre 1 y 2 horas. | Es posible proporcionar un genoma de referencia junto con el archivo BAM sin alinear durante la configuración del flujo de trabajo. Con un archivo de entrada BAM no alineado, el flujo de trabajo tardará entre 5 y 8 horas. |
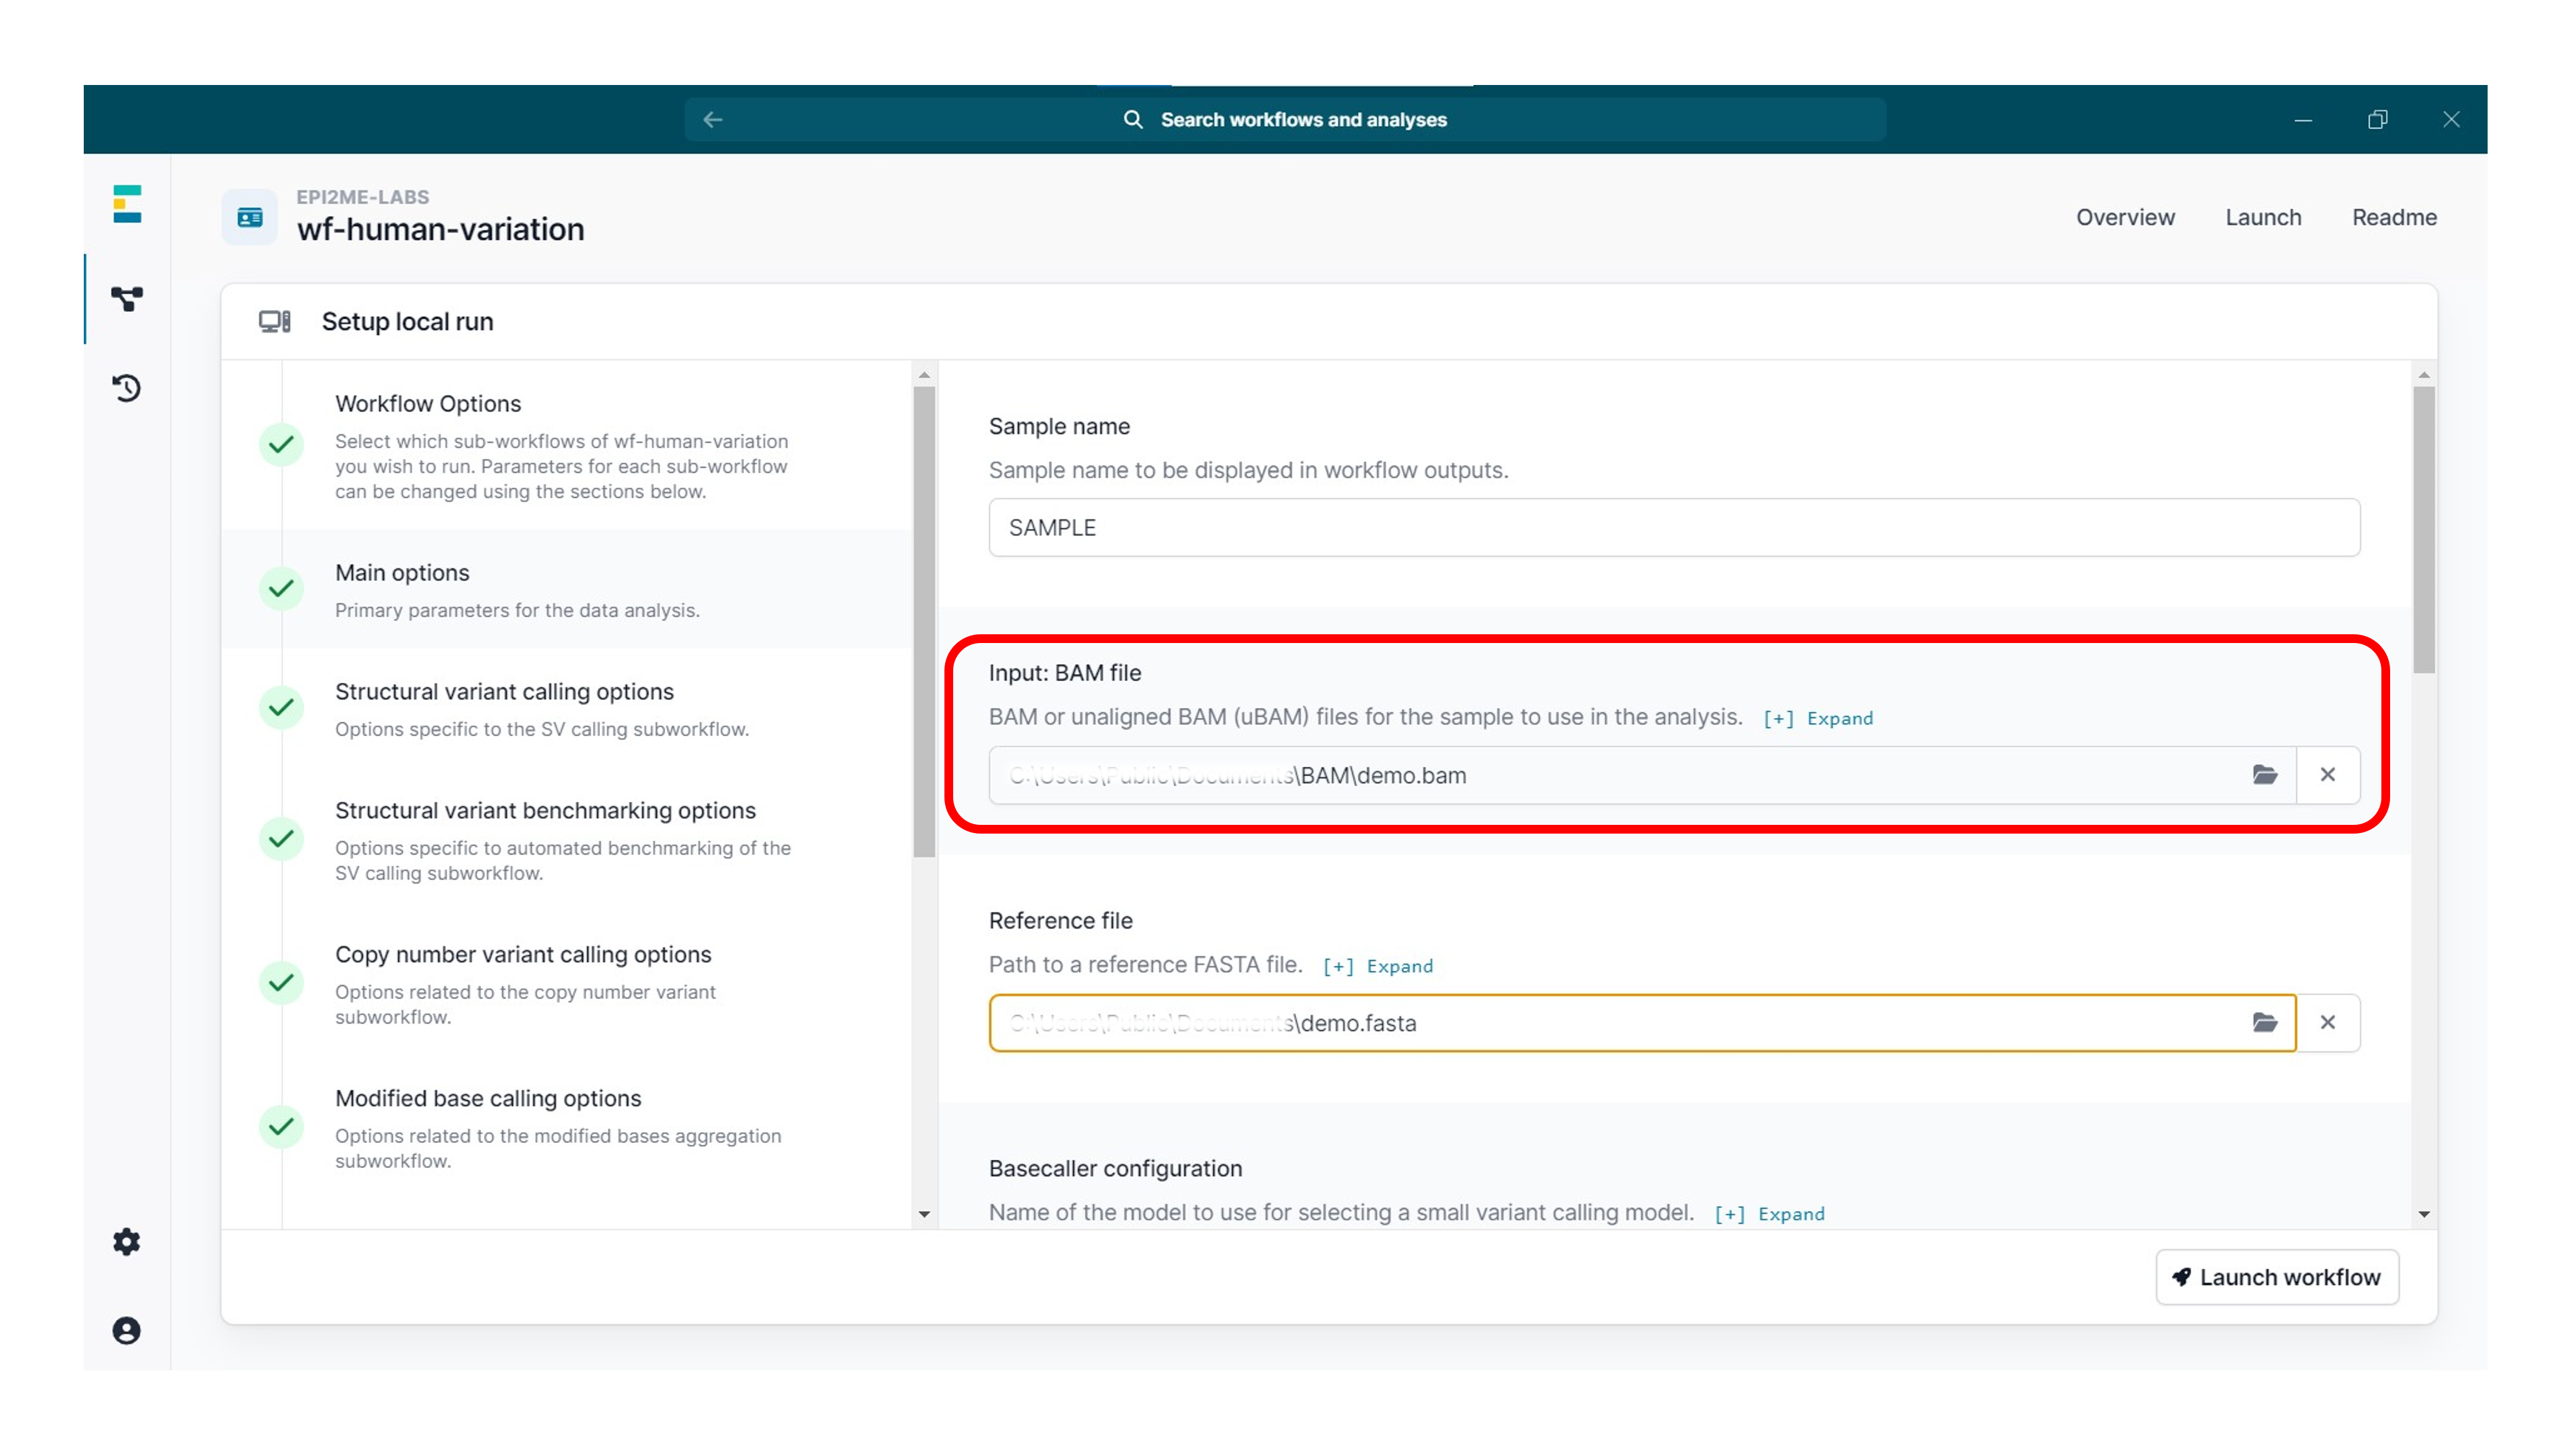
Cargar los datos de secuenciación en la pestaña «Main options», en un solo archivo BAM o en una carpeta de archivos BAM.
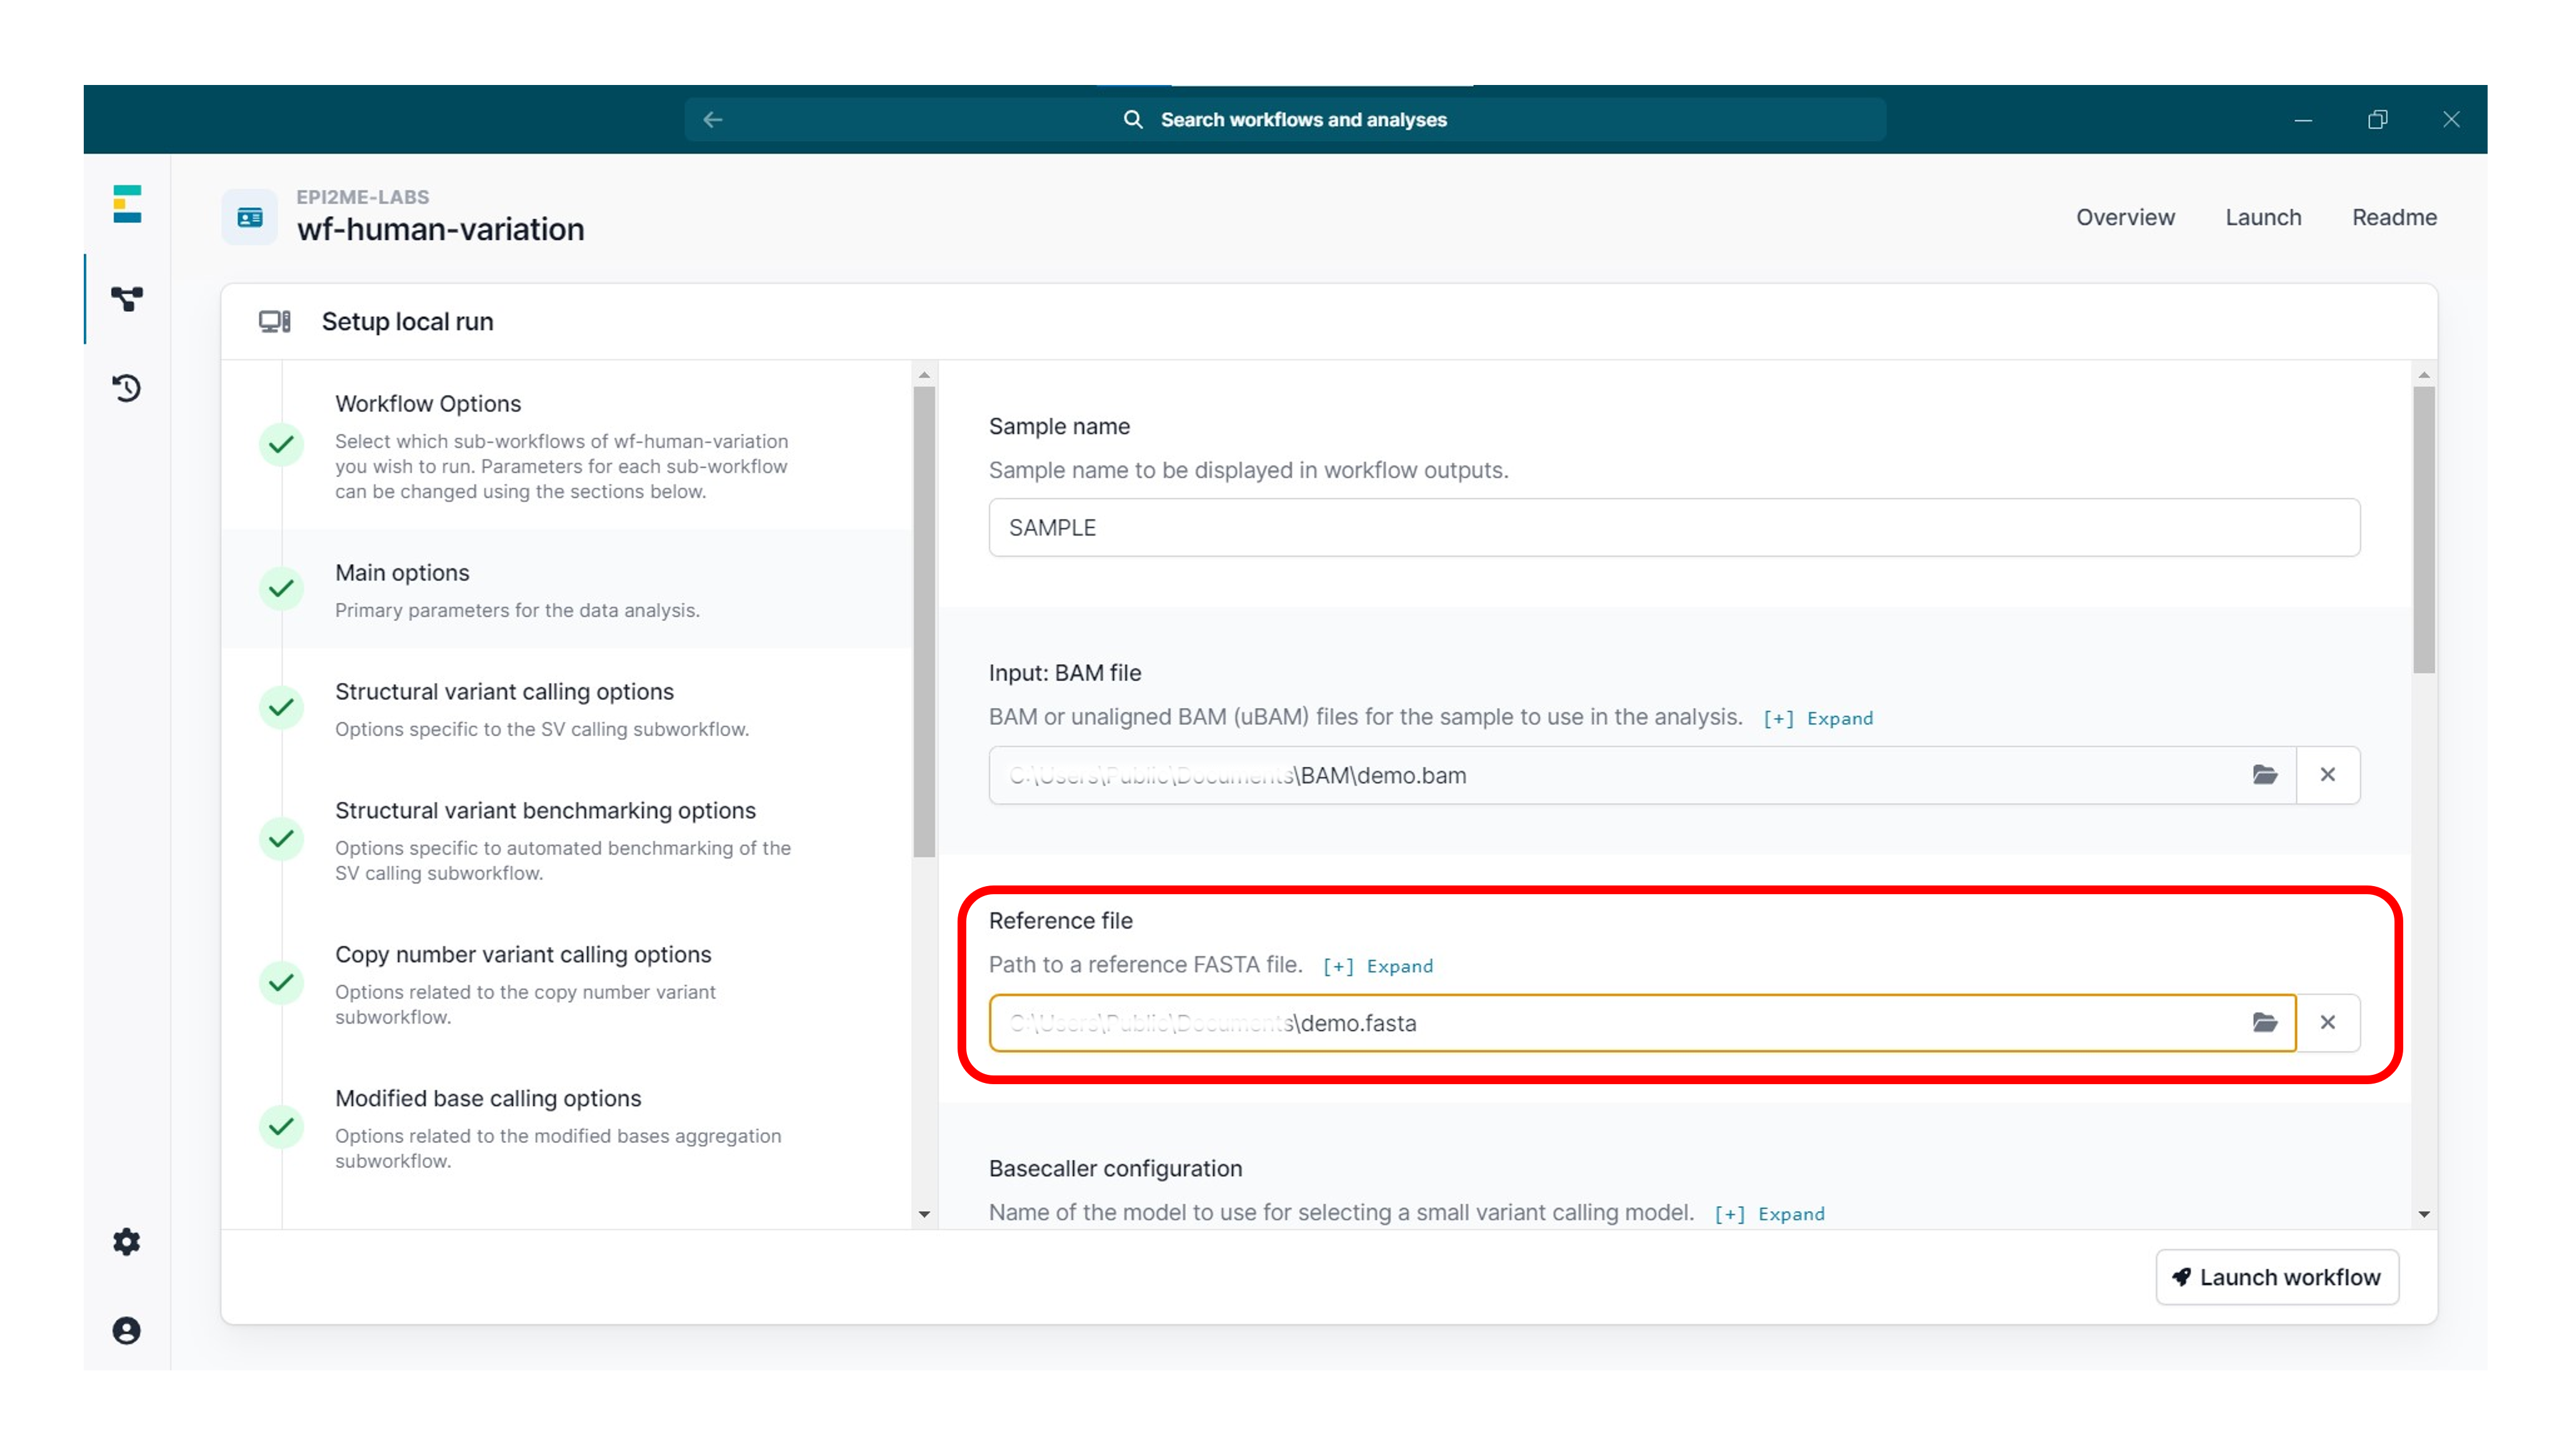
Si se utiliza como entrada un archivo BAM sin alinear, cargar el genoma de referencia en formato FASTA en la pestaña «Main options».
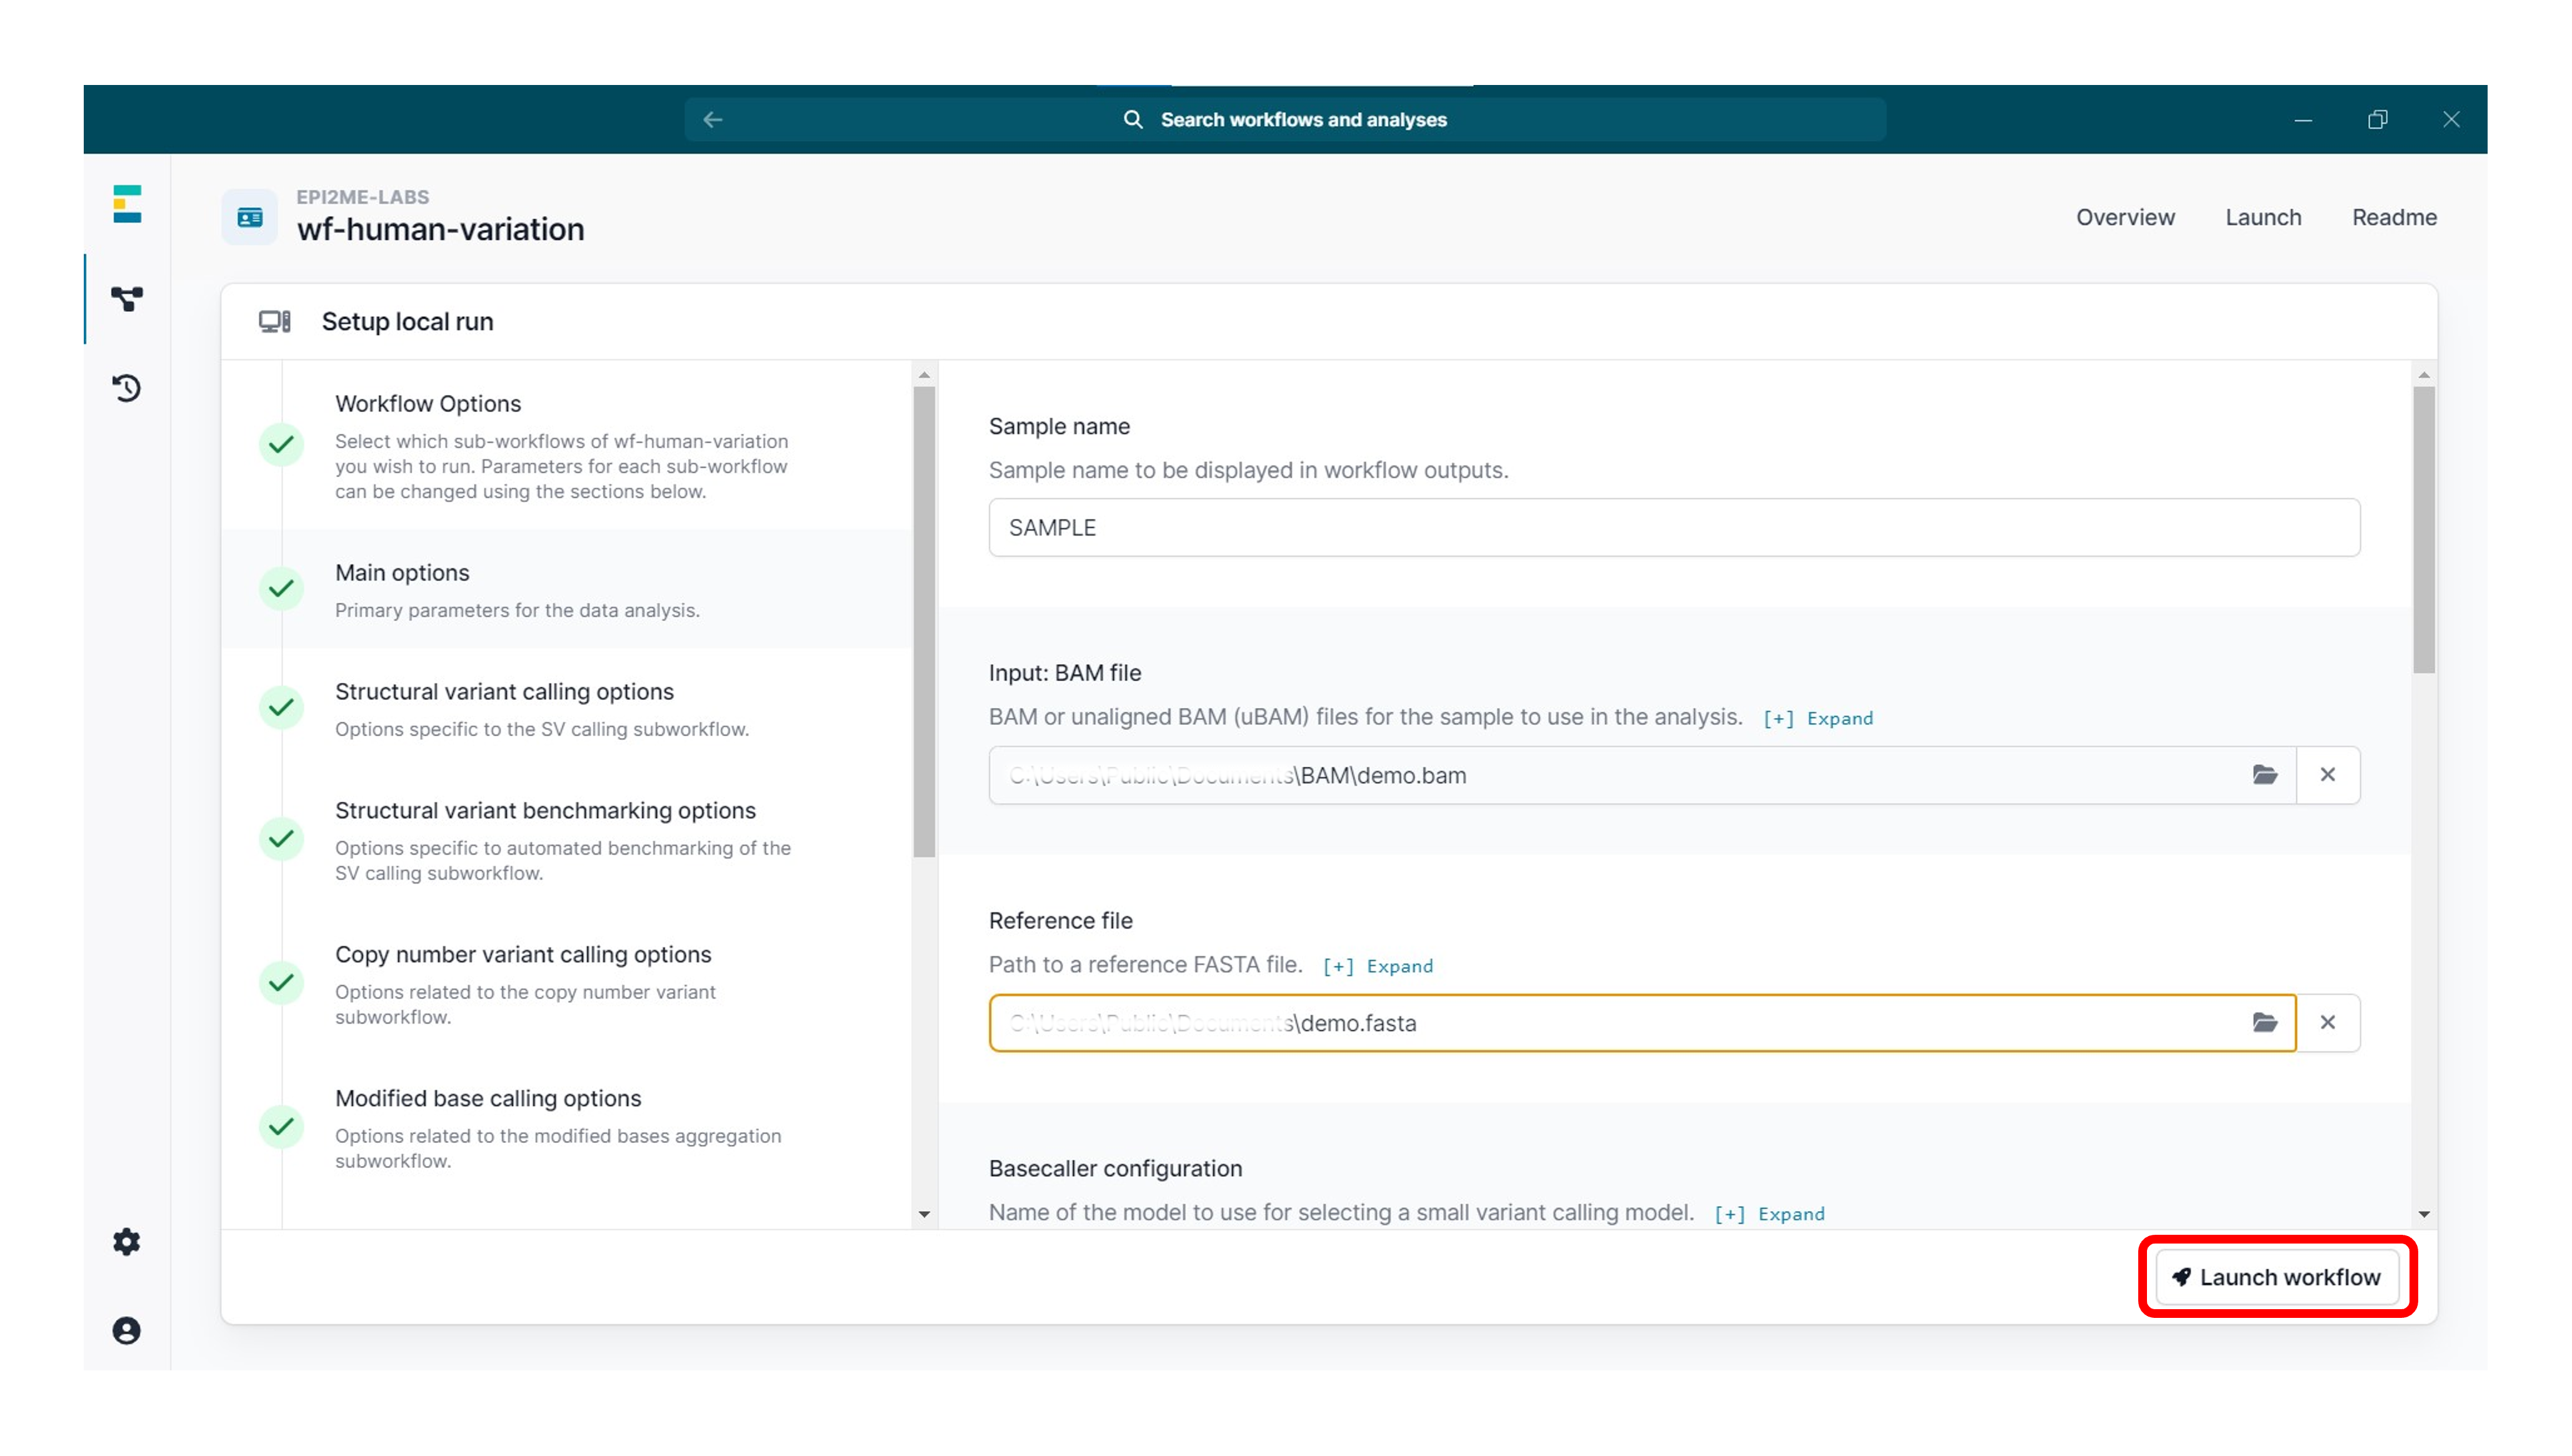
Pulsar «Launch workflow».
Comprobar que todas las opciones de configuración tengan una marca de verificación verde.
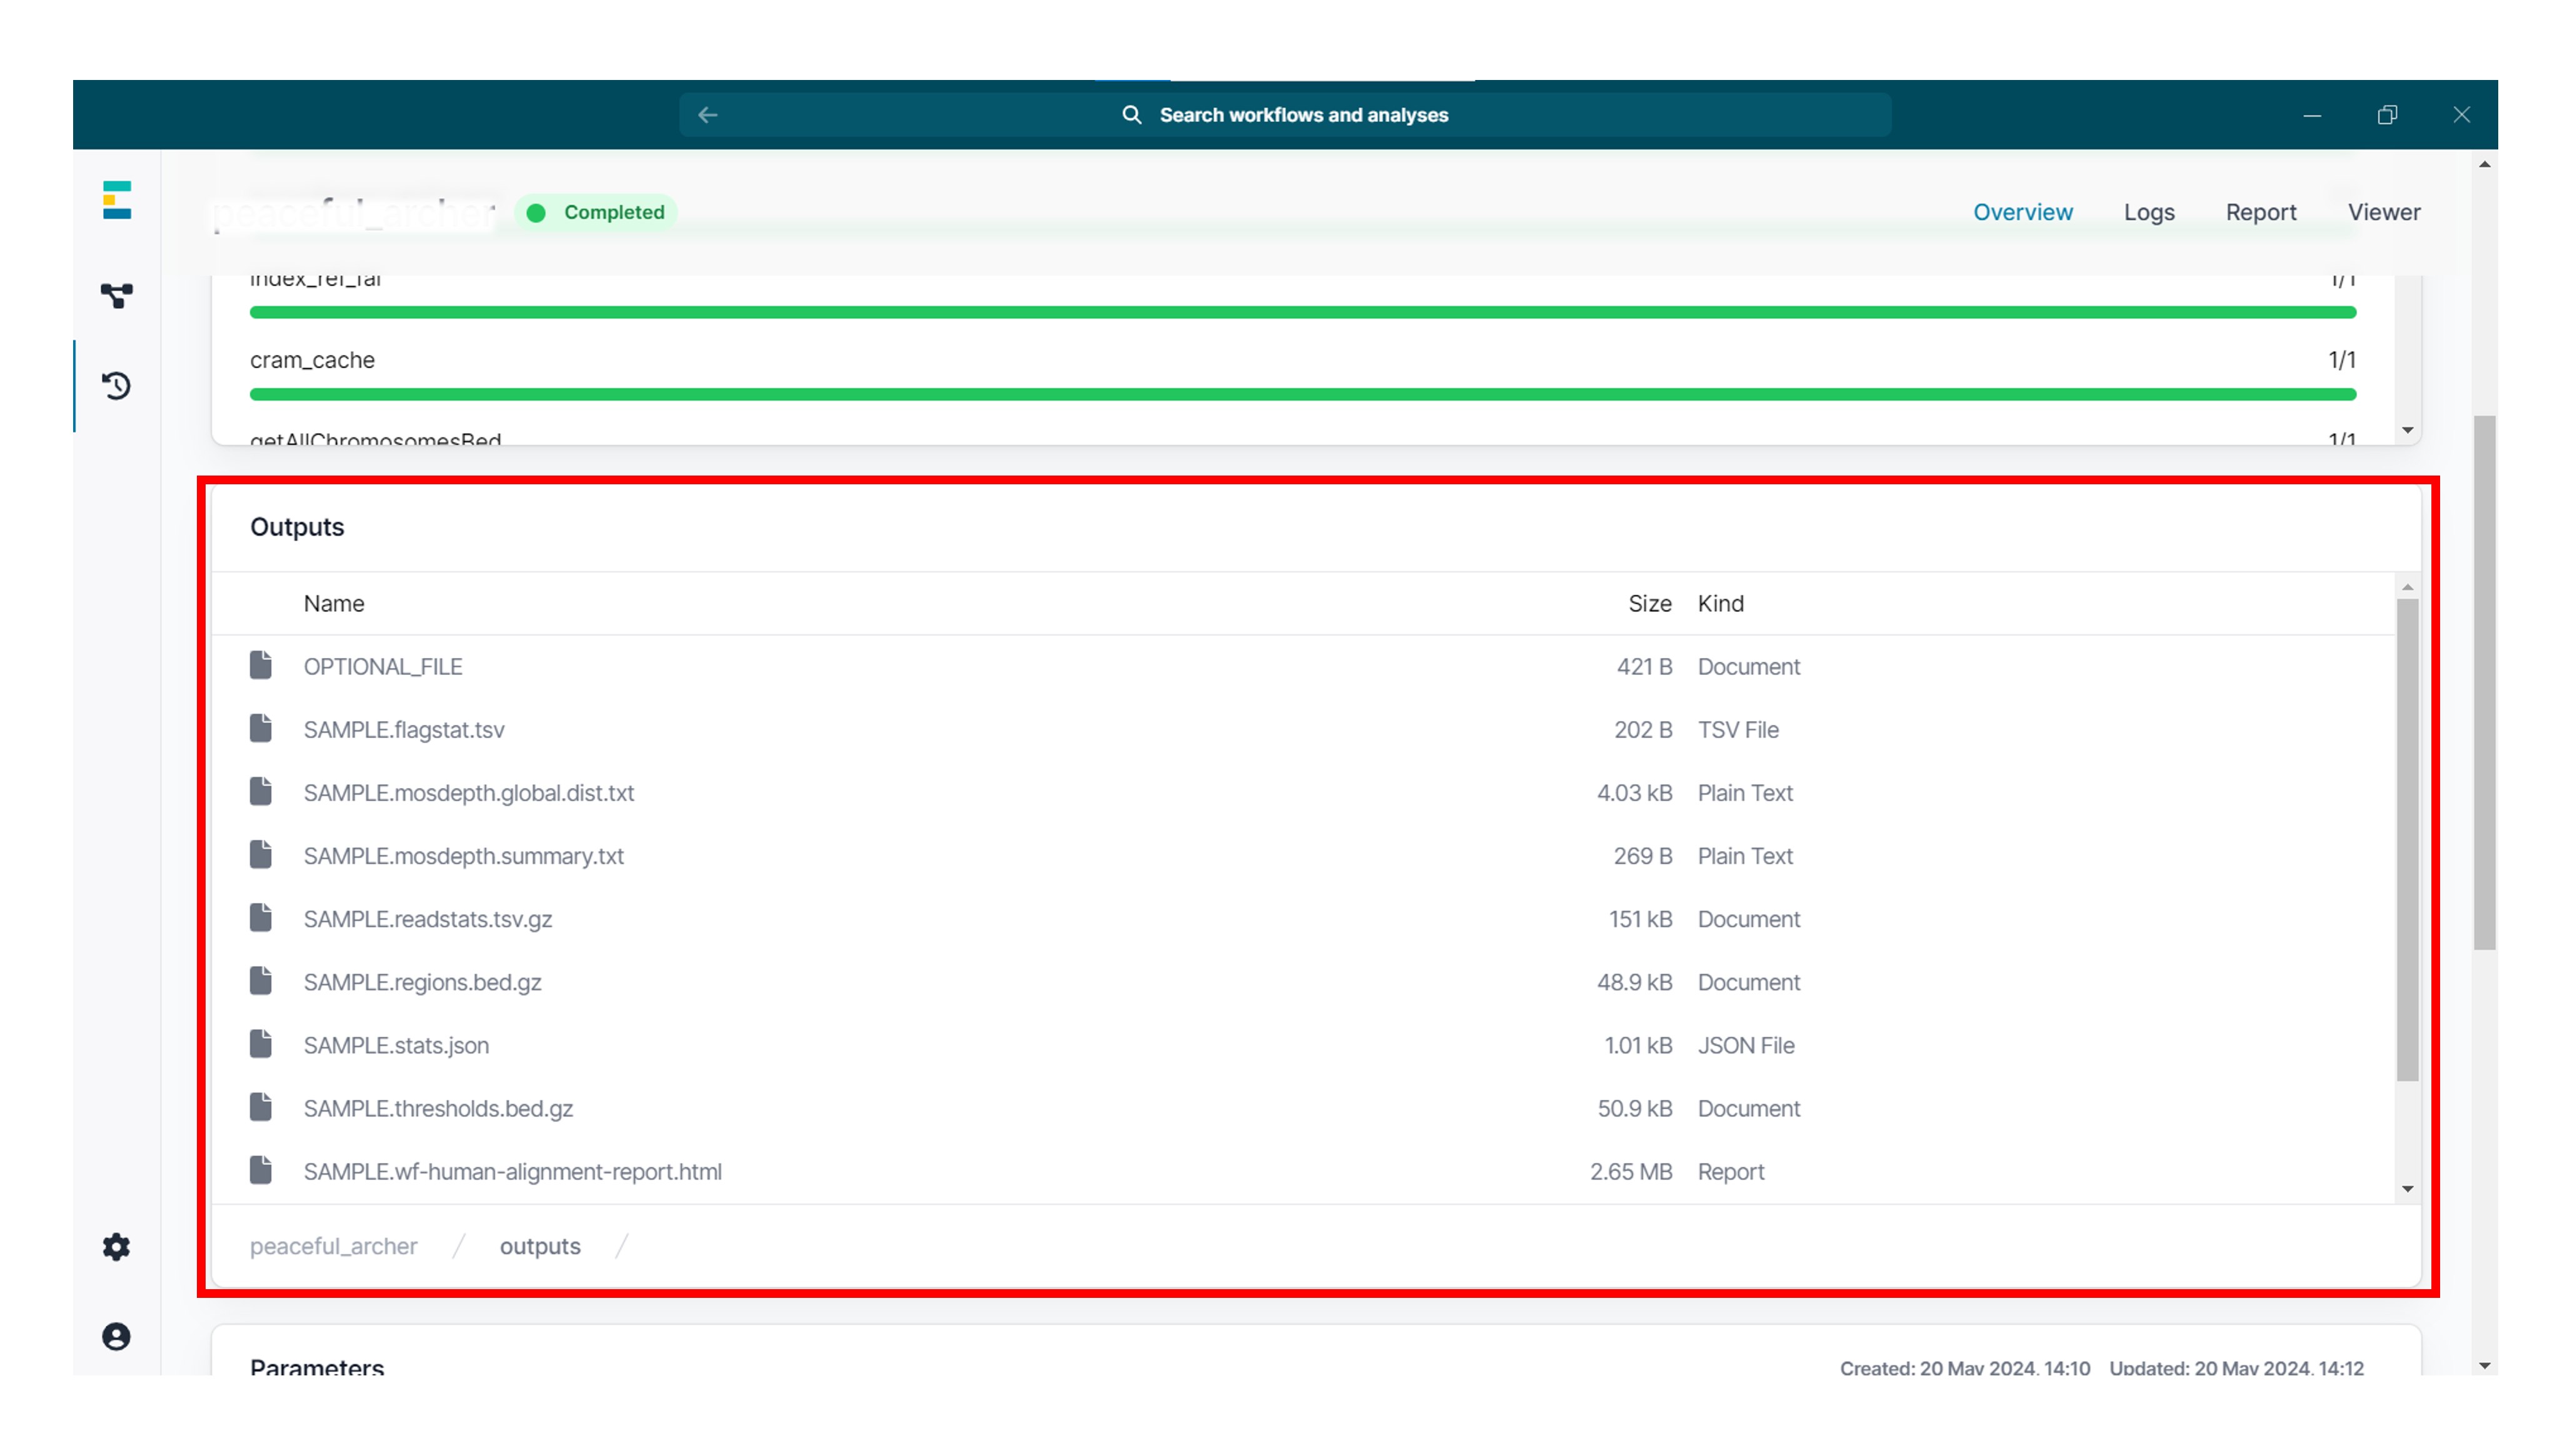
Una vez finalizado el flujo de trabajo, se generará un informe junto con los archivos de salida.
Resultados del flujo de trabajo wf-human-variation
Los resultados del flujo de trabajo principal incluyen:
- un archivo VCF comprimido con gzip que contiene los SNP del conjunto de datos indicado mediante
--snp; - un archivo VCF comprimido con gzip que contiene las variantes estructurales (SV) del conjunto de datos indicado mediante
--sv; - un archivo bedMethyl comprimido que agrupa los recuentos de bases modificadas indicados mediante
--mod; - un informe HTML que describe los resultados principales del flujo de trabajo, incluidas las métricas de control de calidad y la identificación de SNP y variantes estructurales;
- si se proporciona un archivo BAM sin alinear, el flujo de trabajo generará un archivo CRAM con los alineamientos utilizados en la posterior identificación de variantes.
Resultado del flujo de trabajo secundario:
- los resultados de
mosdepthincluyen:{sample_name}.mosdempth.global.dist.txt: una distribución acumulada que indica la proporción del total de bases correspondientes a cada secuencia de referencia y al conjunto de ellas.{sample_name}.regions.bed.gz: la cobertura media de cada región en el archivo BED proporcionado.{sample_name}.thresholds.bed.gz: el número de bases de cada región cuya cobertura alcanza o supera cada uno de los valores umbral (1, 10, 20, 30×).
- los archivos de salida generados por bamstats incluyen:
{sample_name}.readstats.tsv.gz: un archivo TSV comprimido con gzip, que resume las estadísticas de alineamiento generadas por bamstats.{sample_name}.ftagstats.tsv: un archivo de texto con un resumen de las estadísticas de alineamiento correspondientes a cada secuencia de referencia.
Recomendaciones de uso del flujo de trabajo wf-human-variation
Con la opción --phased, se establece la fase de los polimorfismos de un solo nucleótido (SNP), las variantes estructurales (SV) y las bases modificadas.
La precisión en la identificación de SV aumenta cuando se indica, mediante --tr_bed, un archivo BED de repeticiones en tándem, correspondiente al genoma de referencia.
La agrupación de las identificaciones de metilación mediante --mod requiere haber identificado las bases con un modelo que contemple modificaciones de bases y genere las etiquetas BAM MM y ML. En MinKNOW, comprobar que durante la configuración de la identificación de bases estén seleccionados la opción «Bases modificadas» y el modelo «5mC» seleccionado.
Guardar la referencia de entrada durante la identificación de bases o el alineamiento, ya que no es posible leer archivos CRAM sin la referencia de entrada correspondiente.
Encontrará una lista completa de los modelos de identificación de bases a disposición, en la documentación de Dorado.
11. Reutilización y devolución de celdas de flujo
Una vez utilizadas en este protocolo, no recomendamos lavar y reutilizar las celdas de flujo en otro experimento.
Debido a la prolongada duración de la secuenciación, así como a los múltiples lavados y repetidas recargas de la biblioteca que se realizan, no recomendamos reutilizar las celdas de flujo.
Reutilizarlas en experimentos posteriores provoca que se generen datos insuficientes, lo que dificulta su análisis.
Siga el procedimiento de devolución y envíe las celdas de flujo a Oxford Nanopore, donde serán recicladas.
Ante cualquier problema o duda acerca de su experimento de secuenciación, consulte la siguiente sección.
12. Problemas durante la extracción de ADN y la preparación de la biblioteca
A continuación hay una lista de los problemas más frecuentes, con algunas posibles causas y soluciones propuestas.
También disponemos de una sección de preguntas frecuentes (FAQ) en la sección Support de la comunidad Nanopore.
Si ha probado las soluciones propuestas y los problemas aún persisten, póngase en contacto con el departamento de Asistencia técnica, bien por correo electrónico (support@nanoporetech.com) o a través del chat de la comunidad Nanopore.
Baja calidad de la muestra
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| Baja pureza del ADN (la lectura del Nanodrop del ADN con una relación OD 260/280 es <1,8 y OD 260/230 es <2,0-2,2) | El método de extracción de ADN no proporciona la pureza necesaria | Los efectos de los contaminantes se muestran en el documento Contaminants. Probar con otro método de extracción que no provoque el arrastre de contaminantes. Considere realizar un paso adicional de limpieza con microesferas AMPure. |
Escasa recuperación de ADN tras la limpieza con microesferas AMPure
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| Escasa recuperación | Pérdida de ADN debido a una proporción de microesferas AMPure por muestra inferior a lo previsto. | 1. Las microesferas AMPure precipitan con rapidez; antes de añadirlas a la muestra deben estar bien resuspendidas. 2. Si la proporción de microesferas por muestra es inferior a 0.4:1, los fragmentos de ADN, sean del tamaño que sean, se perderán durante la limpieza. |
| Escasa recuperación | Los fragmentos de ADN son más cortos de lo esperado | Cuanto menor sea la proporción de microesferas AMPure por muestra, más rigurosa será la selección de fragmentos largos frente a los cortos. Determinar siempre la longitud de la muestra de ADN en un gel de agarosa u otros métodos de electroforesis en gel y a continuación, calcular la cantidad adecuada de microesferas AMPure que se debe utilizar. 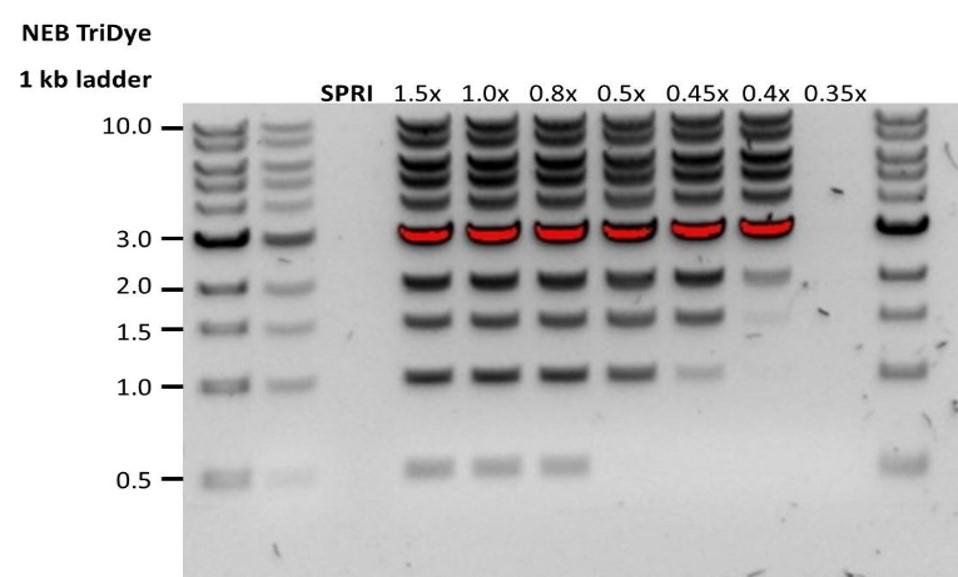 |
| Escasa recuperación tras la preparación de extremos | En el paso de lavado se utilizó etanol en una concentración inferior al 70 % | Si se utiliza etanol a una concentración inferior al 70 %, el ADN se eluye de las microesferas. Compruebe que utiliza el porcentaje correcto. |
13. Problemas durante el experimento de secuenciación
A continuación hay una lista de los problemas más frecuentes, con algunas posibles causas y soluciones propuestas.
También disponemos de una sección de preguntas frecuentes (FAQ) en la sección Support de la comunidad Nanopore.
Si ha probado las soluciones propuestas y los problemas aún persisten, póngase en contacto con el departamento de Asistencia técnica, bien por correo electrónico (support@nanoporetech.com) o a través del chat de la comunidad Nanopore.
Menos poros al inicio de la secuenciación que tras la evaluación de la celda de flujo
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| MinKNOW presentó al inicio de la secuenciación un número de poros inferior al indicado durante la evaluación de la celda de flujo. | Se introdujo una burbuja de aire en la matriz de nanoporos. | Tras comprobar el número de poros presente en la celda de flujo y antes de acondicionarla, es imprescindible quitar las burbujas de aire que haya cerca del puerto de purgado. Si no se quitan, son capaces de desplazarse hacia la matriz de nanoporos y dañar los nanoporos expuestos al aire de manera irreversible. En el vídeo Cómo cargar una celda de flujo PromethION se muestran algunas buenas prácticas para evitar que esto ocurra. |
| MinKNOW presentó al inicio de la secuenciación un número de poros inferior al indicado durante la comprobación de la celda de flujo. | La celda de flujo no está colocada correctamente. | Detener el ciclo de secuenciación, quitar la celda de flujo del dispositivo e insertarla de nuevo. Comprobar que está firmemente asentada y que ha alcanzado la temperatura deseada. Si procede (GridION/PromethION), probar con una posición diferente. |
| MinKNOW presentó al inicio de la secuenciación un número de poros inferior al indicado durante la evaluación de la celda de flujo | La presencia de contaminantes en la biblioteca ha dañado o bloqueado los poros. | El recuento de poros durante la evaluación de la celda de flujo se efectúa utilizando las moléculas de ADN del control de calidad presentes en el amortiguador de almacenamiento. Al inicio de la secuenciación, se utiliza la misma biblioteca a fin de calcular el número de poros activos. Por este motivo, se estima que existe una variabilidad del 10 % en el número de poros detectados. Tener un número de poros considerablemente inferior al inicio de la secuenciación suele estar relacionado con la presencia de contaminantes en la biblioteca que hayan dañado las membranas o bloqueado los poros. En algunos casos, recomendamos emplear métodos alternativos de extracción o purificación de ADN/ARN que mejoren la pureza del material de partida. Los efectos de los contaminantes se muestran en la página Contaminants. Probar con un método de extracción diferente que no provoque el arrastre de contaminantes. |
Error en el script de MinKNOW
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| MinKNOW muestra el mensaje "Error en el script" | Reiniciar el ordenador y reiniciar MinKNOW. Si el problema persiste, reúna los archivos de registro de MinKNOW y contacte con el departamento de Asistencia técnica. Si no dispone de otro dispositivo de secuenciación, recomendamos que guarde la celda de flujo cargada a 4 °C y contacte con el servicio de asistencia técnica, que le proporcionará instrucciones de almacenamiento adicionales. |
Ocupación de poros inferior al 40 %
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| Ocupación de poros inferior al 40 % | No se cargó suficiente biblioteca en la celda de flujo | En protocolos de secuenciación de genoma humano, deben cargarse entre 200 y 300 ng de biblioteca de buena calidad en una celda de flujo R10.4.1, a fin de mantener la ocupación de poros elevada. |
| Ocupación de poros próxima a 0 | Se utilizó el kit de secuenciación por ligación y los adaptadores no se ligaron al ADN | En la fase de ligación del adaptador, añadir la cantidad recomendada de NEBNext Quick Ligation Module (E6056) y el amortiguador Ligation Buffer (LNB) suministrado en el kit SQK-LSK114. Preparar una biblioteca de control con Lambda y comprobar la integridad de los reactivos de otros fabricantes. |
| Ocupación de poros próxima a 0 | Se utilizó el kit Ligation Sequencing y en la fase de lavado, después de ligar el adaptador, se utilizó etanol en lugar de Long Fragment Buffer (LFB) o Short Fragment Buffer (SFB). | El etanol desnaturaliza la proteína motor en los adaptadores de secuenciación. Usar Long Fragment Buffer (LFB) o Short Fragment Buffer (SFB) después de la ligación de los adaptadores. |
| Ocupación de poros próxima a 0 | No hay anclaje en la celda de flujo | Los anclajes se añaden durante el acondicionamiento de la celda de flujo (tubo FCT). Añadir FCT al vial FCF antes de acondicionar la celda de flujo. |
Longitud de lectura más corta de lo esperado
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| Longitud de lectura más corta de lo esperado | Fragmentación no deseada de la muestra de ADN | La longitud de lectura refleja la longitud del fragmento de la muestra de ADN. La muestra de ADN tiende a fragmentarse durante la extracción y la preparación de la biblioteca. 1. Consulte la sección de buenas prácticas de extracción en la página Extraction Methods de la comunidad Nanopore. 2. Visualizar la distribución de longitudes de los fragmentos del ADN de partida en un gel de agarosa antes de continuar con la preparación de la biblioteca. 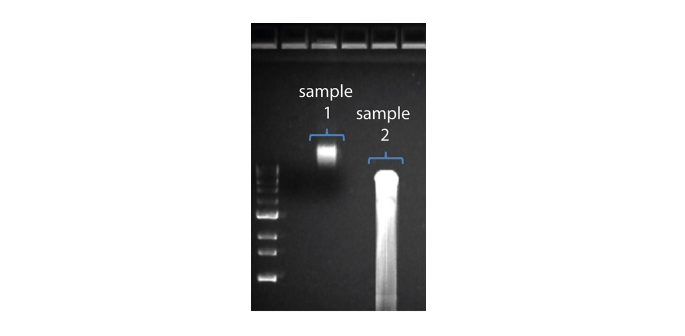 En la imagen superior, la muestra 1 contiene un elevado peso molecular, mientras que la muestra 2 se ha fragmentado. 3. Durante la preparación de la biblioteca, evitar pipetear y agitar en vórtex al mezclar los reactivos. Dar suaves golpecitos al tubo con el dedo o invertir el vial es suficiente. |
Gran proporción de poros no utilizables
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
Gran proporción de poros no utilizables (se muestran en azul en el panel de canales y en el gráfico de actividad de poros) 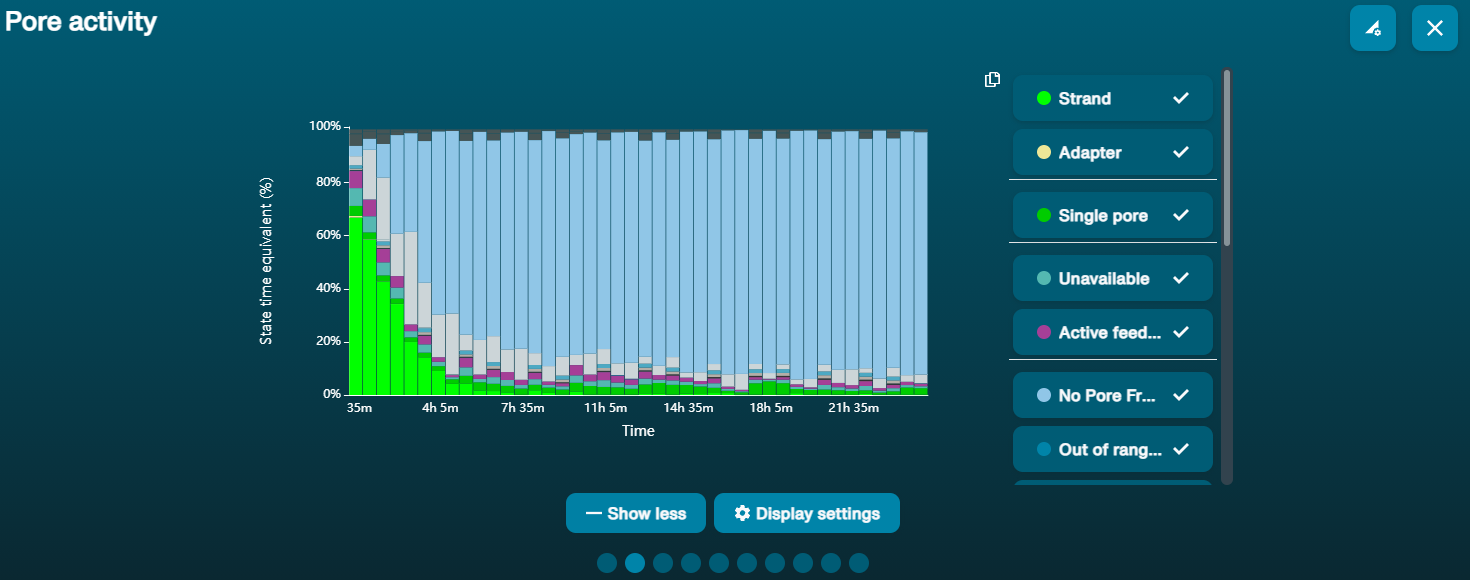 El gráfico de actividad de poros de arriba muestra una proporción creciente de poros «no utilizables» conforme pasa el tiempo. | Hay contaminantes presentes en la muestra | Algunos contaminantes se eliminan de los poros mediante la función de desbloqueo incorporada en MinKNOW; si da resultado, el estado del poro pasa a "poro en secuenciación". Si la porción poros no utilizables se mantiene elevada o aumenta: 1. Es posible realizar un enjuague con nucleasa con el kit Flow Cell Wash (EXP-WSH004), o 2. Realizar varios ciclos de PCR a fin de diluir cualquier contaminante que esté causando problemas. |
Gran proporción de poros inactivos
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| Gran proporción de poros inactivos o no utilizables (se muestran en azul claro en el panel de canales y en el gráfico de actividad. Los poros o membranas han sufrido daños irreversibles) | Se han introducido burbujas de aire en la celda de flujo | Las burbujas de aire introducidas durante el acondicionamiento de la celda y carga de la biblioteca provocan daños permanentes. La forma más eficaz de evitar que esto ocurra se muestra en el vídeo Cómo cargar celdas de flujo PromethION. |
| Gran proporción de poros inactivos o no utilizables | Ciertos compuestos copurificados con ADN | Ciertos compuestos, incluyen polisacáridos. 1. Purificar con el kit PowerClean Pro de QIAGEN. 2. Realizar una amplificación del genoma completo a partir de la muestra original de ADNg con el kit REPLI-g de QIAGEN. |
| Gran proporción de poros inactivos o no utilizables | Hay contaminantes presentes en la muestra | Los efectos de los contaminantes se muestran en el documento técnico Contaminants. Probar con un método de extracción alternativo que no provoque el arrastre de contaminantes. |
Fluctuación de la temperatura
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| Fluctuación de la temperatura | La celda de flujo ha perdido contacto con el dispositivo | Comprobar que una almohadilla térmica cubra la placa metálica de la parte posterior de la celda de flujo. Reinsertar la celda de flujo y presionar hasta que las clavijas del conector estén firmemente en contacto con el dispositivo. Si el problema persiste, contacte con el servicio de Asistencia técnica. |
Error al intentar alcanzar la temperatura deseada
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| MinKNOW muestra el mensaje «Error al intentar alcanzar la temperatura deseada» | El dispositivo se colocó en una ubicación con una temperatura ambiente inferior a la media o con escasa ventilación (lo que provoca el sobrecalientamiento de las celdas de flujo). | MinKNOW establece un tiempo para que la celda de flujo alcance la temperatura fijada. Una vez acabado ese tiempo, aparece un mensaje de error, pero el experimento de secuenciación continúa. Secuenciar a una temperatura incorrecta suele provocar una disminución en el rendimiento y generar índices de calidad Q score menores. Corregir la ubicación del dispositivo, procurando que esté a temperatura ambiente y con buena ventilación; a continuación, reiniciar el experimento en MinKNOW. |
Last updated: 10/28/2026
Opciones de documento